Коммерческие условия Meta (Meta Commercial Terms) меняются 30 октября 2026 года. В новой версии появился пункт, который разрешает Meta запускать краулеры (программы, которые автоматически читают веб-страницы) на сайты, связанные с вашим бизнесом, и возвращаться за обновлениями. Условия распространяются на любое деловое использование продуктов Meta, например Facebook и Instagram, даже если вы только ведете страницу.
По данным PPC Land, если вы продолжаете пользоваться Meta для бизнеса после уведомления Meta об обновлении, это считается согласием с новыми условиями. До 30 октября решите, каким краулерам Meta можно читать ваш сайт, и проверьте, что ваши правила не ломают превью ссылок.
Что меняется в коммерческих условиях Meta 30 октября?
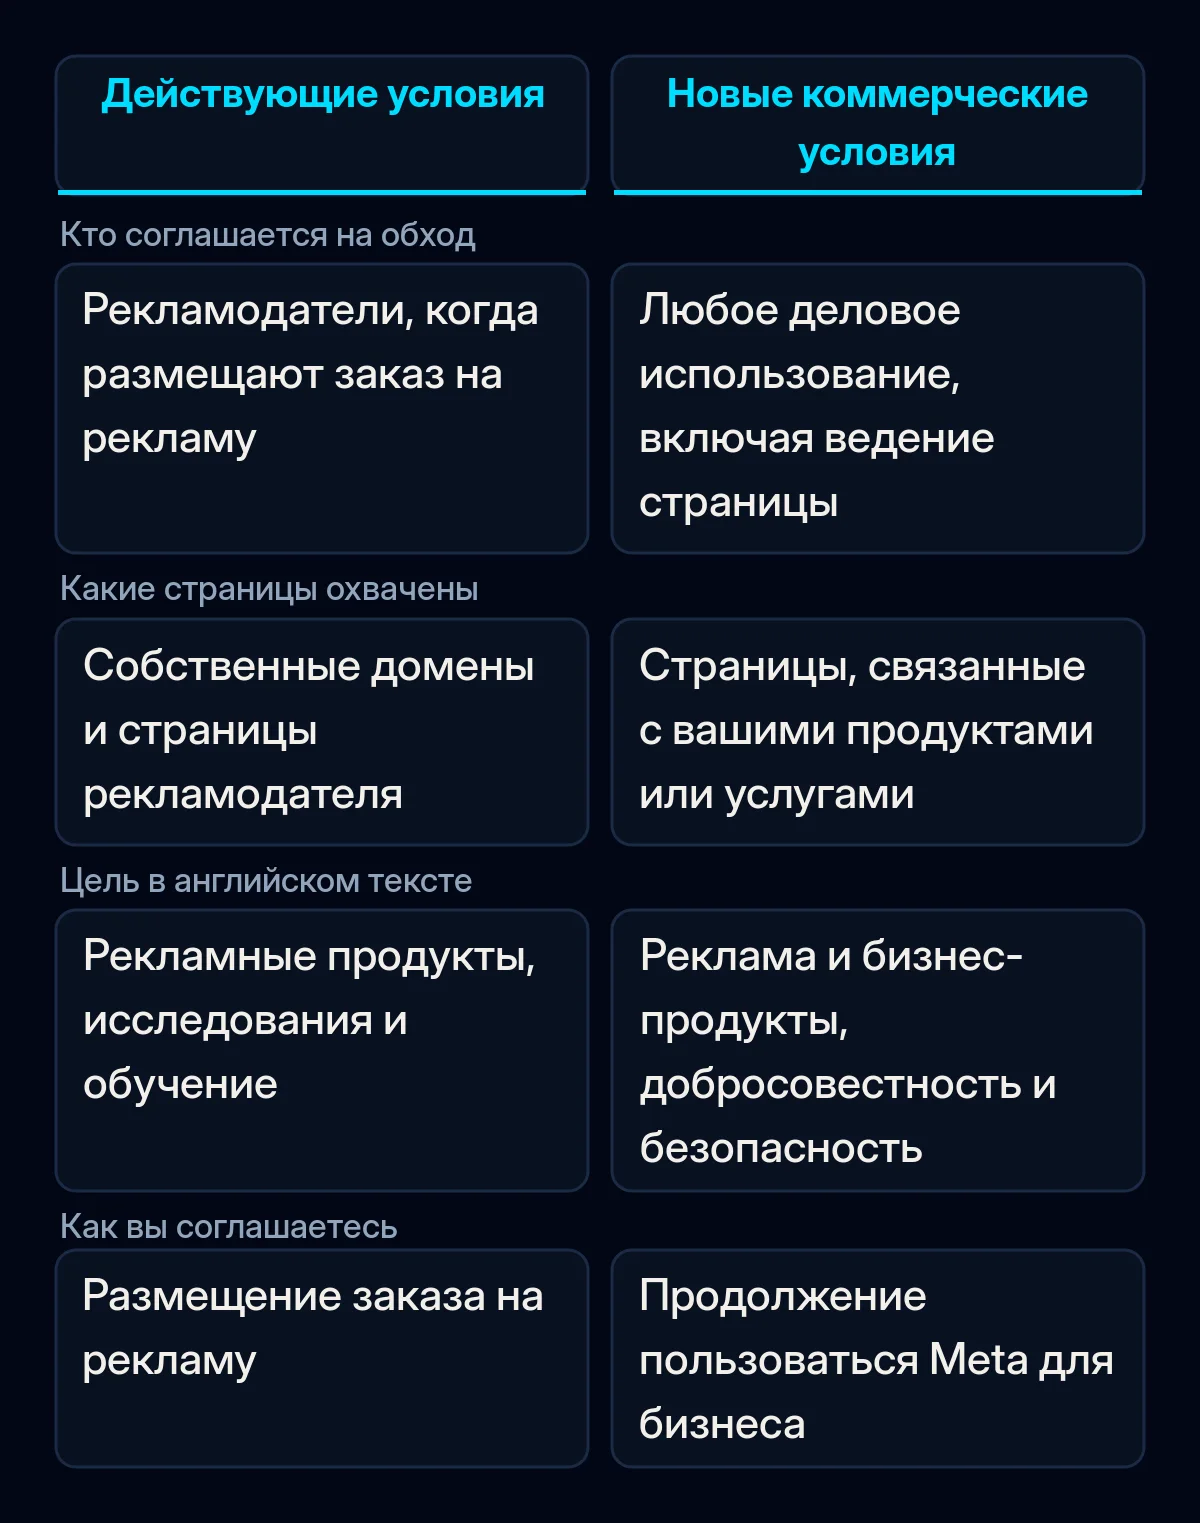
В обновленных Commercial Terms появился пункт об обходе сайтов, которого нет в версии, действующей с 6 марта 2024 года. В предварительной версии новых условий сказано, что вы разрешаете Meta или тем, кто действует от ее имени, использовать “автоматизированное ПО (например, веб-скрейперы, боты, роботы, пауки, краулеры и пользовательские агенты)”. Meta также может “создавать тестовые учетные данные”, то есть логины, которые Meta заводит для себя.
Пункт охватывает домены, веб-страницы и URL, “связанные с вашими продуктами или услугами”, а также URL, которые стали доступны благодаря тому, что вы или другие пользователи пользуетесь продуктами Meta. Meta также может “периодически получать обновления” с них. В английском тексте, который мы прочитали 20 октября, заявленные цели - рекламные и бизнес-продукты, а также “добросовестность и безопасность продуктов компании Meta”.
Условия касаются далеко не только рекламодателей. Среди деловых целей Meta называет “управление страницей”, “создание или использование каталога товаров” и работу в Meta Business Suite.
Нечто похожее рекламодатели уже разрешали. Действующие Self-serve Ad Terms Meta, которые применяются с 22 августа 2025 года, уже дают Meta право обходить домены рекламодателя, в том числе для “исследований и обучения”. В предварительной версии новых рекламных условий тот же пункт сохранился.
Почему Meta поменяла формулировку за неделю?
Первая опубликованная версия новых Commercial Terms заходила дальше. Отдельное предложение гласило, что Meta может использовать контент сайтов, связанных с бизнесом, чтобы “предоставлять, развивать, улучшать, исследовать, обучать и поддерживать добросовестность” своих продуктов. PPC Land процитировал это предложение 16 октября, и издатели и юристы возразили, как сообщил Search Engine Journal.
После этого Meta убрала цель обучения из американского английского текста. Search Engine Journal ссылается на представителя Meta Дэниела Робертса, который сказал The Verge, что новая формулировка уже. По его словам, условия об обходе “касались только наших рекламных и бизнес-продуктов, и мы уточнили это в самих условиях”. Другой представитель Meta, Энди Стоун, сказал, что “в том, как Meta использует веб-краулеры, ничего не меняется”, как цитирует PPC Land.
PPC Land нашел старое предложение в британской английской версии условий 18 октября, а Search Engine Journal 19 октября все еще видел его в британской английской версии рекламных условий. Когда мы читали обе английские версии 20 октября, слова “train” там уже не было. Версии на других языках могут отставать, поэтому проверьте текст на языке своего аккаунта.
Не все считают новую формулировку более узкой. Юрист Мэтт Топик сказал: “Думаю, ‘develop’ достаточно широкое слово, чтобы включать ‘train’”, - пишет Search Engine Journal.
Какие краулеры Meta заходят на ваш сайт?
Meta описывает пять краулеров на странице Meta Web Crawlers. Каждый передает свое имя, так называемый user agent. Файл robots.txt, текстовый файл, который сообщает краулерам, какие страницы им можно читать, может задавать для них разные правила, например разрешить превью ссылок и запретить обучение ИИ.
| Краулер (user agent) | Что он делает, по словам Meta | Пометка Meta |
|---|---|---|
| FacebookExternalHit | Читает страницы, которыми делятся в приложениях Meta, чтобы показать заголовок, описание и картинку | “может обходить robots.txt” для проверок безопасности или добросовестности |
| Meta-ExternalAds | Улучшает рекламу и другие бизнес-продукты | Можно заблокировать в robots.txt |
| Meta-WebIndexer | Улучшает результаты поиска в Meta AI, ИИ-ассистенте Meta | Если его разрешить, это “помогает нам цитировать ваш контент и ссылаться на него” |
| Meta-ExternalAgent | Обучение базовых моделей ИИ или индексация контента для продуктов | Можно заблокировать в robots.txt |
| Meta-ExternalFetcher | Загружает ссылку по запросу пользователя, в том числе когда ИИ-ассистент открывает страницу для него | “может обходить правила robots.txt” |
Чтобы заблокировать один из них, Meta советует “добавить в robots.txt запрет (disallow) для нужного краулера”. Там же предупреждение: краулеры “могут кешировать содержимое robots.txt до 24 часов”, так что изменение может заработать только через сутки.
Возможно, за вас уже решает файрвол или CDN (сеть доставки контента, сервис вроде Cloudflare, который стоит перед вашим сайтом). Cloudflare позволяет сайтам управлять ИИ-краулерами по категориям, и, судя по его журналу изменений, с 15 сентября 2026 года он по умолчанию блокирует категории Training и Agent на страницах с рекламой для новых доменов. В списке ботов Cloudflare есть Meta-ExternalAgent и Meta-ExternalFetcher, но нет Meta-ExternalAds, Meta-WebIndexer и FacebookExternalHit.
Что пока неясно?
В новых коммерческих условиях Meta robots.txt вообще не упоминается. Meta говорит, что владельцы контента могут и дальше выражать свои предпочтения через robots.txt. Search Engine Journal отмечает, что неясно, ограничивает ли правило в robots.txt то, что бизнес разрешает в условиях. Издание также ссылается на профессора права, который объясняет, что соблюдать robots.txt краулеры не обязаны.
Meta не уточнила, какие URL считаются “связанными с вашими продуктами или услугами”. На ее странице о краулерах не сказано, что какой-либо из пяти краулеров собирает данные о товарах для каталогов, и нет списка IP-адресов, по которым можно проверить, что посетитель действительно пришел от Meta.
Что это значит для вашего бизнеса
По нашему мнению, новые условия - хороший повод решить, что каждому краулеру Meta можно делать на вашем сайте. Мы бы шли в таком порядке, до 30 октября, когда новые условия вступают в силу.
- Прочитайте условия, которые показывает вам Meta. Откройте предварительную версию на языке своего аккаунта и найдите абзац об автоматизированном ПО. Если ваш контент и есть ваш продукт, например платные статьи или закрытый раздел для участников, спросите юриста, что этот пункт значит для вас. Мы не юристы и юридических консультаций не даем.
- Откройте свой robots.txt. Перейдите на вашдомен.com/robots.txt и поищите правила с именами краулеров Meta, а также правило, которое блокирует всех ботов. Широкий запрет, оставшийся после разработки, скрывает сайт и от поиска - об этом мы рассказываем в статье почему сайт не появляется в Google.
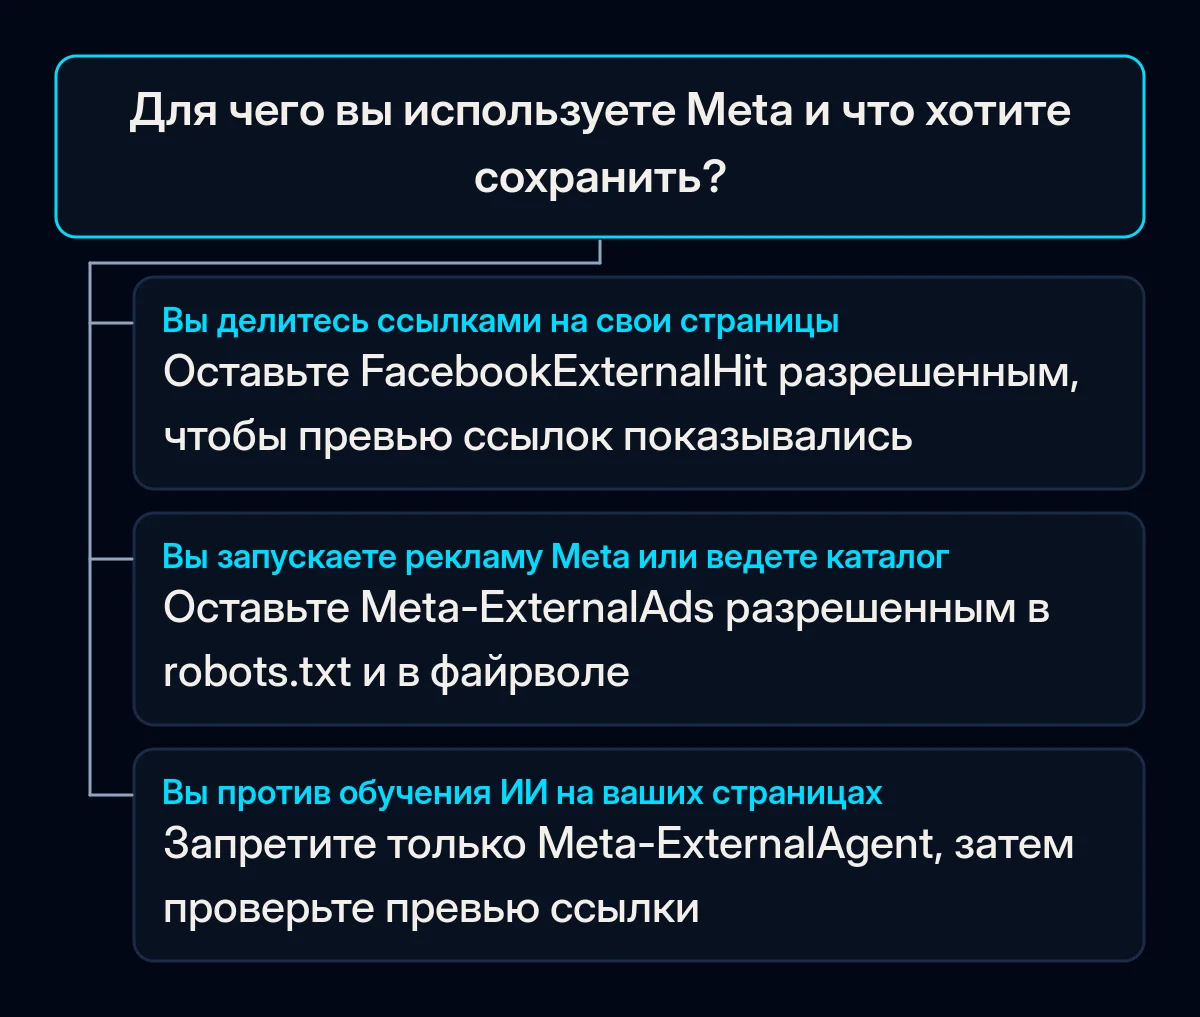
- Решайте по каждому краулеру. Оставьте FacebookExternalHit, если делитесь ссылками на свои страницы. Оставьте Meta-ExternalAds, если запускаете рекламу в Meta или ведете каталог товаров. Разрешите Meta-WebIndexer, если хотите, чтобы Meta AI цитировал ваши страницы. Заблокируйте Meta-ExternalAgent, если не хотите, чтобы ваши страницы шли на обучение ИИ, но помните, что юридическая сила такого правила для условий неясна. По той же логике мы открываем страницы товаров для ИИ-ассистентов вроде ChatGPT.
- Проверьте, что уже блокирует ваш файрвол, плагин безопасности или CDN. Не пропускайте каждого посетителя, у которого в имени есть “facebook”. На собственном сайте мы видели запросы, которые использовали имя краулера Meta, приходили из сетей вне Meta и запрашивали файлы конфигурации. Разбор логов обхода до того, как писать новые правила, входит в нашу работу по техническому SEO.
- После любого изменения проверьте превью ссылки. Подождите сутки, пока обновится кеш robots.txt, затем вставьте адрес страницы в Sharing Debugger от Meta и убедитесь, что заголовок и картинка отображаются. Теги Open Graph, которые и задают этот заголовок и картинку, входят в чек-лист запуска сайтов, по которому мы работаем.
Если за вашим robots.txt никто не следит, начните с шага 2 сегодня. Он покажет, разрешены ли сейчас краулеры Meta, заблокированы или вообще не упомянуты.