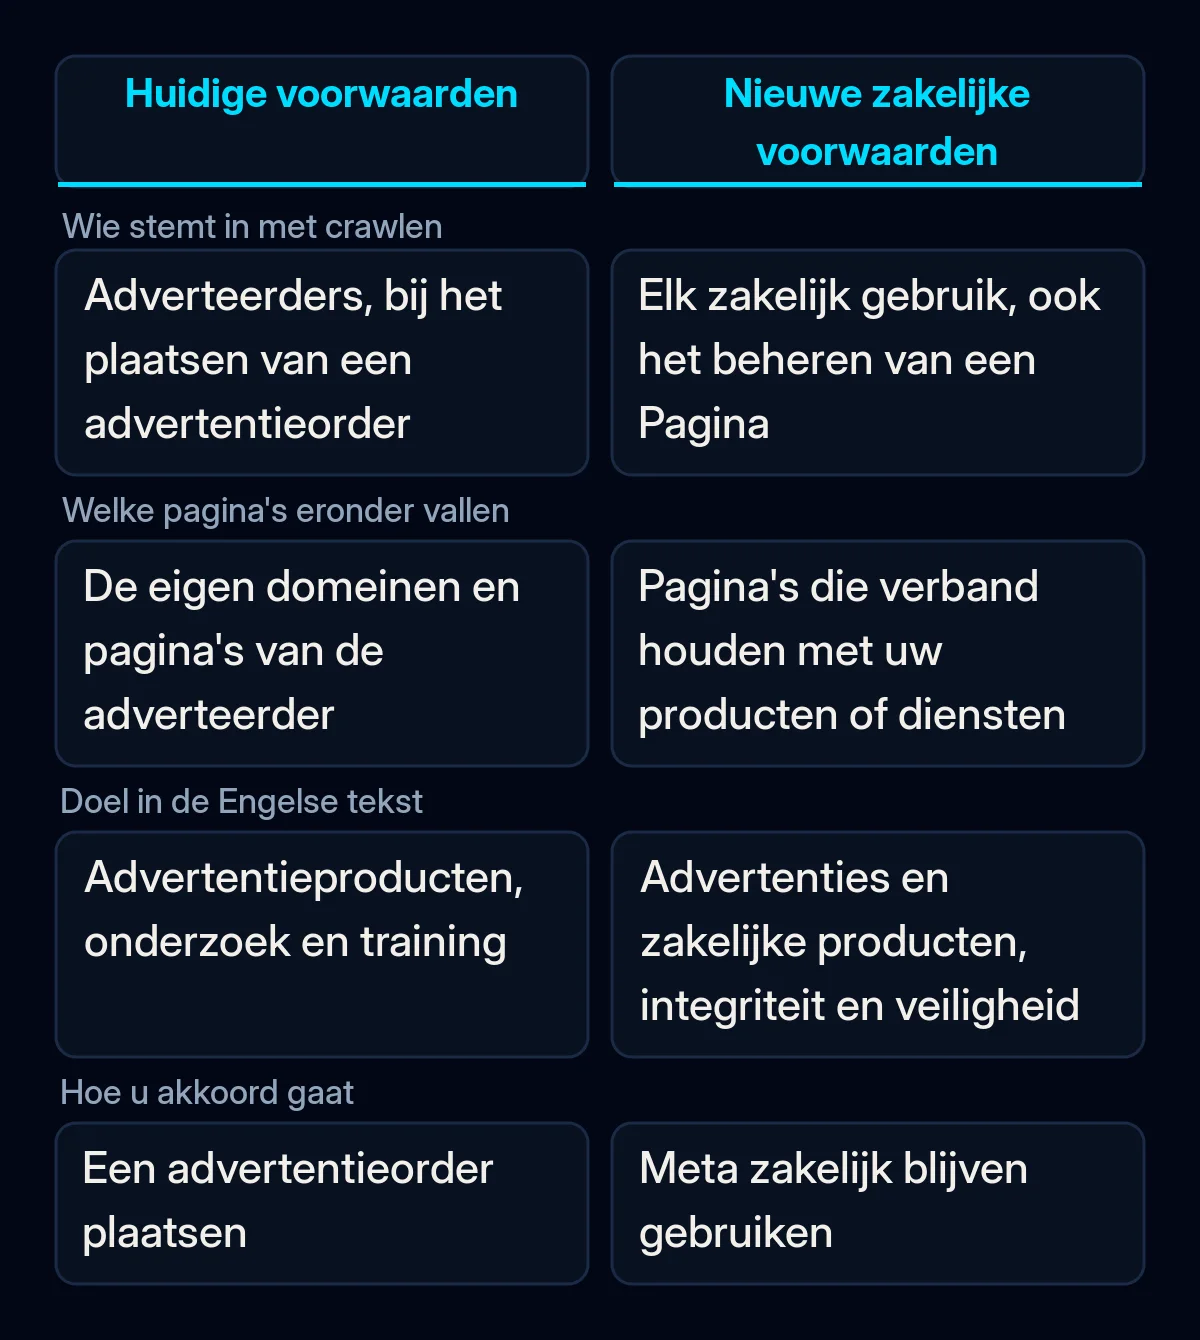
De nieuwe voorwaarden van Meta gaan in op 30 oktober 2026. De nieuwe versie van de zakelijke voorwaarden (Commercial Terms) bevat een clausule waarmee Meta crawlers (programma’s die automatisch webpagina’s lezen) mag inzetten op websites die aan uw bedrijf zijn gekoppeld, en later mag terugkomen voor updates. De voorwaarden gelden voor elk zakelijk gebruik van de producten van Meta, zoals Facebook en Instagram, ook als u alleen een Pagina beheert.
Volgens PPC Land geldt het als acceptatie van de nieuwe voorwaarden als u Meta zakelijk blijft gebruiken nadat Meta de update heeft aangekondigd. Bepaal vóór 30 oktober welke crawlers van Meta uw website mogen lezen, en controleer of uw regels de linkvoorbeelden niet breken.
Wat verandert er op 30 oktober in de nieuwe voorwaarden van Meta?
De bijgewerkte Commercial Terms bevatten een crawlclausule die in de versie die sinds 6 maart 2024 geldt niet voorkomt. In de preview van de nieuwe voorwaarden staat dat u Meta, of iedereen die namens Meta handelt, toestemming geeft om “geautomatiseerde software (zoals webscrapers, bots, robots, spiders, crawlers en user agents)” te gebruiken, in het Engels automated software. Meta mag ook “testinloggegevens aanmaken”, dus inloggegevens die Meta voor zichzelf maakt.
De clausule geldt voor domeinen, webpagina’s en URL’s “die verband houden met uw producten of diensten”, en voor URL’s die beschikbaar komen doordat u of andere gebruikers de producten van Meta gebruiken. Meta mag er ook “periodiek updates ophalen”. In de Engelse tekst die wij op 20 oktober lazen, zijn de genoemde doelen advertentie- en zakelijke producten, en “de integriteit en veiligheid van de producten van Meta-bedrijven”.
De voorwaarden gaan veel verder dan adverteerders. Meta noemt “een Pagina beheren”, “een productcatalogus maken of gebruiken” en het gebruik van Meta Business Suite als zakelijke doeleinden.
Adverteerders gaven al eerder iets vergelijkbaars. De huidige Self-serve Ad Terms van Meta, die sinds 22 augustus 2025 gelden, geven Meta al het recht om de domeinen van een adverteerder te crawlen, ook voor “onderzoek en training”. De preview van de nieuwe advertentievoorwaarden bevat dezelfde clausule.
Waarom paste Meta de tekst binnen een week aan?
De eerste gepubliceerde versie van de nieuwe Commercial Terms ging verder. Een aparte zin zei dat Meta content van websites die aan een bedrijf gekoppeld zijn mag gebruiken “om te leveren, ontwikkelen, verbeteren, onderzoeken, trainen en de integriteit te bewaken van” haar producten. PPC Land citeerde die zin op 16 oktober, en uitgevers en juristen maakten bezwaar, zo meldde Search Engine Journal.
Daarna haalde Meta het trainingsdoel uit de Amerikaans-Engelse tekst. Search Engine Journal citeert Meta-woordvoerder Daniel Roberts, die tegen The Verge zei dat de nieuwe formulering beperkter is. In zijn woorden golden de crawlvoorwaarden “alleen voor onze advertentie- en zakelijke producten, en dat hebben we in de voorwaarden zelf verduidelijkt.” Een andere woordvoerder van Meta, Andy Stone, zei volgens PPC Land: “er verandert niets aan hoe Meta webcrawlers gebruikt”.
PPC Land vond de oude zin op 18 oktober in de Brits-Engelse preview, en Search Engine Journal vond hem op 19 oktober nog in de Brits-Engelse preview van de advertentievoorwaarden. Toen wij op 20 oktober beide Engelse previews lazen, was het woord “train” verdwenen. Versies in andere talen lopen mogelijk nog achter, dus controleer de tekst in de taal van uw account.
Niet iedereen leest de nieuwe formulering als beperkter. Advocaat Matt Topic zei volgens Search Engine Journal: “ik denk dat ‘develop’ breed genoeg is om ‘train’ te omvatten”.
Welke crawlers van Meta bezoeken uw website?
Meta beschrijft vijf crawlers op de pagina Meta Web Crawlers. Elke crawler stuurt zijn eigen naam mee, de user agent. Uw robots.txt-bestand, het tekstbestand dat crawlers vertelt welke pagina’s ze mogen lezen, kan ze verschillend behandelen, bijvoorbeeld door linkvoorbeelden toe te staan en AI-training te blokkeren.
| Crawler (user agent) | Wat Meta zegt dat hij doet | Opmerking van Meta |
|---|---|---|
| FacebookExternalHit | Leest pagina’s die in de apps van Meta worden gedeeld om een titel, beschrijving en afbeelding te tonen | “kan robots.txt omzeilen” bij beveiligings- of integriteitscontroles |
| Meta-ExternalAds | Verbetert advertenties en andere zakelijke producten | Te blokkeren in robots.txt |
| Meta-WebIndexer | Verbetert de zoekresultaten van Meta AI, de AI-assistent van Meta | Toestaan “helpt ons uw content te citeren en ernaar te linken” |
| Meta-ExternalAgent | Training van AI-basismodellen, of content indexeren voor producten | Te blokkeren in robots.txt |
| Meta-ExternalFetcher | Haalt een link op als een gebruiker daarom vraagt, ook als een AI-assistent een pagina voor iemand opent | “kan robots.txt-regels omzeilen” |
Om er een te blokkeren, zegt de pagina van Meta: “voeg in robots.txt een disallow toe voor de betreffende crawler”. Meta waarschuwt ook dat crawlers “de inhoud van robots.txt tot 24 uur in de cache kunnen bewaren”, dus het kan een dag duren voordat een wijziging werkt.
Uw firewall of CDN (content delivery network, een dienst zoals Cloudflare die vóór uw site staat) beslist misschien al voor u. Bij Cloudflare kunnen sites AI-crawlers per categorie beheren, en volgens de changelog blokkeert Cloudflare sinds 15 september 2026 standaard de categorieën Training en Agent op pagina’s met advertenties voor nieuwe domeinen. De botlijst van Cloudflare noemt Meta-ExternalAgent en Meta-ExternalFetcher, maar niet Meta-ExternalAds, Meta-WebIndexer of FacebookExternalHit.
Wat is nog onduidelijk?
De nieuwe voorwaarden van Meta noemen robots.txt helemaal niet. Meta zegt dat eigenaren van content robots.txt kunnen blijven gebruiken om hun voorkeuren aan te geven. Search Engine Journal merkt op dat onduidelijk is of een regel in robots.txt beperkt wat een bedrijf in de voorwaarden toestaat. Het citeert ook een hoogleraar recht die uitlegt dat crawlers robots.txt vrijwillig volgen.
Meta heeft niet gedefinieerd welke URL’s gelden als “verband houdend met uw producten of diensten”. De crawlerpagina van Meta zegt niet dat een van de vijf crawlers productinformatie voor catalogi verzamelt, en noemt geen IP-adressen waarmee u kunt controleren of een bezoeker echt van Meta komt.
Wat het betekent voor uw bedrijf
Volgens ons zijn de nieuwe voorwaarden een goede reden om per crawler van Meta te bepalen wat hij op uw website mag. Wij zouden het in deze volgorde doen, vóór 30 oktober, wanneer de nieuwe voorwaarden ingaan.
- Lees de voorwaarden die Meta u toont. Open de preview in de taal van uw account en zoek de alinea over geautomatiseerde software. Is uw content uw product, bijvoorbeeld betaalde artikelen of een ledenomgeving, vraag dan een jurist wat de clausule voor u betekent. Wij zijn geen juristen en geven geen juridisch advies.
- Open uw robots.txt. Ga naar uwdomein.nl/robots.txt en zoek naar regels die de crawlers van Meta noemen, en naar een regel die alle bots blokkeert. Een brede blokkade die na de ontwikkeling is blijven staan, verbergt uw site ook voor zoekmachines, zoals we uitleggen in een robots.txt-regel die na de ontwikkeling is blijven staan.
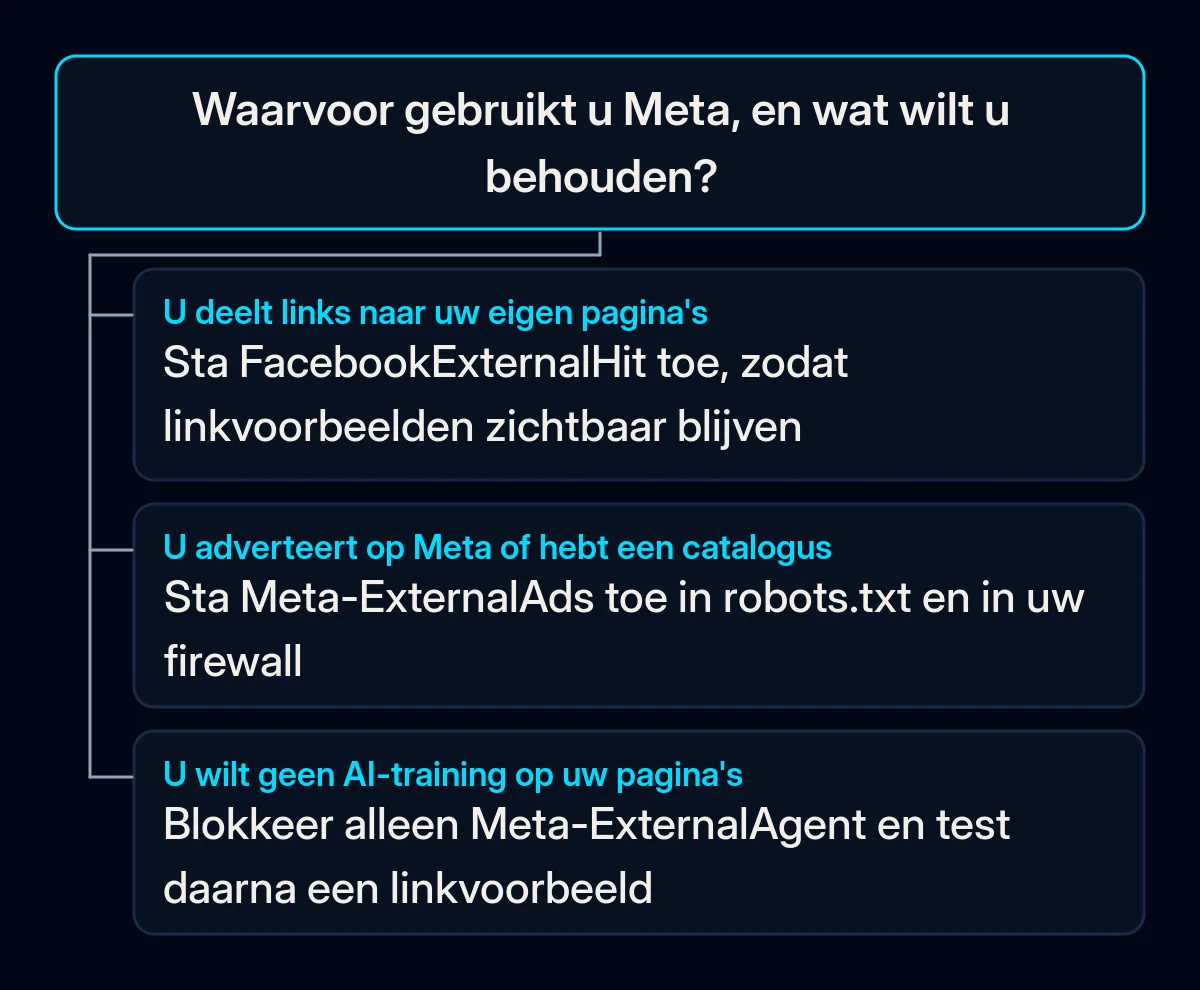
- Beslis per crawler. Houd FacebookExternalHit als u links naar uw pagina’s deelt. Houd Meta-ExternalAds als u op Meta adverteert of een productcatalogus hebt. Sta Meta-WebIndexer toe als u wilt dat Meta AI uw pagina’s citeert. Blokkeer Meta-ExternalAgent als u niet wilt dat uw pagina’s voor AI-training worden gebruikt, en houd er rekening mee dat het juridische effect van zo’n regel op de voorwaarden onduidelijk is. Dezelfde logica gebruiken we als we AI-assistenten uw productpagina’s laten lezen.
- Controleer wat uw firewall, beveiligingsplug-in of CDN al blokkeert. Laat niet elke bezoeker met “facebook” in de naam toe. Op onze eigen website zagen we verzoeken die de naam van een Meta-crawler gebruikten, van netwerken buiten Meta kwamen en om configuratiebestanden vroegen. De crawllogs lezen voordat we nieuwe regels schrijven, hoort bij ons technische SEO-werk.
- Test een linkvoorbeeld na elke wijziging. Wacht een dag vanwege de cache van robots.txt, plak dan een paginaadres in de Sharing Debugger van Meta en controleer of de titel en afbeelding verschijnen. Open Graph-tags, die die titel en afbeelding leveren, staan op de lanceringschecklist voor websiteprojecten waarmee we werken.
Als niemand uw robots.txt beheert, begin dan vandaag met stap 2. Daarmee ziet u of de crawlers van Meta nu zijn toegestaan, geblokkeerd of helemaal niet genoemd.