Nowy regulamin Meta, czyli zaktualizowane Warunki handlowe (Commercial Terms), zaczyna obowiązywać 30 października 2026 r. Nowa wersja dodaje klauzulę, która pozwala Meta używać crawlerów (programów automatycznie czytających strony internetowe) na stronach powiązanych z Twoją firmą i wracać na nie po aktualizacje. Warunki obejmują każde biznesowe korzystanie z produktów Meta, takich jak Facebook i Instagram, nawet jeśli prowadzisz tylko Stronę.
Według PPC Land dalsze korzystanie z Meta w celach biznesowych po powiadomieniu o aktualizacji oznacza akceptację nowych warunków. Przed 30 października zdecyduj, które crawlery Meta mogą czytać Twoją stronę, i sprawdź, czy Twoje reguły nie psują podglądów linków.
Co zmienia nowy regulamin Meta od 30 października?
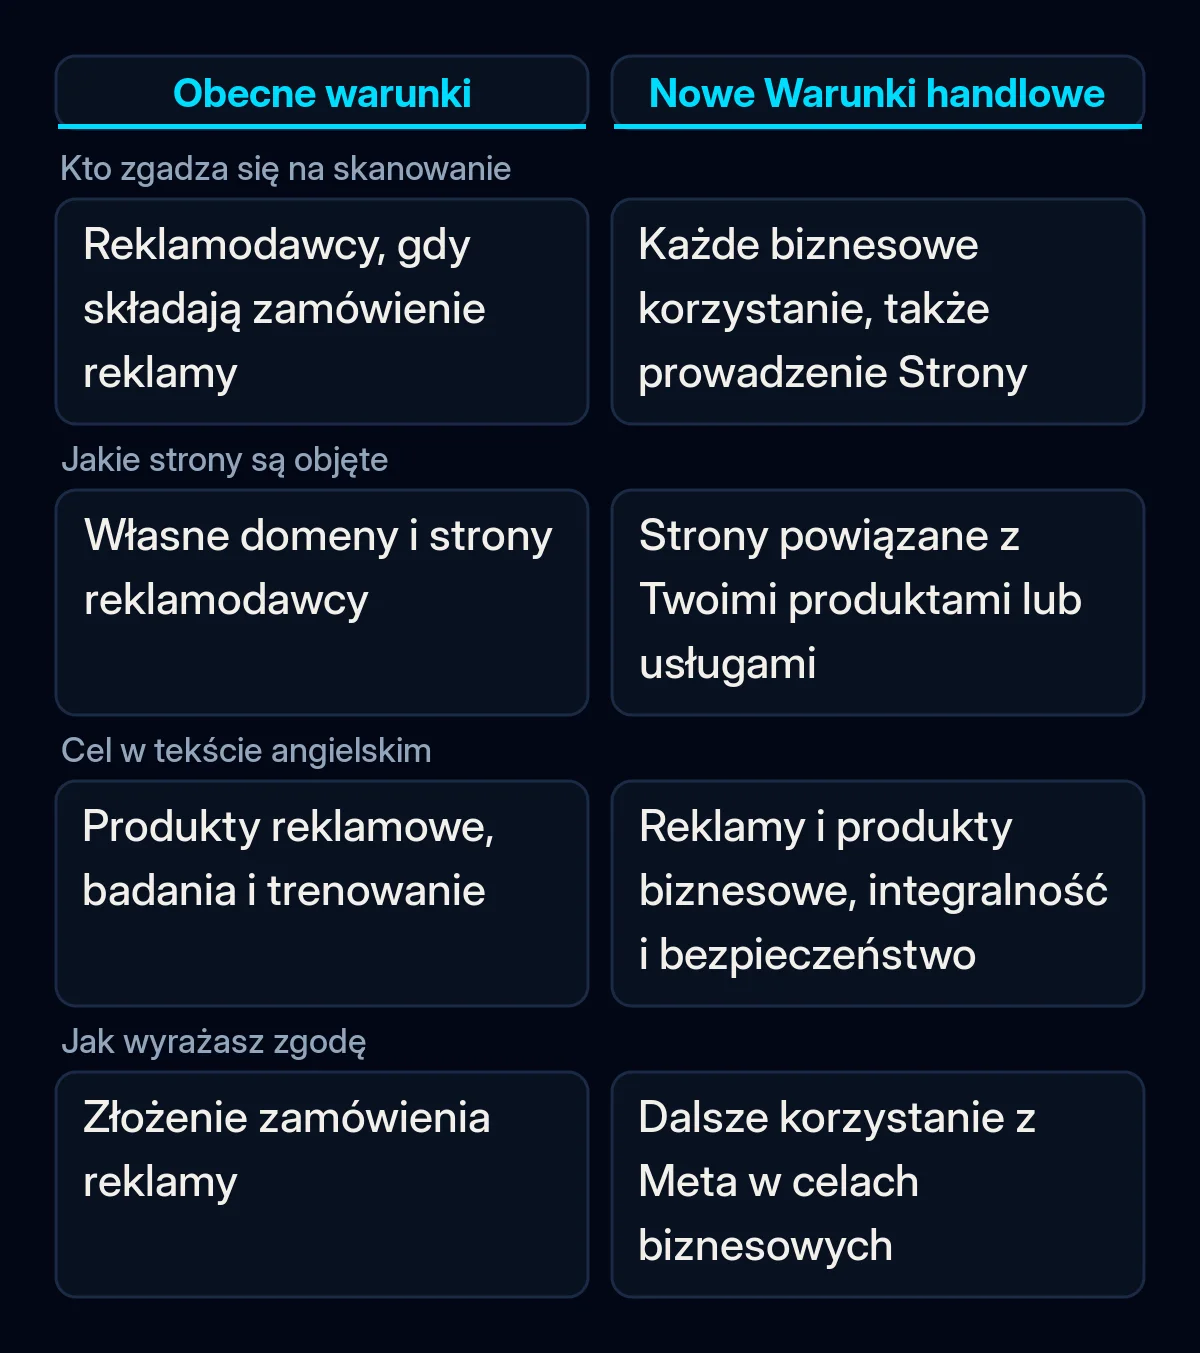
Zaktualizowane Warunki handlowe dodają klauzulę o skanowaniu, której nie ma wersja obowiązująca od 6 marca 2024 r. Podgląd nowych warunków mówi, że upoważniasz Meta lub każdego, kto działa w jej imieniu, do używania “zautomatyzowanego oprogramowania (takiego jak web scrapery, boty, roboty, spidery, crawlery i user agenty)”, po angielsku automated software. Meta może też “tworzyć testowe dane logowania”, czyli dane dostępowe, które Meta tworzy dla siebie.
Klauzula obejmuje domeny, strony internetowe i adresy URL “powiązane z Twoimi produktami lub usługami” oraz adresy URL udostępnione dzięki temu, że Ty lub inni użytkownicy korzystacie z produktów Meta. Meta może też “okresowo pobierać z nich aktualizacje”. W angielskim tekście, który przeczytaliśmy 20 października, wskazane cele to produkty reklamowe i biznesowe oraz “integralność i bezpieczeństwo Produktów Firm Meta”.
Warunki sięgają daleko poza reklamodawców. Meta wymienia wśród celów biznesowych “zarządzanie Stroną”, “tworzenie lub używanie katalogu produktów” oraz korzystanie z Meta Business Suite.
Reklamodawcy udzielali już czegoś podobnego. Obecne Warunki reklam samoobsługowych Meta (Self-serve Ad Terms), obowiązujące od 22 sierpnia 2025 r., już dają Meta prawo do skanowania domen reklamodawcy, także w celu “badań i trenowania”. Podgląd nowych warunków reklamowych zawiera tę samą klauzulę.
Dlaczego Meta zmieniła treść w ciągu tygodnia?
Pierwsza opublikowana wersja nowych Warunków handlowych szła dalej. Osobne zdanie mówiło, że Meta może używać treści ze stron powiązanych z firmą, “aby dostarczać, rozwijać, ulepszać, badać, trenować i utrzymywać integralność” swoich produktów. PPC Land zacytował to zdanie 16 października, a wydawcy i prawnicy zgłosili sprzeciw, jak podał Search Engine Journal.
Następnie Meta usunęła cel trenowania z tekstu w amerykańskiej angielszczyźnie. Search Engine Journal przytacza rzecznika Meta Daniela Robertsa, który powiedział The Verge, że nowe sformułowanie jest węższe. Jak to ujął, warunki dotyczące skanowania “dotyczyły tylko naszych produktów reklamowych i biznesowych, i doprecyzowaliśmy to w samych warunkach”. Inny rzecznik Meta, Andy Stone, powiedział, że “nic się nie zmienia w tym, jak Meta używa crawlerów”, jak cytuje PPC Land.
PPC Land znalazł stare zdanie w brytyjskiej angielskiej wersji podglądu 18 października, a Search Engine Journal wciąż znalazł je 19 października w brytyjskim podglądzie warunków reklamowych. Kiedy 20 października przeczytaliśmy oba angielskie podglądy, słowa “train” już w nich nie było. Wersje w innych językach mogą być opóźnione, więc sprawdź tekst w języku swojego konta.
Nie wszyscy czytają nowe sformułowanie jako węższe. Prawnik Matt Topic powiedział: “uważam, że ‘develop’ jest na tyle szerokie, że obejmuje ‘train’”, według Search Engine Journal.
Które crawlery Meta odwiedzają Twoją stronę?
Meta opisuje pięć crawlerów na stronie Meta Web Crawlers. Każdy przesyła własną nazwę, tzw. user agent. Twój plik robots.txt, czyli plik tekstowy, który mówi crawlerom, jakie strony mogą czytać, może traktować je różnie, na przykład dopuszczać podglądy linków i blokować trenowanie AI.
| Crawler (user agent) | Co według Meta robi | Uwaga Meta |
|---|---|---|
| FacebookExternalHit | Czyta strony udostępniane w aplikacjach Meta, aby pokazać tytuł, opis i obraz | “może pomijać robots.txt” przy kontrolach bezpieczeństwa lub integralności |
| Meta-ExternalAds | Ulepsza reklamy i inne produkty biznesowe | Można go zablokować w robots.txt |
| Meta-WebIndexer | Ulepsza wyniki wyszukiwania Meta AI, asystenta AI firmy Meta | Dopuszczenie go “pomaga nam cytować Twoje treści i do nich linkować” |
| Meta-ExternalAgent | Trenowanie bazowych modeli AI lub indeksowanie treści dla produktów | Można go zablokować w robots.txt |
| Meta-ExternalFetcher | Pobiera link na prośbę użytkownika, także gdy asystent AI otwiera stronę w jego imieniu | “może pomijać reguły robots.txt” |
Aby zablokować jeden z nich, strona Meta zaleca “dodać w robots.txt regułę disallow dla danego crawlera”. Ostrzega też, że crawlery “mogą przechowywać zawartość robots.txt w pamięci podręcznej do 24 godzin”, więc zmiana może zacząć działać dopiero po dobie.
Twój firewall lub CDN (content delivery network, usługa taka jak Cloudflare, która stoi przed Twoją stroną) może już decydować za Ciebie. Cloudflare pozwala stronom zarządzać crawlerami AI według kategorii, a jego changelog podaje, że od 15 września 2026 r. domyślnie blokuje kategorie Training i Agent na stronach z reklamami w nowych domenach. Lista botów Cloudflare wymienia Meta-ExternalAgent i Meta-ExternalFetcher, ale nie Meta-ExternalAds, Meta-WebIndexer ani FacebookExternalHit.
Co wciąż jest niejasne?
Nowe warunki Meta w ogóle nie wspominają o robots.txt. Meta mówi, że właściciele treści mogą nadal używać robots.txt, aby wyrazić swoje preferencje. Search Engine Journal zauważa, że nie wiadomo, czy reguła w robots.txt ogranicza to, na co firma zgadza się w warunkach. Przytacza też profesora prawa, który wyjaśnia, że przestrzeganie robots.txt jest dla crawlerów dobrowolne.
Meta nie określiła, które adresy URL uznaje za “powiązane z Twoimi produktami lub usługami”. Jej strona o crawlerach nie mówi, że któryś z pięciu crawlerów zbiera informacje o produktach do katalogów, i nie podaje adresów IP, po których można sprawdzić, czy odwiedzający naprawdę pochodzi od Meta.
Co to oznacza dla Twojej firmy
Naszym zdaniem nowe warunki to dobry powód, by zdecydować, co każdy crawler Meta może robić na Twojej stronie. My zrobilibyśmy to w tej kolejności, przed 30 października, kiedy nowe warunki zaczną obowiązywać.
- Przeczytaj warunki, które pokazuje Ci Meta. Otwórz podgląd w języku swojego konta i znajdź akapit o zautomatyzowanym oprogramowaniu. Jeśli Twoje treści są Twoim produktem, na przykład płatne artykuły albo strefa dla członków, zapytaj prawnika, co klauzula oznacza dla Ciebie. Nie jesteśmy prawnikami i nie udzielamy porad prawnych.
- Otwórz swój robots.txt. Wejdź na twojadomena.pl/robots.txt i poszukaj reguł, które wymieniają crawlery Meta, oraz reguły blokującej wszystkie boty. Szeroka blokada pozostawiona po pracach nad stroną ukrywa ją też przed wyszukiwarkami, jak wyjaśniamy w tekście o regule robots.txt, która została po pracach nad stroną.
- Decyduj crawler po crawlerze. Zostaw FacebookExternalHit, jeśli udostępniasz linki do swoich stron. Zostaw Meta-ExternalAds, jeśli prowadzisz reklamy w Meta albo masz katalog produktów. Dopuść Meta-WebIndexer, jeśli chcesz, by Meta AI cytowała Twoje strony. Zablokuj Meta-ExternalAgent, jeśli nie chcesz, by Twoje strony służyły do trenowania AI, pamiętając, że skutek prawny takiej reguły dla warunków jest niejasny. Tę samą logikę stosujemy, gdy pozwalamy asystentom AI czytać strony produktów.
- Sprawdź, co już blokuje Twój firewall, wtyczka bezpieczeństwa lub CDN. Nie wpuszczaj każdego odwiedzającego, który ma “facebook” w nazwie. Na własnej stronie widzieliśmy żądania, które używały nazwy crawlera Meta, przychodziły z sieci spoza Meta i prosiły o pliki konfiguracyjne. Czytanie logów crawlerów przed napisaniem nowych reguł to część naszego technicznego SEO.
- Po każdej zmianie przetestuj podgląd linku. Odczekaj dobę na pamięć podręczną robots.txt, potem wklej adres strony do Sharing Debugger Meta i sprawdź, czy pojawiają się tytuł i obraz. Tagi Open Graph, które dostarczają ten tytuł i obraz, są na liście kontrolnej przed startem strony internetowej, według której pracujemy.
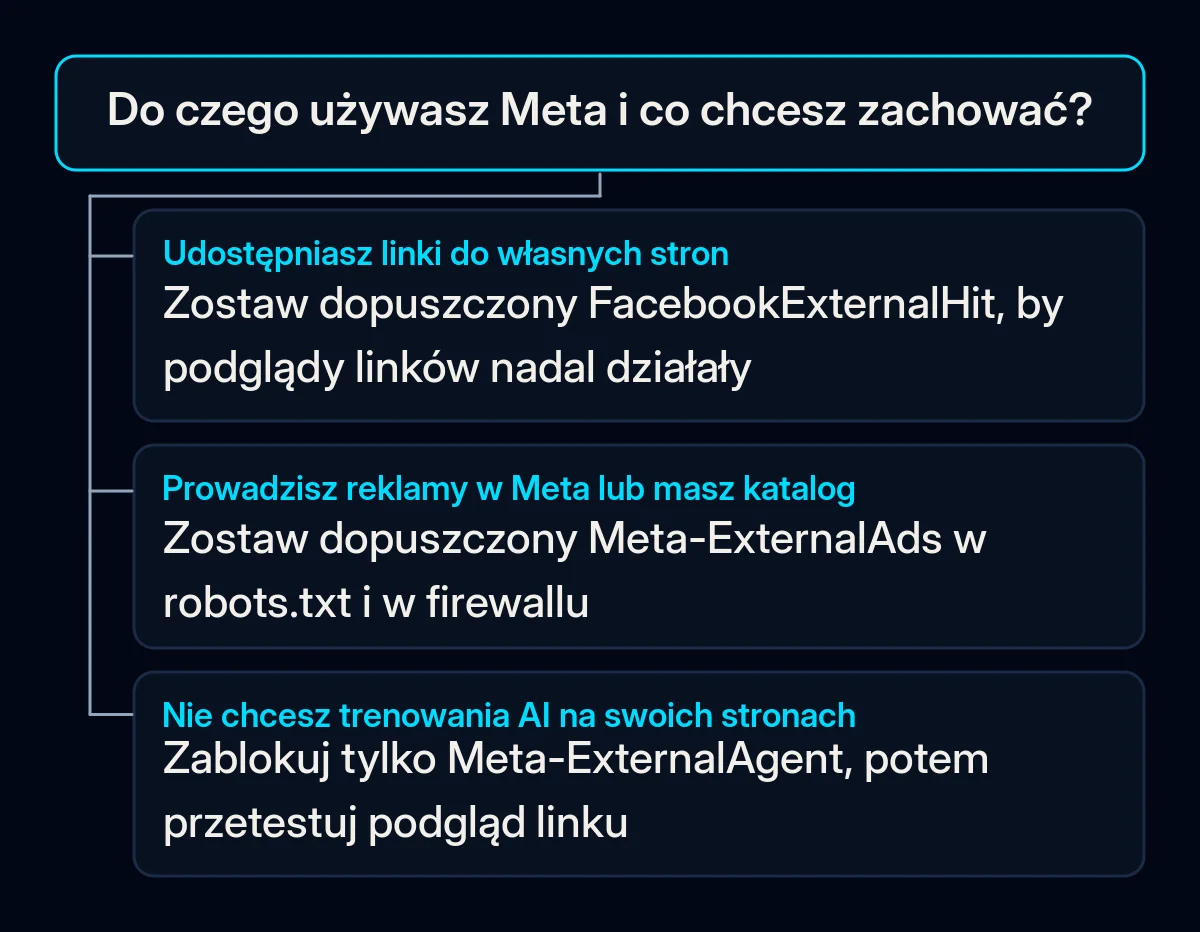
Jeśli nikt nie zajmuje się Twoim robots.txt, zacznij dziś od kroku 2. Pokaże Ci, czy crawlery Meta są obecnie dopuszczone, zablokowane, czy w ogóle niewymienione.