Meta ticari koşulları 30 Ekim 2026’da değişiyor. Yeni sürüm, Meta’nın işletmenizle bağlantılı web sitelerinde tarayıcılar (web sayfalarını otomatik olarak okuyan programlar) kullanmasına ve güncellemeler için geri gelmesine izin veren bir madde ekliyor. Koşullar, yalnızca bir Sayfa yönetiyor olsanız bile Facebook ve Instagram gibi Meta ürünlerinin her türlü ticari kullanımını kapsıyor.
PPC Land’e göre Meta’nın güncelleme bildiriminden sonra Meta’yı işletmeniz için kullanmaya devam etmek, yeni koşulları kabul etmek sayılıyor. 30 Ekim’den önce Meta’nın hangi tarayıcılarının sitenizi okuyabileceğine karar verin ve kurallarınızın bağlantı önizlemelerini bozmadığını kontrol edin.
Meta ticari koşulları 30 Ekim’de nasıl değişiyor?
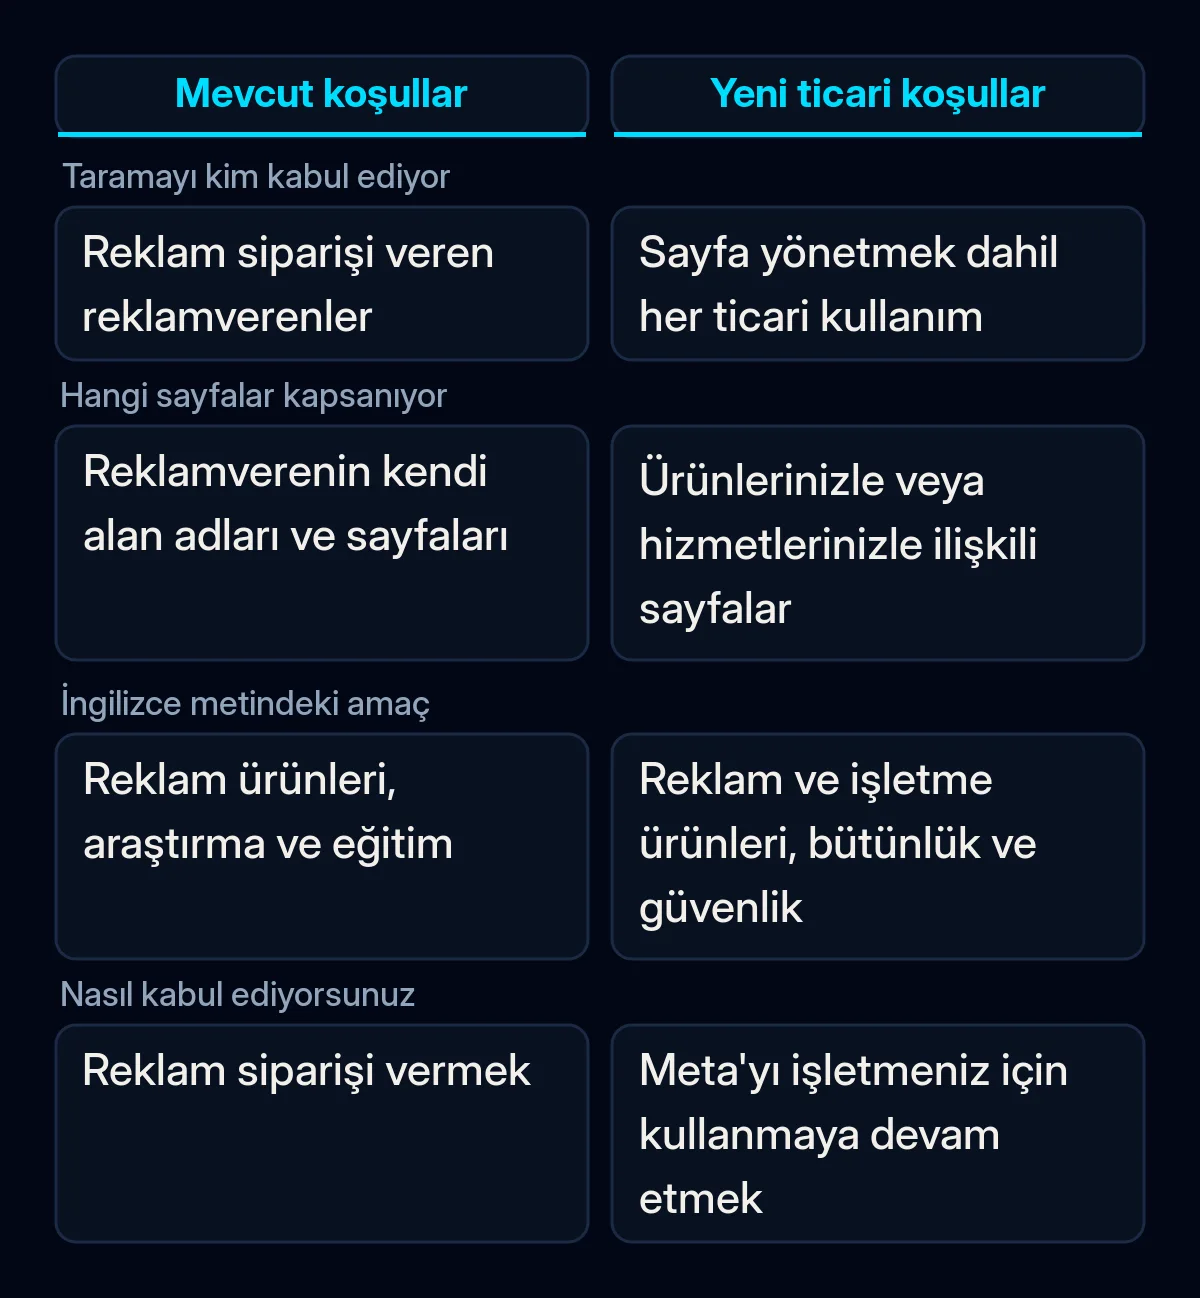
Güncellenen Ticari Koşullar, 6 Mart 2024’ten beri yürürlükte olan sürümde bulunmayan bir tarama maddesi ekliyor. Yeni koşulların önizlemesi, Meta’ya veya onun adına hareket eden herkese “otomatik yazılım (web kazıyıcılar, botlar, robotlar, örümcekler, tarayıcılar ve kullanıcı aracıları gibi)” (automated software) kullanma yetkisi verdiğinizi söylüyor (çeviri bize ait). Meta ayrıca “test kimlik bilgileri oluşturabilir”, yani kendisi için giriş bilgileri yaratabilir.
Madde, “ürünlerinizle veya hizmetlerinizle ilişkili” alan adlarını, web sayfalarını ve URL’leri, ayrıca sizin ya da diğer kullanıcıların Meta ürünlerini kullanmasıyla erişilebilir hale gelen URL’leri kapsıyor. Meta bunlardan “düzenli aralıklarla güncellemeleri çekebilir”. 20 Ekim’de okuduğumuz İngilizce metinde belirtilen amaçlar, reklam ve işletme ürünleri ile “Meta Company Ürünlerinin bütünlüğü ve güvenliği”.
Koşullar reklamverenlerin çok ötesine uzanıyor. Meta, ticari amaçlar arasında “bir Sayfayı yönetmeyi”, “ürün kataloğu oluşturmayı veya kullanmayı” ve Meta Business Suite kullanmayı sayıyor.
Reklamverenler benzer bir izni daha önce de vermişti. Meta’nın 22 Ağustos 2025’ten beri yürürlükte olan Self-Servis Reklam Koşulları (Self-serve Ad Terms), Meta’ya bir reklamverenin alan adlarını, “araştırma ve eğitim” dahil, tarama hakkını zaten veriyor. Yeni reklam koşullarının önizlemesi de aynı maddeyi içeriyor.
Meta ifadeyi neden bir hafta içinde değiştirdi?
Yeni Ticari Koşulların ilk yayımlanan sürümü daha ileri gidiyordu. Ayrı bir cümle, Meta’nın bir işletmeyle bağlantılı sitelerdeki içeriği ürünlerini “sağlamak, geliştirmek, iyileştirmek, araştırmak, eğitmek ve bütünlüğünü korumak” için kullanabileceğini söylüyordu. PPC Land bu cümleyi 16 Ekim’de aktardı; Search Engine Journal’ın haberine göre yayıncılar ve avukatlar itiraz etti.
Bunun üzerine Meta, eğitim amacını ABD İngilizcesi metinden çıkardı. Search Engine Journal, The Verge’e yeni ifadenin daha dar olduğunu söyleyen Meta sözcüsü Daniel Roberts’ı aktarıyor. Roberts’ın sözleriyle tarama koşulları “yalnızca reklam ve işletme ürünlerimiz için geçerliydi ve bunu koşulların içinde netleştirdik”. PPC Land’in aktardığına göre bir başka Meta sözcüsü Andy Stone, “Meta’nın web tarayıcılarını kullanma biçiminde bir değişiklik yok” dedi.
PPC Land eski cümleyi 18 Ekim’de İngiltere İngilizcesi önizlemede buldu, Search Engine Journal ise 19 Ekim’de İngiltere İngilizcesi reklam koşulları önizlemesinde hâlâ görüyordu. 20 Ekim’de iki İngilizce önizlemeyi de okuduğumuzda “train” kelimesi yoktu. Diğer dil sürümleri hâlâ geride olabilir, bu yüzden metni hesabınızın dilinde kontrol edin.
Herkes yeni ifadeyi daha dar okumuyor. Search Engine Journal’a göre avukat Matt Topic, “Bence ‘develop’, ‘train’i de kapsayacak kadar geniş” dedi.
Sitenizi hangi Meta tarayıcıları ziyaret ediyor?
Meta, Meta Web Crawlers sayfasında beş tarayıcıyı tanımlıyor. Her biri kullanıcı aracısı (user agent) denen kendi adını gönderiyor. Tarayıcılara hangi sayfaları okuyabileceklerini söyleyen metin dosyası robots.txt, bunlara farklı davranabilir; örneğin bağlantı önizlemelerine izin verip yapay zekâ eğitimini engelleyebilir.
| Tarayıcı (user agent) | Meta’ya göre ne yapıyor | Meta’nın notu |
|---|---|---|
| FacebookExternalHit | Başlık, açıklama ve görsel göstermek için Meta uygulamalarında paylaşılan sayfaları okur | Güvenlik veya bütünlük kontrolleri için “robots.txt’yi atlayabilir” |
| Meta-ExternalAds | Reklam ve diğer işletme ürünlerini iyileştirir | robots.txt’de engellenebilir |
| Meta-WebIndexer | Meta’nın yapay zekâ asistanı Meta AI’ın arama sonuçlarını iyileştirir | İzin vermek “içeriğinize atıf yapmamıza ve bağlantı vermemize yardımcı olur” |
| Meta-ExternalAgent | Temel yapay zekâ modellerinin eğitimi veya ürünler için içerik dizinleme | robots.txt’de engellenebilir |
| Meta-ExternalFetcher | Bir kullanıcı istediğinde bağlantıyı getirir, bir yapay zekâ asistanının kullanıcı için sayfa açması dahil | “robots.txt kurallarını atlayabilir” |
Meta’nın sayfası, bunlardan birini engellemek için “ilgili tarayıcı için robots.txt’ye bir disallow ekleyin” diyor. Tarayıcıların “robots.txt içeriğini 24 saate kadar önbellekte tutabileceği” uyarısını da yapıyor; yani bir değişikliğin işlemesi bir gün sürebilir.
Güvenlik duvarınız veya CDN’iniz (content delivery network, sitenizin önünde duran Cloudflare gibi bir hizmet) bu kararı zaten sizin yerinize veriyor olabilir. Cloudflare, sitelerin yapay zekâ tarayıcılarını kategoriye göre yönetmesine izin veriyor; değişiklik günlüğüne göre 15 Eylül 2026’dan beri yeni alan adlarında reklam içeren sayfalarda Training ve Agent kategorilerini varsayılan olarak engelliyor. Cloudflare’in bot listesinde Meta-ExternalAgent ve Meta-ExternalFetcher var, ancak Meta-ExternalAds, Meta-WebIndexer ve FacebookExternalHit yok.
Neler hâlâ belirsiz?
Yeni Meta ticari koşulları robots.txt’den hiç söz etmiyor. Meta, içerik sahiplerinin tercihlerini belirtmek için robots.txt’yi kullanmaya devam edebileceğini söylüyor. Search Engine Journal, bir robots.txt kuralının işletmenin koşullarla verdiği izni sınırlayıp sınırlamadığının belli olmadığını belirtiyor. Ayrıca robots.txt’ye uymanın tarayıcılar için gönüllü olduğunu açıklayan bir hukuk profesörünü aktarıyor.
Meta, hangi URL’lerin “ürünlerinizle veya hizmetlerinizle ilişkili” sayıldığını tanımlamadı. Tarayıcı sayfası, beş tarayıcıdan herhangi birinin kataloglar için ürün bilgisi topladığını söylemiyor ve bir ziyaretçinin gerçekten Meta’dan geldiğini doğrulamak için IP adresi listelemiyor.
İşletmeniz için ne anlama geliyor?
Bize göre yeni koşullar, her Meta tarayıcısının sitenizde neler yapabileceğine karar vermek için iyi bir neden. Biz bunu, yeni koşulların yürürlüğe gireceği 30 Ekim’den önce şu sırayla yapardık.
- Meta’nın size gösterdiği koşulları okuyun. Önizlemeyi hesabınızın dilinde açın ve otomatik yazılımla ilgili paragrafı bulun. Ürününüz içeriğinizse, örneğin ücretli makaleler veya üyelere özel bir alan, maddenin sizin için ne anlama geldiğini bir avukata sorun. Biz avukat değiliz ve hukuki danışmanlık vermiyoruz.
- robots.txt dosyanızı açın. alanadiniz.com.tr/robots.txt adresine gidin ve Meta tarayıcılarının adını geçiren kurallara, ayrıca tüm botları engelleyen bir kurala bakın. Geliştirme aşamasından kalan geniş bir engel, sitenizi aramadan da gizler; bunu geliştirmeden kalan bir robots.txt kuralı yazımızda anlatıyoruz.
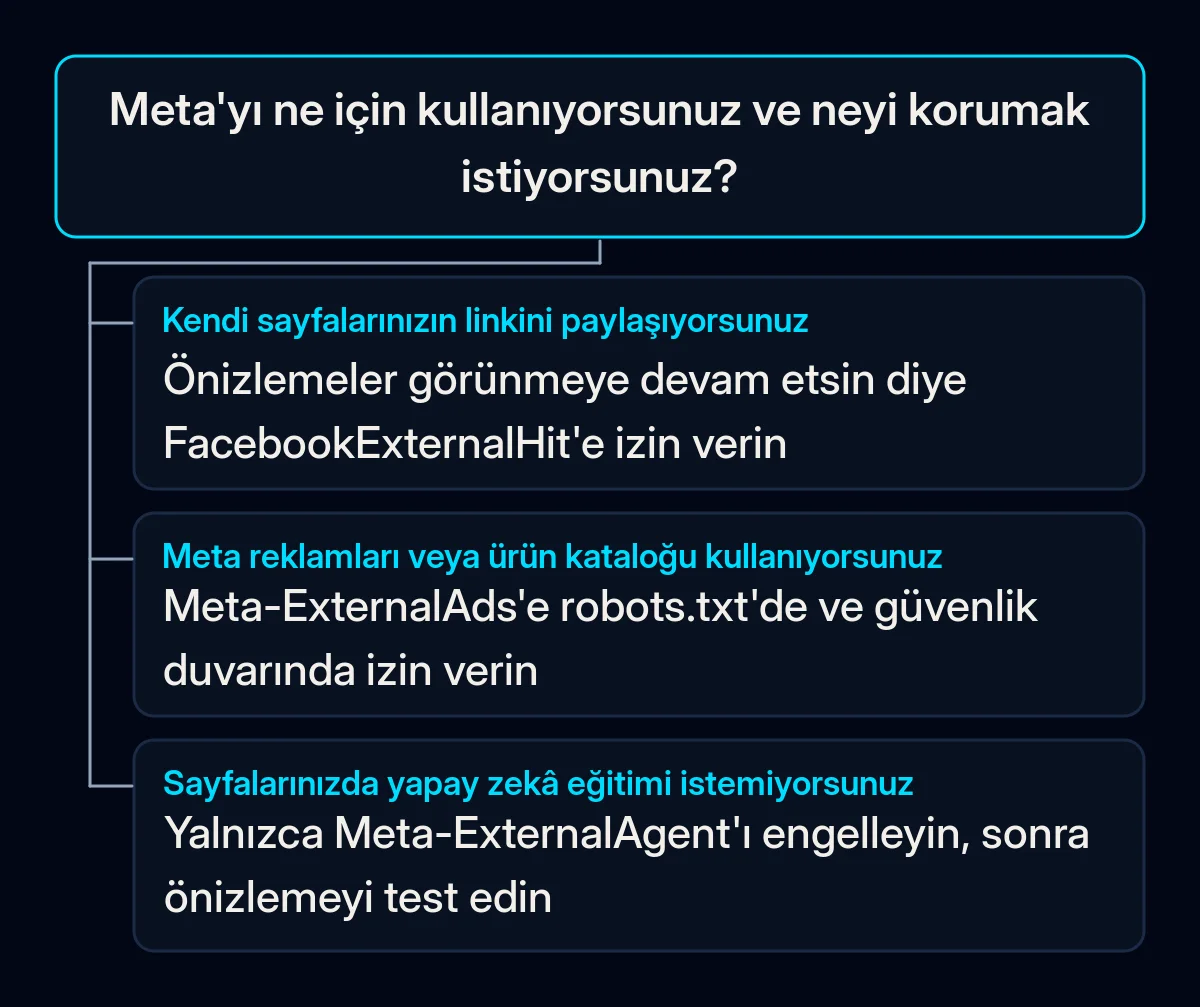
- Her tarayıcı için ayrı karar verin. Sayfalarınızın bağlantılarını paylaşıyorsanız FacebookExternalHit’i tutun. Meta reklamları veya ürün kataloğu kullanıyorsanız Meta-ExternalAds’i tutun. Meta AI’ın sayfalarınıza atıf yapmasını istiyorsanız Meta-WebIndexer’a izin verin. Sayfalarınızın yapay zekâ eğitiminde kullanılmasını istemiyorsanız Meta-ExternalAgent’ı engelleyin; böyle bir kuralın koşullar üzerindeki hukuki etkisinin belirsiz olduğunu unutmayın. Yapay zekâ asistanlarının ürün sayfalarınızı okumasına izin verirken de aynı mantığı kullanıyoruz.
- Güvenlik duvarınızın, güvenlik eklentinizin veya CDN’inizin şu anda neyi engellediğini kontrol edin. Adında “facebook” geçen her ziyaretçiye izin vermeyin. Kendi sitemizde bir Meta tarayıcısının adını kullanan, Meta dışındaki ağlardan gelen ve yapılandırma dosyaları isteyen istekler gördük. Yeni kurallar yazmadan önce tarama günlüklerini okumak, teknik SEO çalışmamızın bir parçası.
- Her değişiklikten sonra bir bağlantı önizlemesini test edin. robots.txt önbelleği için bir gün bekleyin, ardından bir sayfa adresini Meta’nın Sharing Debugger aracına yapıştırın ve başlık ile görselin göründüğünü kontrol edin. Bu başlığı ve görseli sağlayan Open Graph etiketleri, uyguladığımız web sitesi projelerinin yayına alma kontrol listesinde yer alıyor.
robots.txt dosyanızla kimse ilgilenmiyorsa, bugün 2. adımla başlayın. Bu adım, Meta tarayıcılarına şu anda izin verildiğini, engellendiğini ya da hiç anılmadıklarını gösterir.