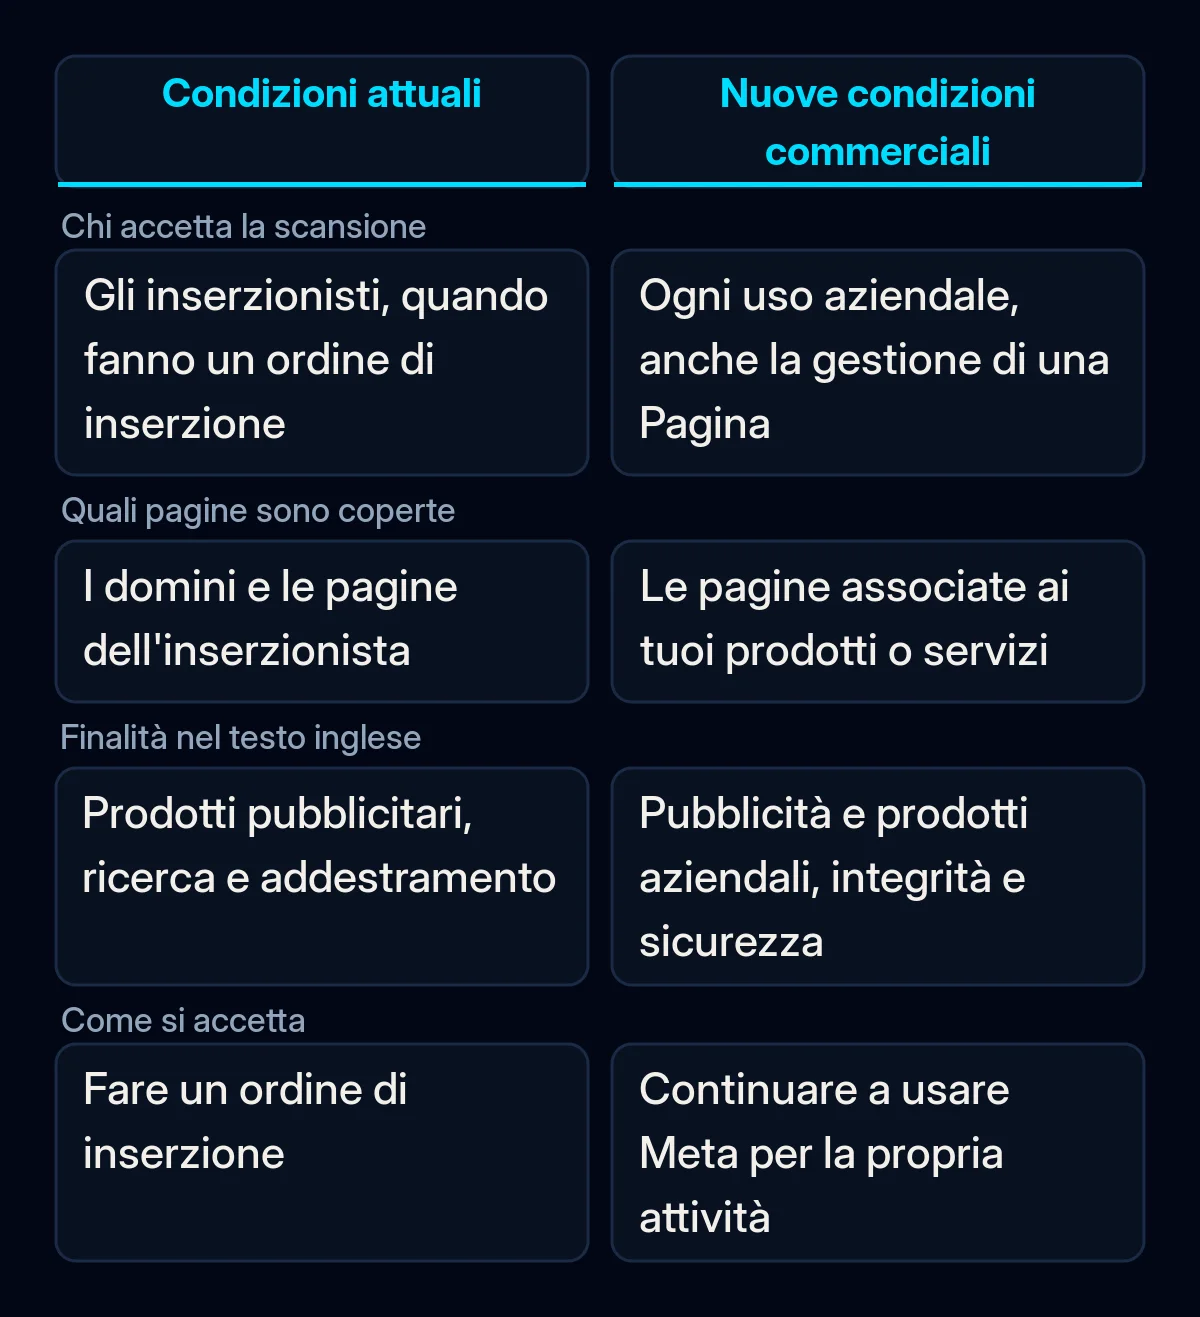
Le condizioni commerciali di Meta (Commercial Terms) cambiano il 30 ottobre 2026. La nuova versione aggiunge una clausola che consente a Meta di usare crawler (programmi che leggono automaticamente le pagine web) sui siti collegati alla tua attività e di tornarci per gli aggiornamenti. Le condizioni valgono per qualsiasi uso aziendale dei prodotti Meta, come Facebook e Instagram, anche se gestisci soltanto una Pagina.
Secondo PPC Land, continuare a usare Meta per la tua attività dopo l’avviso di Meta sull’aggiornamento equivale ad accettare le nuove condizioni. Prima del 30 ottobre decidi quali crawler di Meta possono leggere il tuo sito e verifica che le tue regole non blocchino le anteprime dei link.
Cosa cambia nelle condizioni commerciali di Meta il 30 ottobre?
Le Condizioni commerciali aggiornate aggiungono una clausola sulla scansione che la versione in vigore dal 6 marzo 2024 non contiene. L’anteprima delle nuove condizioni dice che autorizzi Meta, o chiunque agisca per suo conto, a usare “software automatizzati (come web scraper, bot, robot, spider, crawler e user agent)”, in inglese automated software. Meta può anche “creare credenziali di prova”, cioè dati di accesso che Meta crea per sé.
La clausola riguarda i domini, le pagine web e gli URL “associati ai tuoi prodotti o servizi”, oltre agli URL resi disponibili tramite l’uso dei prodotti Meta da parte tua o di altri utenti. Meta può anche “acquisire periodicamente aggiornamenti” da queste fonti. Nel testo inglese che abbiamo letto il 20 ottobre, le finalità indicate sono i prodotti pubblicitari e aziendali e “l’integrità e la sicurezza dei Prodotti delle Aziende di Meta”.
Le condizioni vanno ben oltre gli inserzionisti. Tra le finalità aziendali Meta elenca “gestire una Pagina”, “creare o usare un catalogo prodotti” e l’uso di Meta Business Suite.
Gli inserzionisti hanno già concesso qualcosa di simile. Le attuali Condizioni per le inserzioni self-service di Meta, in vigore dal 22 agosto 2025, danno già a Meta il diritto di scansionare i domini di un inserzionista, anche per “ricerca e addestramento”. L’anteprima delle nuove condizioni pubblicitarie contiene la stessa clausola.
Perché Meta ha cambiato il testo nel giro di una settimana?
La prima versione pubblicata delle nuove Condizioni commerciali andava oltre. Una frase separata diceva che Meta può usare i contenuti dei siti collegati a un’attività “per fornire, sviluppare, migliorare, fare ricerca, addestrare e mantenere l’integrità” dei suoi prodotti. PPC Land ha citato quella frase il 16 ottobre, ed editori e avvocati hanno protestato, come ha riportato Search Engine Journal.
Meta ha poi tolto la finalità di addestramento dal testo in inglese americano. Search Engine Journal cita il portavoce di Meta Daniel Roberts, che ha detto a The Verge che la nuova formulazione è più ristretta. Secondo le sue parole, le condizioni sulla scansione “si applicavano solo ai nostri prodotti pubblicitari e aziendali, e lo abbiamo chiarito nelle condizioni stesse”. Un altro portavoce di Meta, Andy Stone, ha detto che “non cambia nulla nel modo in cui Meta usa i web crawler”, come riporta PPC Land.
PPC Land ha trovato la vecchia frase nell’anteprima in inglese britannico il 18 ottobre, e Search Engine Journal l’ha trovata ancora nell’anteprima britannica delle condizioni pubblicitarie il 19 ottobre. Quando abbiamo letto entrambe le anteprime in inglese il 20 ottobre, la parola “train” non c’era più. Le versioni in altre lingue potrebbero essere in ritardo, quindi controlla il testo nella lingua del tuo account.
Non tutti leggono la nuova formulazione come più ristretta. L’avvocato Matt Topic ha detto “penso che ‘develop’ sia abbastanza ampio da includere ‘train’”, secondo Search Engine Journal.
Quali crawler di Meta visitano il tuo sito?
Meta documenta cinque crawler nella sua pagina Meta Web Crawlers. Ognuno invia il proprio nome, chiamato user agent. Il tuo file robots.txt, il file di testo che indica ai crawler quali pagine possono leggere, può trattarli in modo diverso, per esempio consentendo le anteprime dei link e bloccando l’addestramento dell’IA.
| Crawler (user agent) | Cosa fa secondo Meta | Nota di Meta |
|---|---|---|
| FacebookExternalHit | Legge le pagine condivise nelle app di Meta per mostrare titolo, descrizione e immagine | “potrebbe ignorare robots.txt” per controlli di sicurezza o integrità |
| Meta-ExternalAds | Migliora la pubblicità e altri prodotti aziendali | Si può bloccare in robots.txt |
| Meta-WebIndexer | Migliora i risultati di ricerca di Meta AI, l’assistente IA di Meta | Consentirlo “ci aiuta a citare e linkare i tuoi contenuti” |
| Meta-ExternalAgent | Addestramento di modelli IA di base o indicizzazione di contenuti per i prodotti | Si può bloccare in robots.txt |
| Meta-ExternalFetcher | Recupera un link quando un utente lo chiede, anche quando un assistente IA apre una pagina per lui | “potrebbe ignorare le regole di robots.txt” |
Per bloccarne uno, la pagina di Meta dice di “aggiungere un disallow per il crawler interessato in robots.txt”. Avverte anche che i crawler “possono memorizzare nella cache il contenuto di robots.txt fino a 24 ore”, quindi una modifica può impiegare un giorno a funzionare.
Il tuo firewall o la tua CDN (content delivery network, un servizio come Cloudflare che sta davanti al tuo sito) potrebbe già decidere al posto tuo. Cloudflare permette ai siti di gestire i crawler IA per categoria, e il suo changelog dice che dal 15 settembre 2026 blocca per impostazione predefinita le categorie Training e Agent sulle pagine con annunci dei nuovi domini. L’elenco dei bot di Cloudflare nomina Meta-ExternalAgent e Meta-ExternalFetcher, ma non Meta-ExternalAds, Meta-WebIndexer né FacebookExternalHit.
Cosa resta poco chiaro?
Le nuove condizioni commerciali di Meta non citano mai robots.txt. Meta dice che i proprietari dei contenuti possono continuare a usare robots.txt per indicare le proprie preferenze. Search Engine Journal osserva che non è chiaro se una regola in robots.txt limiti ciò che un’attività concede con le condizioni. Cita anche un professore di diritto che spiega che per i crawler rispettare robots.txt è volontario.
Meta non ha definito quali URL siano “associati ai tuoi prodotti o servizi”. La sua pagina sui crawler non dice che uno dei cinque raccolga informazioni sui prodotti per i cataloghi, e non indica indirizzi IP per verificare che un visitatore provenga davvero da Meta.
Cosa significa per la tua attività
Secondo noi, le nuove condizioni sono un buon motivo per decidere cosa può fare ogni crawler di Meta sul tuo sito. Noi procederemmo in quest’ordine, prima del 30 ottobre, quando le nuove condizioni entrano in vigore.
- Leggi le condizioni che Meta ti mostra. Apri l’anteprima nella lingua del tuo account e trova il paragrafo sul software automatizzato. Se i tuoi contenuti sono il tuo prodotto, per esempio articoli a pagamento o un’area riservata agli iscritti, chiedi a un avvocato cosa significa la clausola per te. Non siamo avvocati e non diamo consulenza legale.
- Apri il tuo robots.txt. Vai su tuodominio.it/robots.txt e cerca regole che nominano i crawler di Meta, oltre a una regola che blocca tutti i bot. Un blocco generico rimasto dallo sviluppo nasconde il sito anche alla ricerca, come spieghiamo in una regola di robots.txt rimasta dallo sviluppo.
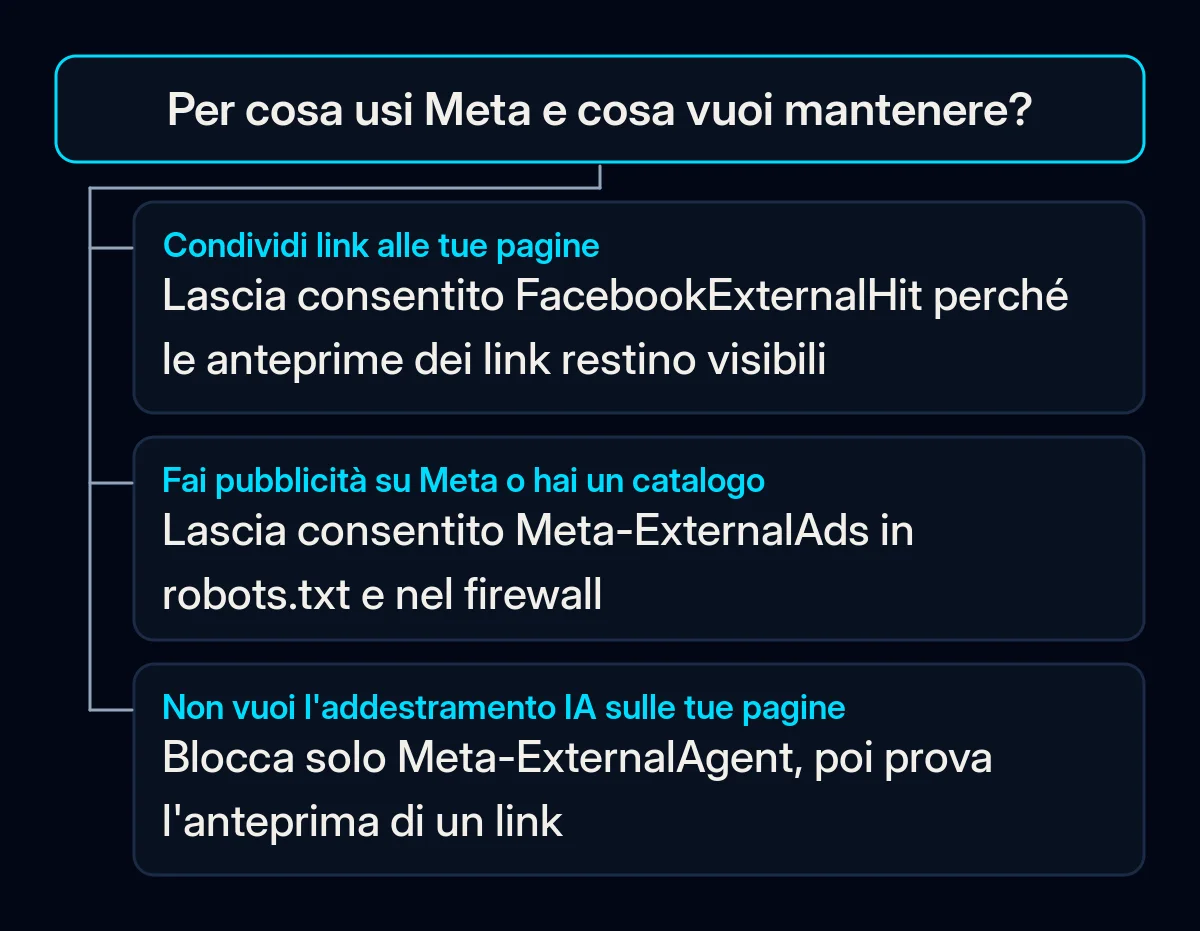
- Decidi crawler per crawler. Tieni FacebookExternalHit se condividi link alle tue pagine. Tieni Meta-ExternalAds se fai pubblicità su Meta o hai un catalogo prodotti. Consenti Meta-WebIndexer se vuoi che Meta AI citi le tue pagine. Blocca Meta-ExternalAgent se non vuoi che le tue pagine siano usate per addestrare l’IA, tenendo presente che l’effetto legale di questa regola sulle condizioni non è chiaro. Usiamo la stessa logica quando facciamo leggere le schede prodotto agli assistenti IA.
- Controlla cosa bloccano già il firewall, il plugin di sicurezza o la CDN. Non consentire ogni visitatore che ha “facebook” nel nome. Sul nostro sito abbiamo visto richieste che usavano il nome di un crawler di Meta, arrivavano da reti esterne a Meta e chiedevano file di configurazione. Leggere i log di scansione prima di scrivere nuove regole fa parte del nostro lavoro di SEO tecnica.
- Prova l’anteprima di un link dopo ogni modifica. Aspetta un giorno per la cache di robots.txt, poi incolla l’indirizzo di una pagina nello Sharing Debugger di Meta e verifica che titolo e immagine compaiano. I tag Open Graph, che forniscono quel titolo e quell’immagine, sono nella checklist di lancio dei progetti di siti web che seguiamo.
Se nessuno si occupa del tuo robots.txt, comincia oggi dal punto 2. Ti mostra se i crawler di Meta sono attualmente consentiti, bloccati o non menzionati affatto.