Termenii comerciali Meta se schimbă pe 30 octombrie 2026. Noua versiune adaugă o clauză care îi permite Meta să folosească crawlere (programe care citesc automat pagini web) pe site-urile legate de afacerea dvs. și să revină pentru actualizări. Termenii acoperă orice utilizare în scop comercial a produselor Meta, precum Facebook și Instagram, chiar dacă doar administrați o Pagină.
Potrivit PPC Land, dacă folosiți în continuare Meta în scop comercial după notificarea Meta despre actualizare, acceptați noii termeni. Înainte de 30 octombrie, decideți ce crawlere Meta au voie să vă citească site-ul și verificați că regulile dvs. nu strică previzualizările linkurilor.
Ce se schimbă în termenii comerciali Meta pe 30 octombrie?
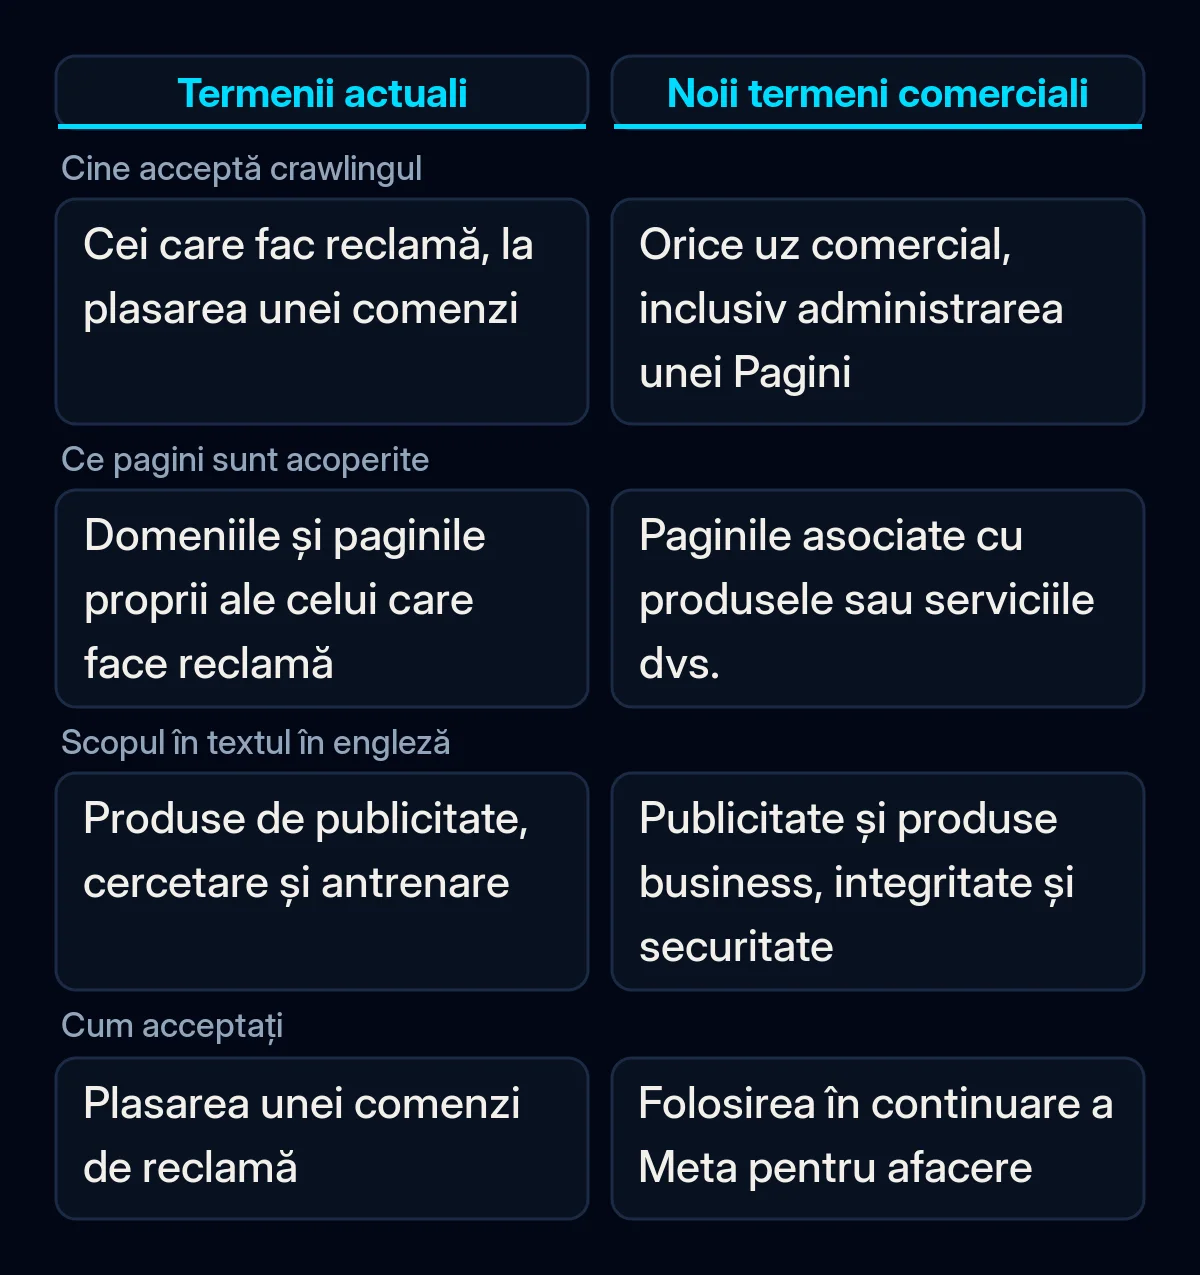
Termenii comerciali actualizați adaugă o clauză despre crawling pe care versiunea în vigoare din 6 martie 2024 nu o are. Previzualizarea noilor termeni spune că autorizați Meta, sau pe oricine acționează în numele ei, să folosească, în traducerea noastră, “software automatizat (precum web scrapere, boți, roboți, spideri, crawlere și user agents)” (automated software). Meta poate de asemenea să “creeze date de autentificare de test”, adică date de login pe care Meta și le creează singură.
Clauza acoperă domeniile, paginile web și URL-urile “asociate cu produsele sau serviciile dvs.”, precum și URL-urile puse la dispoziție prin utilizarea produselor Meta de către dvs. sau de alți utilizatori. Meta poate și să “preia periodic actualizări” de pe ele. În textul în engleză pe care l-am citit pe 20 octombrie, scopurile declarate sunt produsele de publicitate și business și “integritatea și securitatea produselor Meta Company”.
Termenii se aplică mult dincolo de cei care fac reclamă. Meta enumeră printre scopurile comerciale “administrarea unei Pagini”, “crearea sau folosirea unui catalog de produse” și folosirea Meta Business Suite.
Cei care fac reclamă au mai acordat ceva asemănător. Actualii Termeni pentru reclamele cu autoservire (Self-serve Ad Terms) ai Meta, în vigoare din 22 august 2025, îi dau deja Meta dreptul de a parcurge domeniile unui advertiser, inclusiv pentru “cercetare și antrenare”. Previzualizarea noilor termeni pentru reclame conține aceeași clauză.
De ce a schimbat Meta formularea în mai puțin de o săptămână?
Prima versiune publicată a noilor termeni comerciali mergea mai departe. O frază separată spunea că Meta poate folosi conținutul site-urilor legate de o afacere “pentru a furniza, dezvolta, îmbunătăți, cerceta, antrena și menține integritatea” produselor sale. PPC Land a citat fraza pe 16 octombrie, iar editorii și avocații au obiectat, după cum a relatat Search Engine Journal.
Apoi Meta a scos scopul antrenării din textul în engleza americană. Search Engine Journal îl citează pe purtătorul de cuvânt al Meta, Daniel Roberts, care a spus pentru The Verge că noua formulare este mai restrânsă. În cuvintele lui, termenii despre crawling “se aplicau doar produselor noastre de publicitate și business, iar acum am clarificat asta chiar în termeni”. Un alt purtător de cuvânt al Meta, Andy Stone, a spus că “nu se schimbă nimic în felul în care Meta folosește crawlerele web”, potrivit PPC Land.
PPC Land a găsit vechea frază în previzualizarea în engleza britanică pe 18 octombrie, iar Search Engine Journal a mai găsit-o pe 19 octombrie în previzualizarea în engleza britanică a termenilor pentru reclame. Când am citit ambele previzualizări în engleză pe 20 octombrie, cuvântul “train” dispăruse. Alte versiuni lingvistice pot rămâne în urmă, așa că verificați textul în limba contului dvs.
Nu toată lumea citește noua formulare ca fiind mai restrânsă. Avocatul Matt Topic a spus: “Cred că ‘develop’ este suficient de larg cât să includă ‘train’”, potrivit Search Engine Journal.
Ce crawlere Meta vă vizitează site-ul?
Meta descrie cinci crawlere pe pagina sa Meta Web Crawlers. Fiecare trimite propriul nume, numit user agent. Fișierul robots.txt, fișierul text care le spune crawlerelor ce pagini pot citi, le poate trata diferit, de exemplu permițând previzualizările linkurilor și blocând antrenarea AI.
| Crawler (user agent) | Ce spune Meta că face | Notă de la Meta |
|---|---|---|
| FacebookExternalHit | Citește paginile distribuite în aplicațiile Meta pentru a afișa titlul, descrierea și imaginea | “poate ocoli robots.txt” pentru verificări de securitate sau integritate |
| Meta-ExternalAds | Îmbunătățește produsele de publicitate și alte produse pentru business | Poate fi blocat în robots.txt |
| Meta-WebIndexer | Îmbunătățește rezultatele de căutare ale Meta AI, asistentul AI al Meta | Dacă îl permiteți, “ne ajută să cităm conținutul dvs. și să trimitem link către el” |
| Meta-ExternalAgent | Antrenarea modelelor AI de bază sau indexarea conținutului pentru produse | Poate fi blocat în robots.txt |
| Meta-ExternalFetcher | Aduce un link când un utilizator îl cere, inclusiv când un asistent AI deschide o pagină pentru el | “poate ocoli regulile din robots.txt” |
Ca să blocați unul dintre ele, pagina Meta spune să “adăugați în robots.txt o regulă disallow pentru crawlerul respectiv”. Avertizează și că crawlerele “pot păstra în cache conținutul robots.txt până la 24 de ore”, deci o schimbare poate avea efect abia după o zi.
Firewallul sau CDN-ul dvs. (content delivery network, un serviciu precum Cloudflare care stă în fața site-ului) poate deja să decidă în locul dvs. Cloudflare le permite site-urilor să gestioneze crawlerele AI pe categorii, iar jurnalul său de modificări spune că, din 15 septembrie 2026, blochează implicit categoriile Training și Agent pe paginile cu reclame ale domeniilor noi. Lista de boți a Cloudflare numește Meta-ExternalAgent și Meta-ExternalFetcher, dar nu și Meta-ExternalAds, Meta-WebIndexer sau FacebookExternalHit.
Ce rămâne neclar?
Noii termeni comerciali Meta nu menționează deloc robots.txt. Meta spune că proprietarii de conținut pot folosi în continuare robots.txt pentru a-și arăta preferințele. Search Engine Journal notează că nu este clar dacă o regulă din robots.txt limitează ce acordă o afacere prin termeni. Publicația citează și un profesor de drept care explică faptul că respectarea robots.txt este voluntară pentru crawlere.
Meta nu a definit ce URL-uri contează drept “asociate cu produsele sau serviciile dvs.”. Pagina sa despre crawlere nu spune că vreunul dintre cele cinci crawlere colectează informații despre produse pentru cataloage și nu listează adrese IP cu care să verificați că un vizitator vine într-adevăr de la Meta.
Ce înseamnă pentru afacerea dvs.
În opinia noastră, noii termeni sunt un motiv bun să decideți ce are voie să facă fiecare crawler Meta pe site-ul dvs. Noi am face-o în această ordine, înainte de 30 octombrie, când noii termeni intră în vigoare.
- Citiți termenii pe care vi-i arată Meta. Deschideți previzualizarea în limba contului dvs. și găsiți paragraful despre software-ul automatizat. Dacă produsul dvs. este chiar conținutul, de exemplu articole plătite sau o zonă pentru membri, întrebați un avocat ce înseamnă clauza pentru dvs. Nu suntem avocați și nu oferim consultanță juridică.
- Deschideți robots.txt. Mergeți la domeniul-dvs.ro/robots.txt și căutați reguli care numesc crawlerele Meta, precum și o regulă care blochează toți roboții. O blocare generală rămasă din dezvoltare vă ascunde site-ul și din căutare, așa cum explicăm în articolul despre o regulă robots.txt rămasă din dezvoltare.
- Decideți crawler cu crawler. Păstrați FacebookExternalHit dacă distribuiți linkuri către paginile dvs. Păstrați Meta-ExternalAds dacă rulați reclame Meta sau un catalog de produse. Permiteți Meta-WebIndexer dacă vreți ca Meta AI să vă citeze paginile. Blocați Meta-ExternalAgent dacă nu vreți ca paginile dvs. să fie folosite pentru antrenarea AI, ținând cont că efectul juridic al unei astfel de reguli asupra termenilor este neclar. Folosim aceeași logică atunci când lăsăm asistenții AI să citească paginile de produs.
- Verificați ce blochează deja firewallul, pluginul de securitate sau CDN-ul. Nu permiteți orice vizitator care are “facebook” în nume. Pe propriul nostru site am văzut cereri care foloseau numele unui crawler Meta, veneau din rețele din afara Meta și cereau fișiere de configurare. Citirea jurnalelor de crawling înainte de a scrie reguli noi face parte din serviciile noastre de SEO tehnic.
- Testați o previzualizare de link după orice schimbare. Așteptați o zi pentru cache-ul robots.txt, apoi lipiți adresa unei pagini în Sharing Debugger de la Meta și verificați că apar titlul și imaginea. Etichetele Open Graph, care furnizează titlul și imaginea, sunt pe lista de verificare la lansarea site-urilor după care lucrăm.
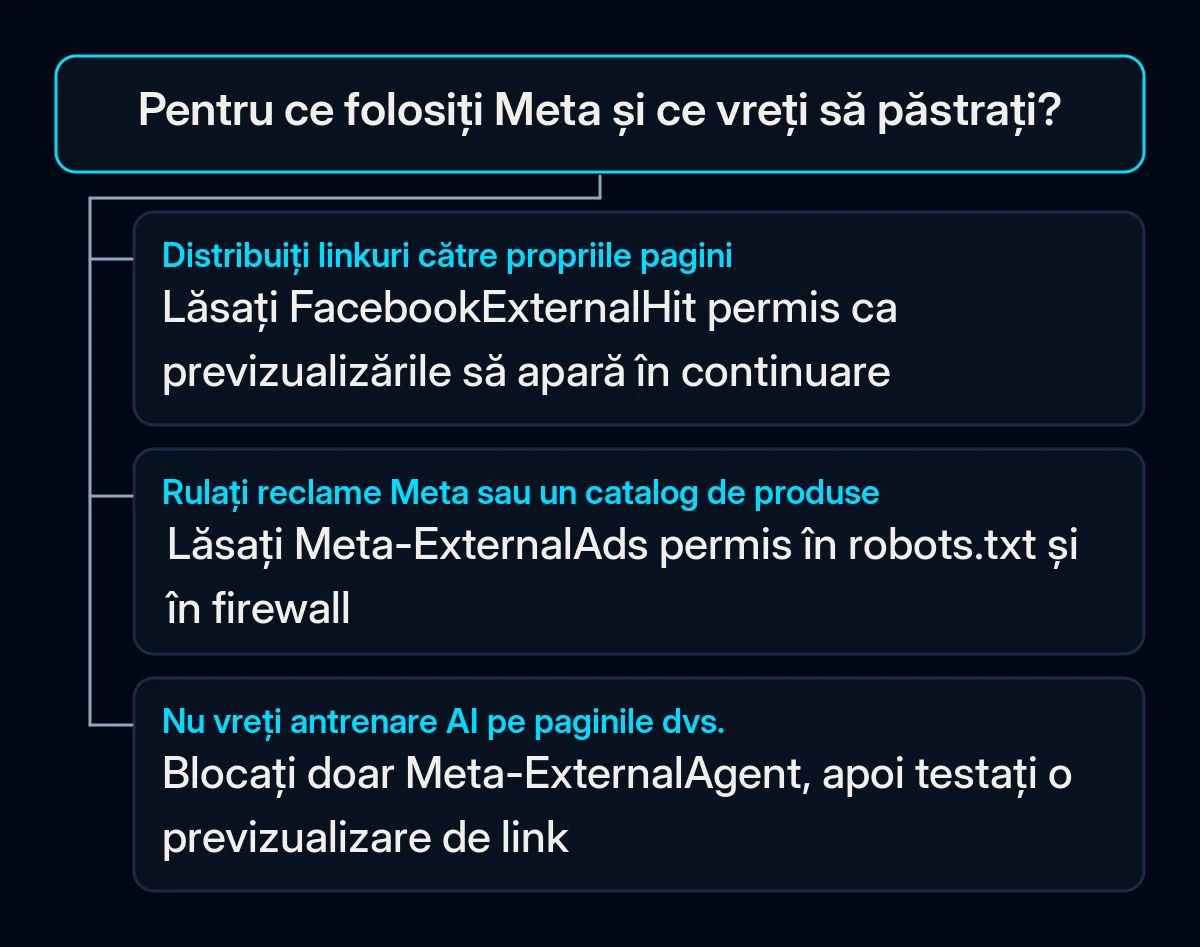
Dacă nu se ocupă nimeni de robots.txt, începeți azi cu pasul 2. El arată dacă crawlerele Meta sunt acum permise, blocate sau nu sunt menționate deloc.