Las nuevas condiciones de Meta entran en vigor el 30 de octubre de 2026. La nueva versión de las Condiciones comerciales (Commercial Terms) añade una cláusula que permite a Meta usar rastreadores (programas que leen páginas web de forma automática) en los sitios web vinculados a tu negocio, y volver a ellos para obtener actualizaciones. Las condiciones cubren cualquier uso comercial de los productos de Meta, como Facebook e Instagram, aunque solo gestiones una página.
Según PPC Land, seguir usando Meta con fines comerciales después del aviso de Meta sobre la actualización equivale a aceptar las nuevas condiciones. Antes del 30 de octubre, decide qué rastreadores de Meta pueden leer tu web y comprueba que tus reglas no rompan las vistas previas de enlaces.
¿Qué cambia en las nuevas condiciones de Meta el 30 de octubre?
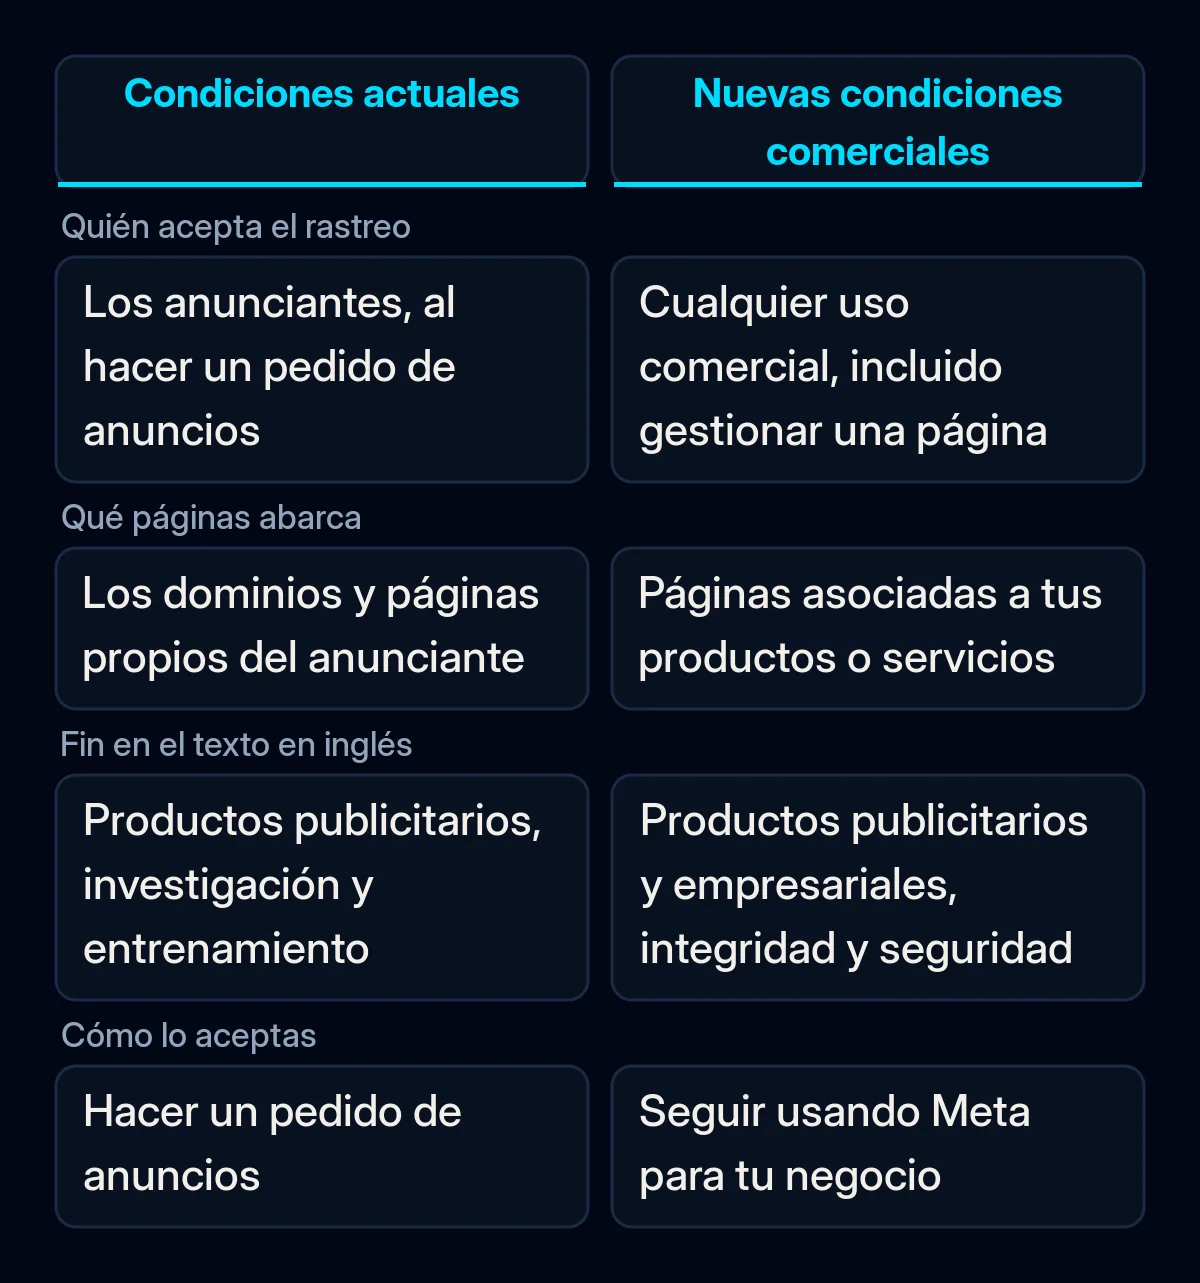
Las Condiciones comerciales actualizadas añaden una cláusula de rastreo que no existe en la versión vigente desde el 6 de marzo de 2024. La vista previa de las nuevas condiciones dice que autorizas a Meta, o a cualquiera que actúe en su nombre, a usar “software automatizado (como web scrapers, bots, robots, spiders, crawlers y user agents)”. También puede “crear credenciales de prueba”, es decir, datos de acceso que Meta crea para sí misma.
La cláusula abarca los dominios, páginas web y URL “asociados a tus productos o servicios”, así como las URL disponibles a través de tu uso de los productos de Meta o del de otros usuarios. Meta también puede “obtener actualizaciones periódicamente”. En el texto en inglés que leímos el 20 de octubre, los fines indicados son los productos publicitarios y empresariales, y “la integridad y la seguridad de los Productos de las Empresas de Meta”.
Las condiciones van mucho más allá de los anunciantes. Meta incluye “gestionar una página”, “crear o usar un catálogo de productos” y usar Meta Business Suite entre los fines comerciales.
Los anunciantes ya habían concedido algo parecido. Las actuales Condiciones de publicidad de autoservicio de Meta, vigentes desde el 22 de agosto de 2025, ya dan a Meta el derecho a rastrear los dominios de un anunciante, también para “investigación y entrenamiento”. La vista previa de las nuevas condiciones publicitarias contiene la misma cláusula.
¿Por qué cambió Meta la redacción en una semana?
La primera versión publicada de las nuevas Condiciones comerciales iba más lejos. Una frase aparte decía que Meta podía usar el contenido de los sitios web vinculados a un negocio para “proporcionar, desarrollar, mejorar, investigar, entrenar y mantener la integridad de” sus productos. PPC Land citó esa frase el 16 de octubre, y editores y abogados protestaron, según informó Search Engine Journal.
Después Meta eliminó el fin de entrenamiento del texto en inglés de EE. UU. Search Engine Journal cita al portavoz de Meta Daniel Roberts, que dijo a The Verge que la nueva redacción es más limitada. En sus palabras, las condiciones de rastreo “solo se aplicaban a nuestros productos publicitarios y empresariales, y lo hemos aclarado en las propias condiciones”. Otro portavoz de Meta, Andy Stone, dijo que “no hay ningún cambio en cómo Meta usa los rastreadores web”, según PPC Land.
PPC Land encontró la frase antigua en la vista previa en inglés británico el 18 de octubre, y Search Engine Journal aún la encontró el 19 de octubre en la vista previa en inglés británico de las condiciones publicitarias. Cuando leímos ambas vistas previas en inglés el 20 de octubre, la palabra “train” ya no estaba. Otras versiones de idioma pueden ir con retraso, así que revisa el texto en el idioma de tu cuenta.
No todo el mundo lee la nueva redacción como más limitada. El abogado Matt Topic dijo: “Creo que ‘develop’ es lo bastante amplio como para incluir ‘train’”, según Search Engine Journal.
¿Qué rastreadores de Meta visitan tu web?
Meta documenta cinco rastreadores en su página Meta Web Crawlers. Cada uno envía su propio nombre, llamado user agent. Tu archivo robots.txt, el archivo de texto que indica a los rastreadores qué páginas pueden leer, puede tratarlos de forma distinta, por ejemplo, permitir las vistas previas de enlaces y bloquear a la vez el entrenamiento de IA.
| Rastreador (user agent) | Qué hace según Meta | Nota de Meta |
|---|---|---|
| FacebookExternalHit | Lee las páginas compartidas en las apps de Meta para mostrar un título, una descripción y una imagen | “podría saltarse robots.txt” en controles de seguridad o integridad |
| Meta-ExternalAds | Mejora la publicidad y otros productos empresariales | Se puede bloquear en robots.txt |
| Meta-WebIndexer | Mejora los resultados de búsqueda de Meta AI, el asistente de IA de Meta | Permitirlo “nos ayuda a citar y enlazar tu contenido” |
| Meta-ExternalAgent | Entrenamiento de modelos fundacionales de IA o indexación de contenido para productos | Se puede bloquear en robots.txt |
| Meta-ExternalFetcher | Obtiene un enlace cuando un usuario lo pide, también cuando un asistente de IA abre una página por él | “puede saltarse las reglas de robots.txt” |
Para bloquear uno de ellos, la página de Meta indica “añadir un disallow para el rastreador correspondiente en robots.txt”. También advierte de que los rastreadores “pueden guardar en caché el contenido de robots.txt hasta 24 horas”, así que un cambio puede tardar un día en surtir efecto.
Tu firewall o tu CDN (red de distribución de contenidos, un servicio como Cloudflare que se sitúa delante de tu web) quizá ya esté decidiendo por ti. Cloudflare permite a los sitios gestionar los rastreadores de IA por categorías, y su changelog dice que desde el 15 de septiembre de 2026 bloquea por defecto las categorías Training y Agent en las páginas con anuncios de los dominios nuevos. La lista de bots de Cloudflare incluye Meta-ExternalAgent y Meta-ExternalFetcher, pero no Meta-ExternalAds, Meta-WebIndexer ni FacebookExternalHit.
¿Qué sigue sin estar claro?
Las nuevas condiciones de Meta no mencionan robots.txt en absoluto. Meta dice que los propietarios de contenido pueden seguir usando robots.txt para mostrar sus preferencias. Search Engine Journal señala que no está claro si una regla de robots.txt limita lo que un negocio concede en las condiciones. También cita a un profesor de Derecho que explica que respetar robots.txt es voluntario para los rastreadores.
Meta no ha definido qué URL cuentan como “asociadas a tus productos o servicios”. Su página de rastreadores no dice que ninguno de los cinco recopile información de productos para catálogos, y no indica direcciones IP para comprobar que un visitante viene realmente de Meta.
Qué significa para tu negocio
En nuestra opinión, las nuevas condiciones son un buen motivo para decidir qué puede hacer cada rastreador de Meta en tu web. Nosotros lo haríamos en este orden, antes del 30 de octubre, cuando entran en vigor las nuevas condiciones.
- Lee las condiciones que Meta te muestra. Abre la vista previa en el idioma de tu cuenta y busca el párrafo sobre software automatizado. Si tu contenido es tu producto, por ejemplo artículos de pago o un área de socios, pregunta a un abogado qué significa la cláusula para ti. No somos abogados y no damos asesoramiento jurídico.
- Abre tu robots.txt. Entra en tudominio.es/robots.txt y busca reglas que nombren a los rastreadores de Meta, y una regla que bloquee todos los bots. Un bloqueo amplio que quedó de la fase de desarrollo también oculta tu web a los buscadores, como explicamos en por qué tu web no aparece en Google.
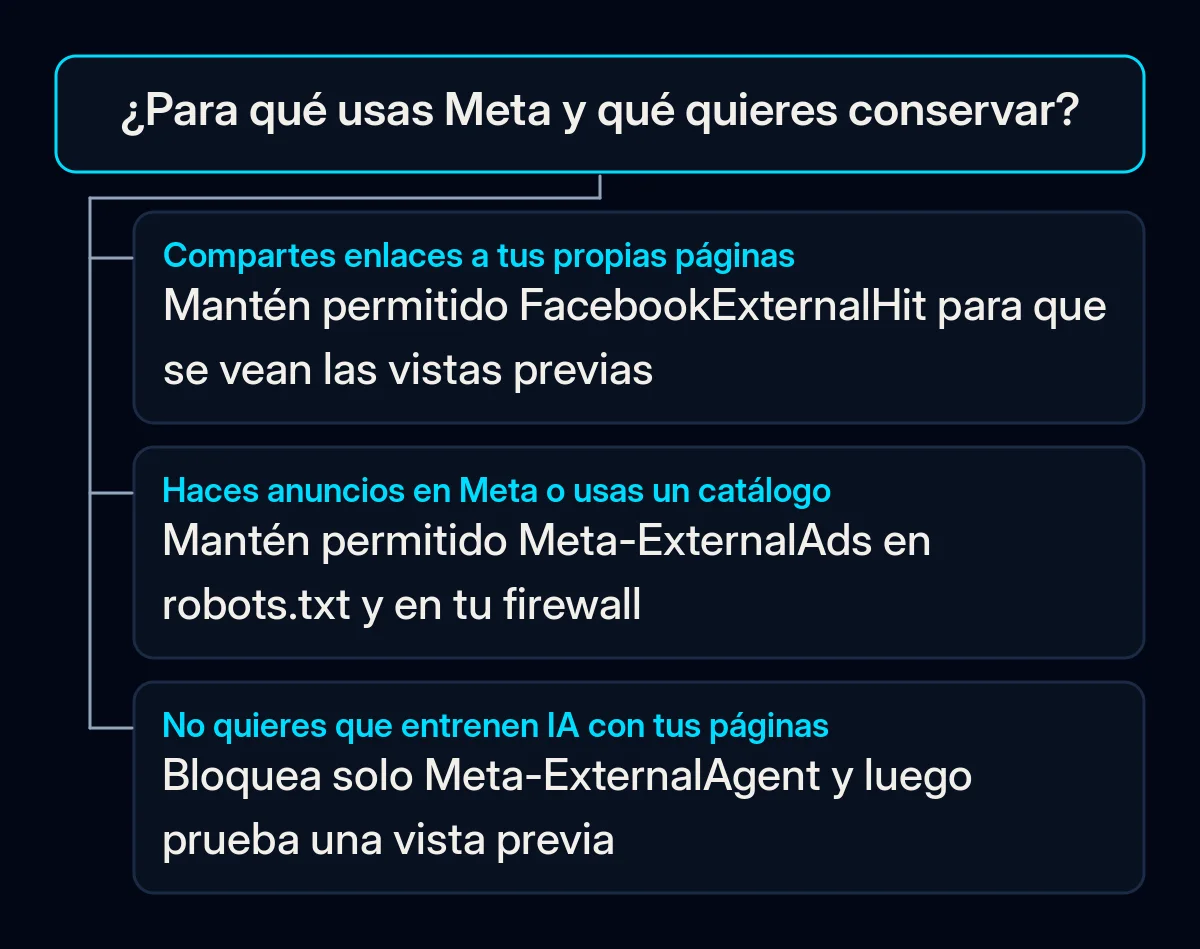
- Decide rastreador por rastreador. Mantén FacebookExternalHit si compartes enlaces a tus páginas. Mantén Meta-ExternalAds si haces publicidad en Meta o usas un catálogo de productos. Permite Meta-WebIndexer si quieres que Meta AI cite tus páginas. Bloquea Meta-ExternalAgent si no quieres que tus páginas se usen para entrenar IA, teniendo en cuenta que el efecto jurídico de esa regla sobre las condiciones no está claro. Usamos la misma lógica cuando dejamos que los asistentes de IA lean tus fichas de producto.
- Comprueba qué bloquea ya tu firewall, tu plugin de seguridad o tu CDN. No dejes pasar a cualquier visitante que lleve “facebook” en el nombre. En nuestra propia web hemos visto peticiones que usaban el nombre de un rastreador de Meta, venían de redes ajenas a Meta y pedían archivos de configuración. Leer los registros de rastreo antes de escribir reglas nuevas forma parte de nuestro trabajo de SEO técnico.
- Prueba una vista previa de enlace después de cada cambio. Espera un día por la caché de robots.txt, pega la dirección de una página en el Sharing Debugger de Meta y comprueba que aparecen el título y la imagen. Las etiquetas Open Graph, que aportan ese título y esa imagen, están en la checklist de lanzamiento de proyectos web con la que trabajamos.
Si nadie se ocupa de tu robots.txt, empieza hoy por el paso 2. Te muestra si los rastreadores de Meta están ahora permitidos, bloqueados o ni siquiera mencionados.