Комерційні умови Meta (Meta Commercial Terms) змінюються 30 жовтня 2026 року. У новій версії з’явився пункт, який дозволяє Meta запускати краулери (програми, що автоматично читають вебсторінки) на сайти, пов’язані з вашим бізнесом, і повертатися по оновлення. Умови поширюються на будь-яке ділове використання продуктів Meta, наприклад Facebook та Instagram, навіть якщо ви лише ведете сторінку.
За даними PPC Land, якщо ви продовжуєте користуватися Meta для бізнесу після повідомлення Meta про оновлення, це вважається згодою з новими умовами. До 30 жовтня вирішіть, яким краулерам Meta можна читати ваш сайт, і перевірте, що ваші правила не ламають прев’ю посилань.
Що змінюється в комерційних умовах Meta 30 жовтня?
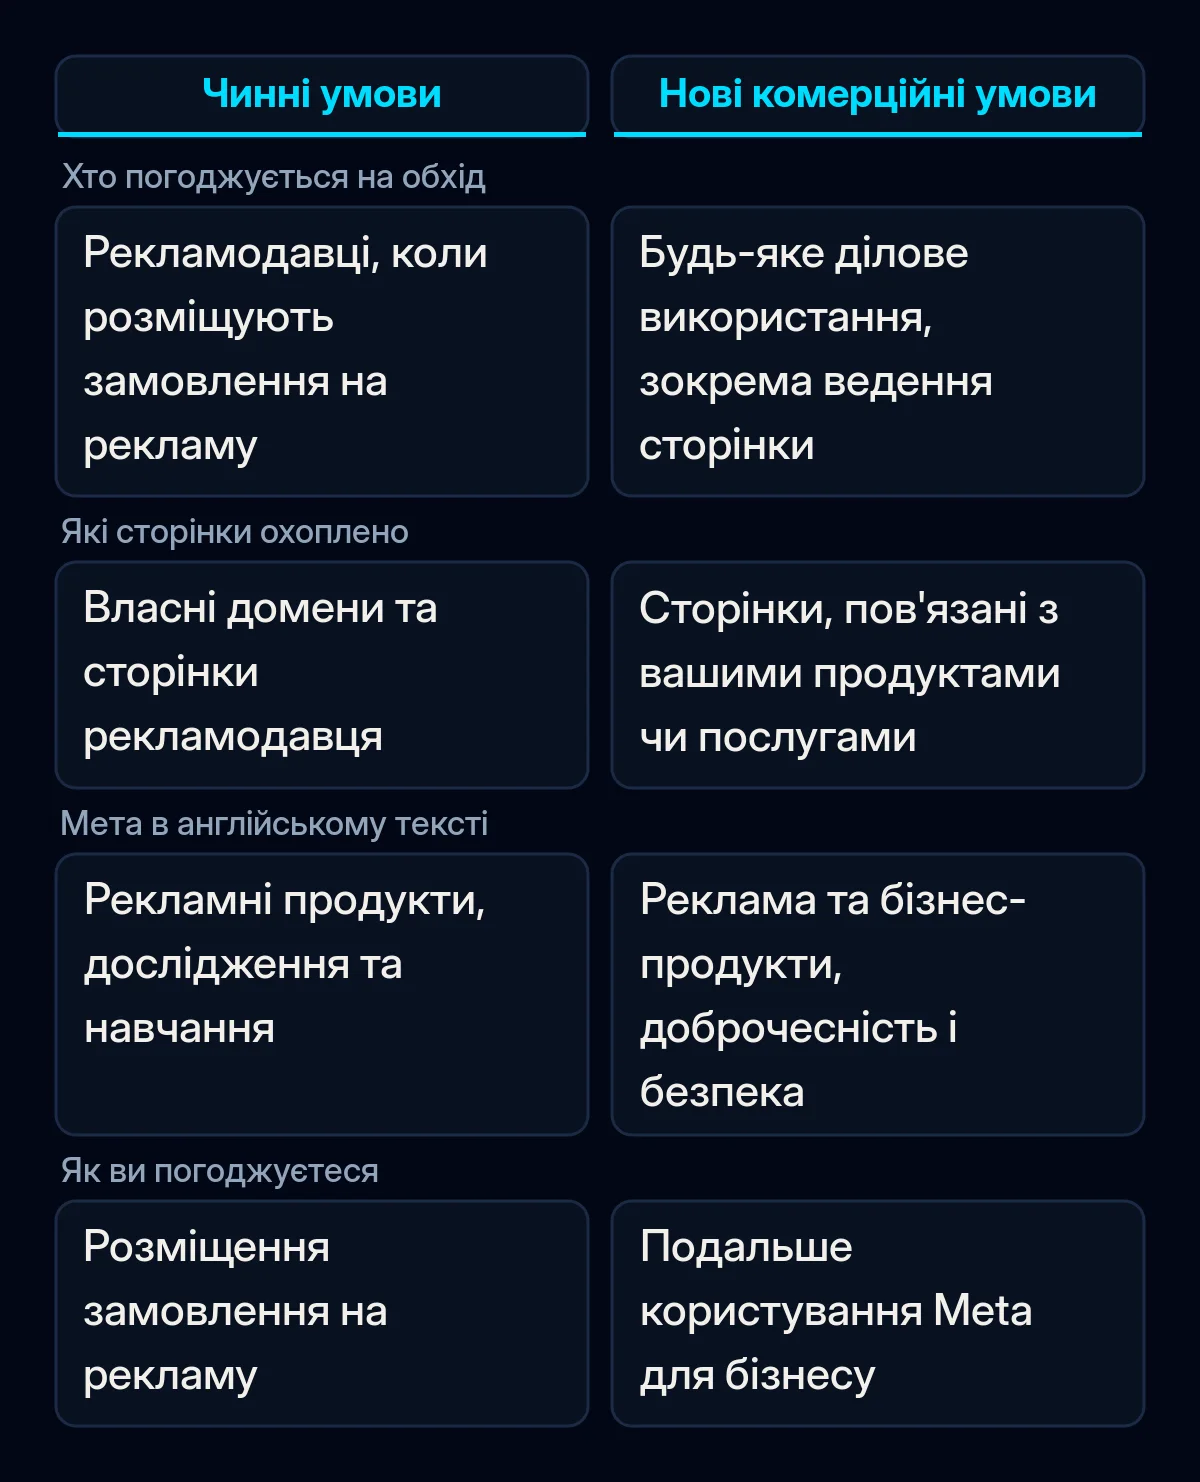
В оновлених Commercial Terms з’явився пункт про обхід сайтів, якого немає у версії, чинній з 6 березня 2024 року. У попередній версії нових умов сказано, що ви дозволяєте Meta або тим, хто діє від її імені, використовувати “автоматизоване ПЗ (наприклад, вебскрейпери, боти, роботи, павуки, краулери та користувацькі агенти)”. Meta також може “створювати тестові облікові дані”, тобто логіни, які Meta заводить для себе.
Пункт охоплює домени, вебсторінки та URL, “пов’язані з вашими продуктами чи послугами”, а також URL, що стали доступні завдяки тому, що ви або інші користувачі користуєтеся продуктами Meta. Meta також може “періодично отримувати оновлення” з них. В англійському тексті, який ми прочитали 20 жовтня, заявлені цілі - рекламні та бізнес-продукти, а також “доброчесність і безпека продуктів компанії Meta”.
Умови стосуються далеко не лише рекламодавців. Серед ділових цілей Meta називає “керування сторінкою”, “створення або використання каталогу товарів” і роботу в Meta Business Suite.
Щось подібне рекламодавці вже дозволяли. Чинні Self-serve Ad Terms Meta, які діють з 22 серпня 2025 року, уже дають Meta право обходити домени рекламодавця, зокрема для “досліджень і навчання”. У попередній версії нових рекламних умов той самий пункт зберігся.
Чому Meta змінила формулювання за тиждень?
Перша опублікована версія нових Commercial Terms заходила далі. Окреме речення говорило, що Meta може використовувати контент сайтів, пов’язаних із бізнесом, щоб “надавати, розвивати, покращувати, досліджувати, навчати та підтримувати доброчесність” своїх продуктів. PPC Land процитував це речення 16 жовтня, і видавці та юристи заперечили, як повідомив Search Engine Journal.
Після цього Meta прибрала мету навчання з американського англійського тексту. Search Engine Journal посилається на речника Meta Деніела Робертса, який сказав The Verge, що нове формулювання вужче. За його словами, умови про обхід “стосувалися лише наших рекламних і бізнес-продуктів, і ми уточнили це в самих умовах”. Інший речник Meta, Енді Стоун, сказав, що “у тому, як Meta використовує веб-краулери, нічого не змінюється”, як цитує PPC Land.
PPC Land знайшов старе речення в британській англійській версії умов 18 жовтня, а Search Engine Journal 19 жовтня ще бачив його в британській англійській версії рекламних умов. Коли ми читали обидві англійські версії 20 жовтня, слова “train” там уже не було. Версії іншими мовами можуть відставати, тому перевірте текст мовою свого облікового запису.
Не всі вважають нове формулювання вужчим. Юрист Метт Топік сказав: “Думаю, ‘develop’ достатньо широке слово, щоб охоплювати ‘train’”, - пише Search Engine Journal.
Які краулери Meta заходять на ваш сайт?
Meta описує п’ять краулерів на сторінці Meta Web Crawlers. Кожен передає своє ім’я, так званий user agent. Файл robots.txt, текстовий файл, що повідомляє краулерам, які сторінки їм можна читати, може задавати для них різні правила, наприклад дозволити прев’ю посилань і заборонити навчання ШІ.
| Краулер (user agent) | Що він робить, за словами Meta | Примітка Meta |
|---|---|---|
| FacebookExternalHit | Читає сторінки, якими діляться в застосунках Meta, щоб показати заголовок, опис і зображення | “може оминати robots.txt” для перевірок безпеки або доброчесності |
| Meta-ExternalAds | Покращує рекламу та інші бізнес-продукти | Можна заблокувати в robots.txt |
| Meta-WebIndexer | Покращує результати пошуку в Meta AI, ШІ-асистенті Meta | Якщо його дозволити, це “допомагає нам цитувати ваш контент і посилатися на нього” |
| Meta-ExternalAgent | Навчання базових моделей ШІ або індексування контенту для продуктів | Можна заблокувати в robots.txt |
| Meta-ExternalFetcher | Завантажує посилання на запит користувача, зокрема коли ШІ-асистент відкриває сторінку для нього | “може оминати правила robots.txt” |
Щоб заблокувати один із них, Meta радить “додати в robots.txt заборону (disallow) для потрібного краулера”. Там само є застереження: краулери “можуть кешувати вміст robots.txt до 24 годин”, тож зміна може запрацювати лише через добу.
Можливо, за вас уже вирішує файрвол або CDN (мережа доставки контенту, сервіс на кшталт Cloudflare, що стоїть перед вашим сайтом). Cloudflare дає сайтам змогу керувати ШІ-краулерами за категоріями, і, згідно з його журналом змін, з 15 вересня 2026 року він за замовчуванням блокує категорії Training і Agent на сторінках із рекламою для нових доменів. У списку ботів Cloudflare є Meta-ExternalAgent і Meta-ExternalFetcher, але немає Meta-ExternalAds, Meta-WebIndexer і FacebookExternalHit.
Що поки незрозуміло?
У нових комерційних умовах Meta robots.txt взагалі не згадано. Meta каже, що власники контенту можуть і далі висловлювати свої побажання через robots.txt. Search Engine Journal зазначає, що незрозуміло, чи обмежує правило в robots.txt те, що бізнес дозволяє в умовах. Видання також посилається на професора права, який пояснює, що дотримуватися robots.txt краулери не зобов’язані.
Meta не уточнила, які URL вважаються “пов’язаними з вашими продуктами чи послугами”. На її сторінці про краулери не сказано, що будь-який із п’яти краулерів збирає дані про товари для каталогів, і немає списку IP-адрес, за якими можна перевірити, що відвідувач справді прийшов від Meta.
Що це означає для вашого бізнесу
На нашу думку, нові умови - добрий привід вирішити, що кожному краулеру Meta можна робити на вашому сайті. Ми б діяли в такому порядку, до 30 жовтня, коли нові умови набирають чинності.
- Прочитайте умови, які показує вам Meta. Відкрийте попередню версію мовою свого облікового запису та знайдіть абзац про автоматизоване ПЗ. Якщо ваш контент і є вашим продуктом, наприклад платні статті чи закритий розділ для учасників, запитайте юриста, що цей пункт означає для вас. Ми не юристи і юридичних консультацій не надаємо.
- Відкрийте свій robots.txt. Перейдіть на вашдомен.com/robots.txt і пошукайте правила з іменами краулерів Meta, а також правило, що блокує всіх ботів. Широка заборона, що лишилася після розробки, приховує сайт і від пошуку - про це ми розповідаємо в статті чому сайт не з’являється в Google.
- Вирішуйте щодо кожного краулера. Залиште FacebookExternalHit, якщо ділитеся посиланнями на свої сторінки. Залиште Meta-ExternalAds, якщо запускаєте рекламу в Meta або ведете каталог товарів. Дозвольте Meta-WebIndexer, якщо хочете, щоб Meta AI цитував ваші сторінки. Заблокуйте Meta-ExternalAgent, якщо не хочете, щоб ваші сторінки йшли на навчання ШІ, але пам’ятайте, що юридична сила такого правила для умов незрозуміла. За тією самою логікою ми відкриваємо сторінки товарів для ШІ-асистентів на кшталт ChatGPT.
- Перевірте, що вже блокує ваш файрвол, плагін безпеки чи CDN. Не пропускайте кожного відвідувача, у якого в імені є “facebook”. На власному сайті ми бачили запити, що використовували ім’я краулера Meta, надходили з мереж поза Meta і запитували файли конфігурації. Аналіз логів обходу до того, як писати нові правила, входить у нашу роботу з технічного SEO.
- Після будь-якої зміни перевірте прев’ю посилання. Зачекайте добу, поки оновиться кеш robots.txt, потім вставте адресу сторінки в Sharing Debugger від Meta і переконайтеся, що заголовок і зображення відображаються. Теги Open Graph, які й задають цей заголовок і зображення, входять до чек-листа запуску сайтів, за яким ми працюємо.
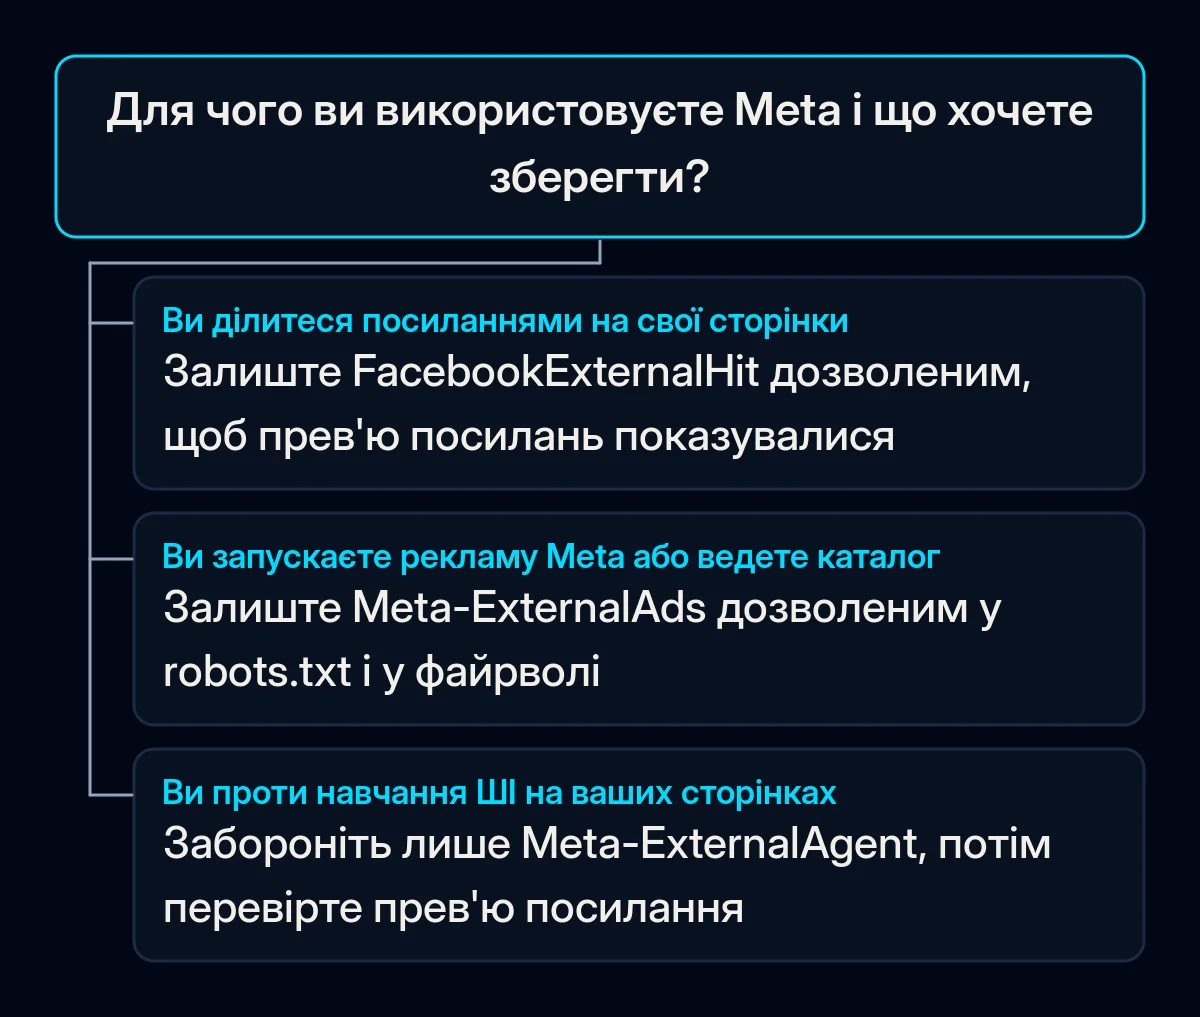
Якщо за вашим robots.txt ніхто не стежить, почніть із кроку 2 сьогодні. Він покаже, чи дозволені зараз краулери Meta, заблоковані чи взагалі не згадані.