Οι εμπορικοί όροι της Meta αλλάζουν στις 30 Οκτωβρίου 2026. Η νέα έκδοση προσθέτει έναν όρο που επιτρέπει στη Meta να χρησιμοποιεί crawlers (προγράμματα που διαβάζουν αυτόματα ιστοσελίδες) σε sites που συνδέονται με την επιχείρησή σας και να επιστρέφει για ενημερώσεις. Οι όροι καλύπτουν κάθε επιχειρηματική χρήση των προϊόντων της Meta, όπως το Facebook και το Instagram, ακόμη κι αν απλώς διαχειρίζεστε μια Σελίδα.
Σύμφωνα με το PPC Land, αν συνεχίσετε να χρησιμοποιείτε τη Meta για την επιχείρησή σας μετά την ειδοποίηση της Meta για την ενημέρωση, θεωρείται ότι αποδέχεστε τους νέους όρους. Πριν από τις 30 Οκτωβρίου, αποφασίστε ποια crawlers της Meta επιτρέπεται να διαβάζουν το site σας και ελέγξτε ότι οι κανόνες σας δεν χαλάνε τις προεπισκοπήσεις συνδέσμων.
Εμπορικοί όροι της Meta: τι αλλάζει στις 30 Οκτωβρίου;
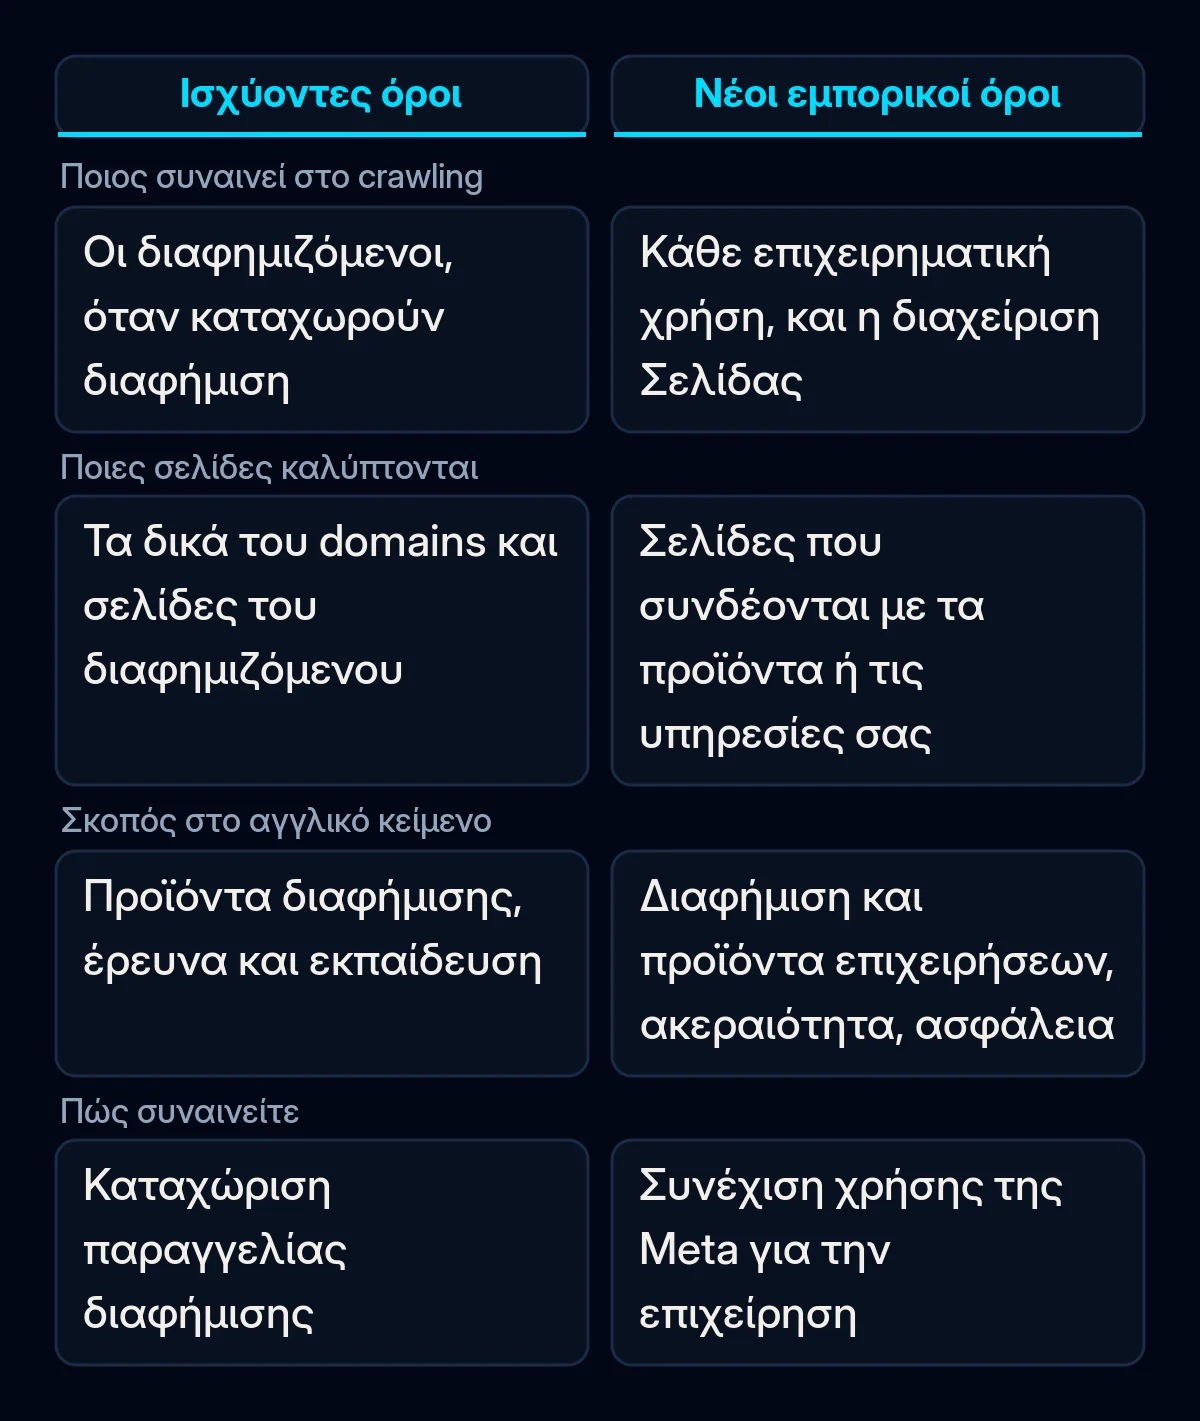
Οι ενημερωμένοι Εμπορικοί όροι προσθέτουν έναν όρο για το crawling που δεν υπάρχει στην έκδοση που ισχύει από τις 6 Μαρτίου 2024. Η προεπισκόπηση των νέων όρων λέει ότι εξουσιοδοτείτε τη Meta, ή όποιον ενεργεί για λογαριασμό της, να χρησιμοποιεί, σε δική μας μετάφραση, “αυτοματοποιημένο λογισμικό (όπως web scrapers, bots, ρομπότ, spiders, crawlers και user agents)” (automated software). Μπορεί επίσης να “δημιουργεί δοκιμαστικά διαπιστευτήρια”, δηλαδή στοιχεία σύνδεσης που η Meta φτιάχνει για τον εαυτό της.
Ο όρος καλύπτει τους τομείς (domains), τις ιστοσελίδες και τα URL “που συνδέονται με τα προϊόντα ή τις υπηρεσίες σας”, καθώς και URL που γίνονται διαθέσιμα μέσω της χρήσης των προϊόντων της Meta από εσάς ή άλλους χρήστες. Η Meta μπορεί επίσης να “αντλεί περιοδικά ενημερώσεις” από αυτά. Στο αγγλικό κείμενο που διαβάσαμε στις 20 Οκτωβρίου, οι δηλωμένοι σκοποί είναι τα προϊόντα διαφήμισης και επιχειρήσεων και “η ακεραιότητα και η ασφάλεια των προϊόντων της Meta Company”.
Οι όροι αφορούν πολύ περισσότερους από τους διαφημιζόμενους. Η Meta αναφέρει στους επιχειρηματικούς σκοπούς τη “διαχείριση μιας Σελίδας”, τη “δημιουργία ή χρήση καταλόγου προϊόντων” και τη χρήση του Meta Business Suite.
Οι διαφημιζόμενοι έχουν ήδη παραχωρήσει κάτι παρόμοιο. Οι ισχύοντες Όροι διαφημίσεων αυτοεξυπηρέτησης (Self-serve Ad Terms) της Meta, σε ισχύ από τις 22 Αυγούστου 2025, δίνουν ήδη στη Meta το δικαίωμα να κάνει crawling στα domains ενός διαφημιζόμενου, μεταξύ άλλων για “έρευνα και εκπαίδευση”. Η προεπισκόπηση των νέων όρων διαφημίσεων περιέχει τον ίδιο όρο.
Γιατί η Meta άλλαξε τη διατύπωση μέσα σε μία εβδομάδα;
Η πρώτη δημοσιευμένη έκδοση των νέων Εμπορικών όρων πήγαινε πιο μακριά. Μια χωριστή πρόταση έλεγε ότι η Meta μπορεί να χρησιμοποιεί περιεχόμενο από sites που συνδέονται με μια επιχείρηση “για να παρέχει, να αναπτύσσει, να βελτιώνει, να ερευνά, να εκπαιδεύει και να διατηρεί την ακεραιότητα” των προϊόντων της. Το PPC Land παρέθεσε την πρόταση στις 16 Οκτωβρίου και εκδότες και δικηγόροι αντέδρασαν, όπως μετέδωσε το Search Engine Journal.
Στη συνέχεια η Meta αφαίρεσε τον σκοπό της εκπαίδευσης από το κείμενο στα αμερικανικά αγγλικά. Το Search Engine Journal παραθέτει τον εκπρόσωπο της Meta Daniel Roberts, ο οποίος είπε στο The Verge ότι η νέα διατύπωση είναι στενότερη. Με τα δικά του λόγια, οι όροι για το crawling “αφορούσαν μόνο τα προϊόντα διαφήμισης και επιχειρήσεων και το διευκρινίσαμε μέσα στους ίδιους τους όρους”. Ένας άλλος εκπρόσωπος της Meta, ο Andy Stone, είπε ότι “δεν αλλάζει τίποτα στον τρόπο που η Meta χρησιμοποιεί τα web crawlers”, όπως παραθέτει το PPC Land.
Το PPC Land βρήκε την παλιά πρόταση στην προεπισκόπηση στα βρετανικά αγγλικά στις 18 Οκτωβρίου, και το Search Engine Journal τη βρήκε ακόμη στις 19 Οκτωβρίου στην προεπισκόπηση των όρων διαφημίσεων στα βρετανικά αγγλικά. Όταν διαβάσαμε και τις δύο αγγλικές προεπισκοπήσεις στις 20 Οκτωβρίου, η λέξη “train” είχε φύγει. Άλλες γλωσσικές εκδόσεις μπορεί να καθυστερούν ακόμη, οπότε ελέγξτε το κείμενο στη γλώσσα του λογαριασμού σας.
Δεν διαβάζουν όλοι τη νέα διατύπωση ως στενότερη. Ο δικηγόρος Matt Topic είπε “νομίζω ότι το ‘develop’ είναι αρκετά ευρύ ώστε να περιλαμβάνει το ‘train’”, σύμφωνα με το Search Engine Journal.
Ποια crawlers της Meta επισκέπτονται το site σας;
Η Meta περιγράφει πέντε crawlers στη σελίδα Meta Web Crawlers. Το καθένα στέλνει το δικό του όνομα, που λέγεται user agent. Το αρχείο robots.txt, το αρχείο κειμένου που λέει στα crawlers ποιες σελίδες μπορούν να διαβάζουν, μπορεί να τα χειρίζεται διαφορετικά, για παράδειγμα να επιτρέπει τις προεπισκοπήσεις συνδέσμων και να μπλοκάρει την εκπαίδευση AI.
| Crawler (user agent) | Τι λέει η Meta ότι κάνει | Σημείωση της Meta |
|---|---|---|
| FacebookExternalHit | Διαβάζει σελίδες που κοινοποιούνται στις εφαρμογές της Meta για να δείξει τίτλο, περιγραφή και εικόνα | “μπορεί να παρακάμψει το robots.txt” για ελέγχους ασφάλειας ή ακεραιότητας |
| Meta-ExternalAds | Βελτιώνει τα προϊόντα διαφήμισης και άλλα προϊόντα για επιχειρήσεις | Μπλοκάρεται στο robots.txt |
| Meta-WebIndexer | Βελτιώνει τα αποτελέσματα αναζήτησης του Meta AI, του βοηθού AI της Meta | Αν το επιτρέψετε, “μας βοηθά να παραθέτουμε το περιεχόμενό σας και να παραπέμπουμε σε αυτό” |
| Meta-ExternalAgent | Εκπαίδευση θεμελιωδών μοντέλων AI ή ευρετηρίαση περιεχομένου για προϊόντα | Μπλοκάρεται στο robots.txt |
| Meta-ExternalFetcher | Ανακτά έναν σύνδεσμο όταν το ζητά ένας χρήστης, και όταν ένας βοηθός AI ανοίγει μια σελίδα για λογαριασμό του | “μπορεί να παρακάμψει τους κανόνες του robots.txt” |
Για να μπλοκάρετε ένα από αυτά, η σελίδα της Meta λέει να “προσθέσετε στο robots.txt έναν κανόνα disallow για το αντίστοιχο crawler”. Προειδοποιεί επίσης ότι τα crawlers “μπορεί να κρατούν στην προσωρινή μνήμη το περιεχόμενο του robots.txt έως και 24 ώρες”, άρα μια αλλαγή μπορεί να χρειαστεί μία ημέρα για να ισχύσει.
Το firewall ή το CDN σας (content delivery network, μια υπηρεσία όπως το Cloudflare που μπαίνει μπροστά από το site σας) μπορεί ήδη να αποφασίζει για εσάς. Το Cloudflare επιτρέπει στα sites να διαχειρίζονται τα crawlers AI ανά κατηγορία, και το changelog του αναφέρει ότι από τις 15 Σεπτεμβρίου 2026 μπλοκάρει από προεπιλογή τις κατηγορίες Training και Agent σε σελίδες με διαφημίσεις για νέα domains. Η λίστα bots του Cloudflare αναφέρει τα Meta-ExternalAgent και Meta-ExternalFetcher, αλλά όχι τα Meta-ExternalAds, Meta-WebIndexer ή FacebookExternalHit.
Τι παραμένει ασαφές;
Οι νέοι εμπορικοί όροι της Meta δεν αναφέρουν καθόλου το robots.txt. Η Meta λέει ότι οι κάτοχοι περιεχομένου μπορούν να συνεχίσουν να δείχνουν τις προτιμήσεις τους με το robots.txt. Το Search Engine Journal σημειώνει ότι δεν είναι σαφές αν ένας κανόνας στο robots.txt περιορίζει όσα παραχωρεί μια επιχείρηση με τους όρους. Παραθέτει επίσης έναν καθηγητή νομικής που εξηγεί ότι η τήρηση του robots.txt είναι εθελοντική για τα crawlers.
Η Meta δεν έχει ορίσει ποια URL θεωρούνται “συνδεδεμένα με τα προϊόντα ή τις υπηρεσίες σας”. Η σελίδα της για τα crawlers δεν λέει ότι κάποιο από τα πέντε συλλέγει πληροφορίες προϊόντων για καταλόγους και δεν δίνει διευθύνσεις IP με τις οποίες να ελέγξετε ότι ένας επισκέπτης προέρχεται πράγματι από τη Meta.
Τι σημαίνει για την επιχείρησή σας
Κατά τη γνώμη μας, οι νέοι όροι είναι καλή αφορμή να αποφασίσετε τι επιτρέπεται να κάνει κάθε crawler της Meta στο site σας. Εμείς θα το κάναμε με αυτή τη σειρά, πριν από τις 30 Οκτωβρίου, όταν οι νέοι όροι τίθενται σε ισχύ.
- Διαβάστε τους όρους που σας δείχνει η Meta. Ανοίξτε την προεπισκόπηση στη γλώσσα του λογαριασμού σας και βρείτε την παράγραφο για το αυτοματοποιημένο λογισμικό. Αν το περιεχόμενό σας είναι το προϊόν σας, για παράδειγμα άρθρα επί πληρωμή ή περιοχή μελών, ρωτήστε έναν δικηγόρο τι σημαίνει ο όρος για εσάς. Δεν είμαστε δικηγόροι και δεν δίνουμε νομικές συμβουλές.
- Ανοίξτε το robots.txt σας. Πηγαίνετε στο yourdomain.gr/robots.txt και αναζητήστε κανόνες που αναφέρουν τα crawlers της Meta, καθώς και κανόνα που μπλοκάρει όλα τα bots. Ένα γενικό μπλοκάρισμα που έμεινε από την ανάπτυξη κρύβει το site σας και από την αναζήτηση, όπως εξηγούμε στο άρθρο για έναν κανόνα robots.txt που έμεινε από την ανάπτυξη.
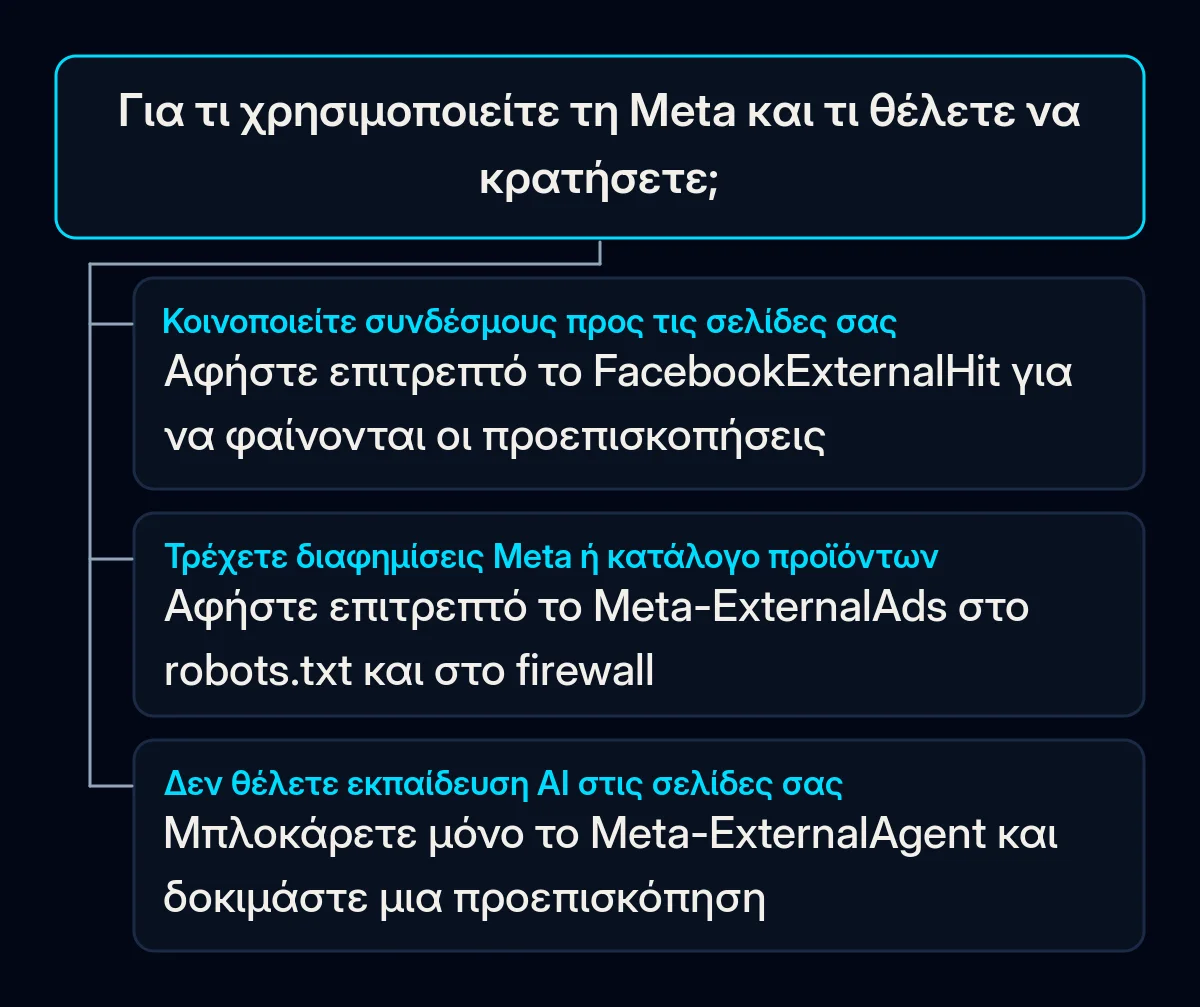
- Αποφασίστε για κάθε crawler χωριστά. Κρατήστε το FacebookExternalHit αν κοινοποιείτε συνδέσμους προς τις σελίδες σας. Κρατήστε το Meta-ExternalAds αν τρέχετε διαφημίσεις Meta ή κατάλογο προϊόντων. Επιτρέψτε το Meta-WebIndexer αν θέλετε το Meta AI να παραθέτει τις σελίδες σας. Μπλοκάρετε το Meta-ExternalAgent αν δεν θέλετε οι σελίδες σας να χρησιμοποιούνται για εκπαίδευση AI, έχοντας υπόψη ότι η νομική επίδραση ενός τέτοιου κανόνα στους όρους είναι ασαφής. Την ίδια λογική ακολουθούμε όταν αφήνουμε τους βοηθούς AI να διαβάζουν τις σελίδες προϊόντων.
- Ελέγξτε τι μπλοκάρει ήδη το firewall, το plugin ασφαλείας ή το CDN σας. Μην επιτρέπετε κάθε επισκέπτη που έχει “facebook” στο όνομά του. Στο δικό μας site έχουμε δει αιτήματα που χρησιμοποιούσαν το όνομα ενός crawler της Meta, έρχονταν από δίκτυα εκτός Meta και ζητούσαν αρχεία ρυθμίσεων. Η ανάγνωση των logs του crawling πριν γράψουμε νέους κανόνες είναι μέρος της δουλειάς μας στο τεχνικό SEO.
- Δοκιμάστε μια προεπισκόπηση συνδέσμου μετά από κάθε αλλαγή. Περιμένετε μία ημέρα για την προσωρινή μνήμη του robots.txt, μετά επικολλήστε τη διεύθυνση μιας σελίδας στο Sharing Debugger της Meta και ελέγξτε ότι εμφανίζονται ο τίτλος και η εικόνα. Τα tags Open Graph, που δίνουν αυτόν τον τίτλο και την εικόνα, είναι στη λίστα ελέγχου για την κατασκευή και έναρξη ιστοσελίδων με την οποία δουλεύουμε.
Αν κανείς δεν φροντίζει το robots.txt σας, ξεκινήστε σήμερα από το βήμα 2. Δείχνει αν τα crawlers της Meta επιτρέπονται αυτή τη στιγμή, μπλοκάρονται ή δεν αναφέρονται καθόλου.