Les nouvelles conditions Meta entrent en vigueur le 30 octobre 2026. La nouvelle version des Conditions commerciales (Commercial Terms) ajoute une clause qui permet à Meta d’utiliser des robots d’exploration (des programmes qui lisent automatiquement les pages web) sur les sites liés à votre entreprise, et d’y revenir pour récupérer les mises à jour. Les conditions couvrent tout usage professionnel des produits de Meta, comme Facebook et Instagram, même si vous gérez seulement une Page.
Selon PPC Land, continuer à utiliser Meta à des fins professionnelles après la notification de cette mise à jour par Meta vaut acceptation des nouvelles conditions. Avant le 30 octobre, décidez quels robots de Meta peuvent lire votre site et vérifiez que vos règles ne cassent pas les aperçus de liens.
Que changent les nouvelles conditions Meta le 30 octobre ?
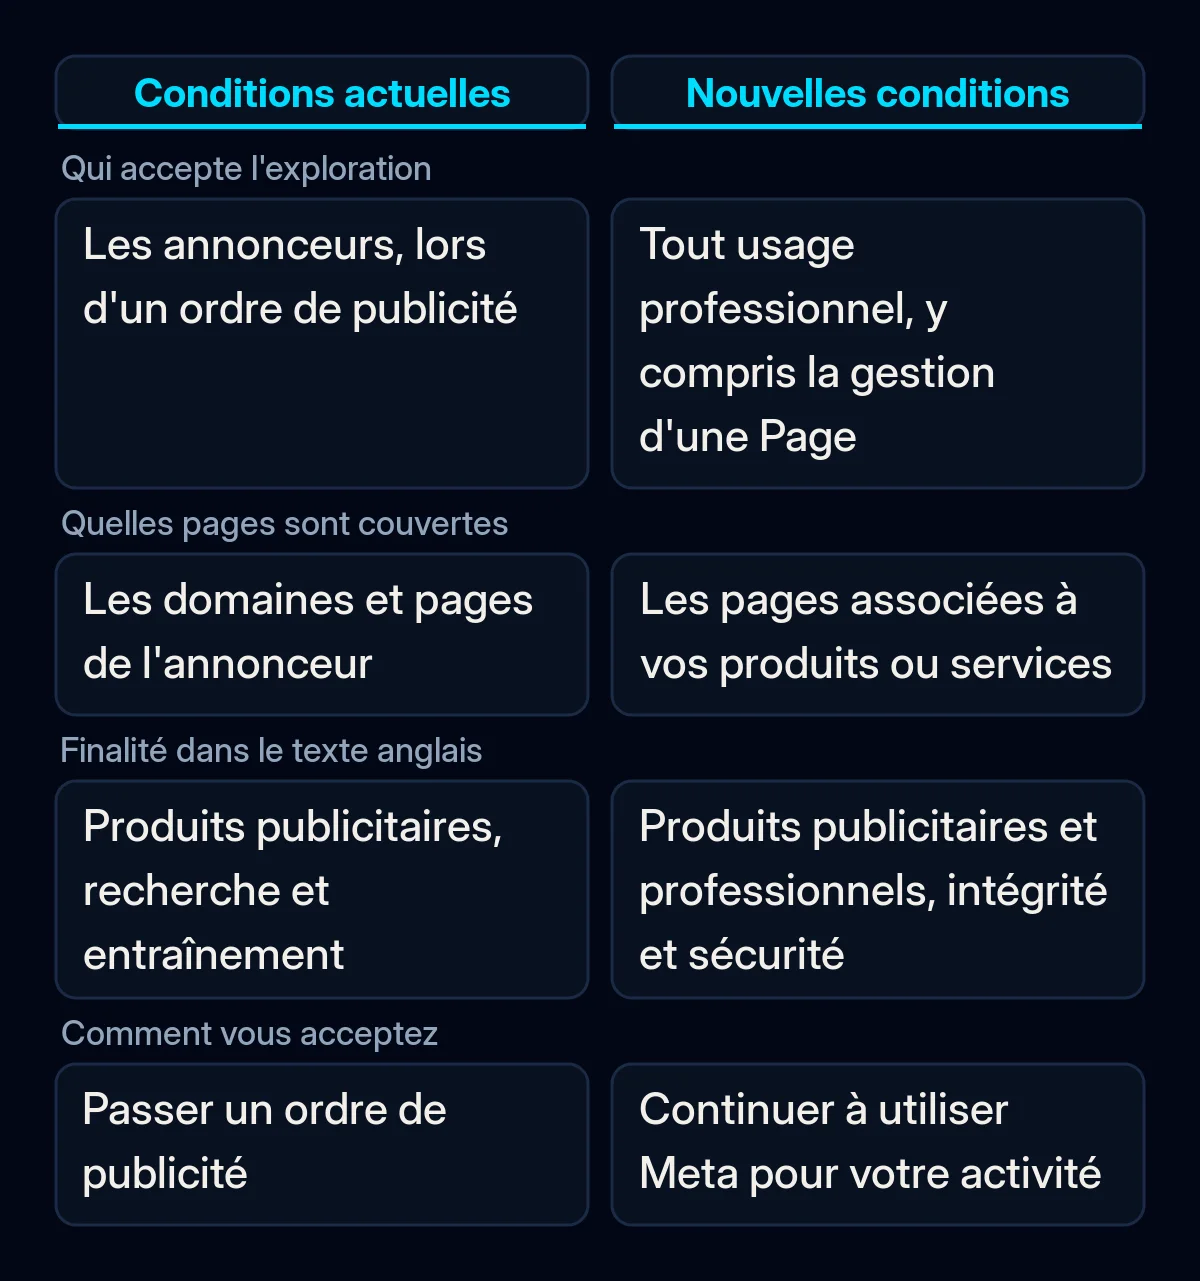
Les Conditions commerciales mises à jour ajoutent une clause d’exploration absente de la version en vigueur depuis le 6 mars 2024. L’aperçu des nouvelles conditions indique que vous autorisez Meta, ou toute personne agissant pour son compte, à utiliser des “logiciels automatisés (tels que des web scrapers, bots, robots, spiders, crawlers et user agents)”. Meta peut aussi “créer des identifiants de test”, c’est-à-dire des identifiants de connexion que Meta crée pour elle-même.
La clause couvre les domaines, pages web et URL “associés à vos produits ou services”, ainsi que les URL rendues accessibles par votre utilisation des produits de Meta ou par celle d’autres utilisateurs. Meta peut aussi “récupérer périodiquement des mises à jour”. Dans le texte anglais que nous avons lu le 20 octobre, les finalités indiquées sont les produits publicitaires et professionnels, ainsi que “l’intégrité et la sécurité des Produits des Sociétés Meta”.
Les conditions vont bien au-delà des annonceurs. Meta cite “la gestion d’une Page”, “la création ou l’utilisation d’un catalogue de produits” et l’utilisation de Meta Business Suite parmi les finalités professionnelles.
Les annonceurs ont déjà accordé quelque chose de comparable. Les Conditions actuelles des publicités en libre-service de Meta, en vigueur depuis le 22 août 2025, donnent déjà à Meta le droit d’explorer les domaines d’un annonceur, y compris pour “la recherche et l’entraînement”. L’aperçu des nouvelles conditions publicitaires contient la même clause.
Pourquoi Meta a-t-elle modifié le texte en une semaine ?
La première version publiée des nouvelles Conditions commerciales allait plus loin. Une phrase distincte indiquait que Meta pouvait utiliser le contenu des sites liés à une entreprise pour “fournir, développer, améliorer, rechercher, entraîner et préserver l’intégrité de” ses produits. PPC Land a cité cette phrase le 16 octobre, et des éditeurs et des juristes ont protesté, comme l’a rapporté Search Engine Journal.
Meta a ensuite retiré la finalité d’entraînement du texte en anglais américain. Search Engine Journal cite le porte-parole de Meta Daniel Roberts, qui a déclaré à The Verge que la nouvelle formulation est plus étroite. Selon ses mots, les conditions d’exploration “ne s’appliquaient qu’à nos produits publicitaires et professionnels, et nous l’avons précisé dans les conditions elles-mêmes”. Un autre porte-parole de Meta, Andy Stone, a déclaré, selon PPC Land : “Rien ne change dans la façon dont Meta utilise les robots d’exploration.”
PPC Land a retrouvé l’ancienne phrase dans l’aperçu en anglais britannique le 18 octobre, et Search Engine Journal la trouvait encore le 19 octobre dans l’aperçu en anglais britannique des conditions publicitaires. Quand nous avons lu les deux aperçus en anglais le 20 octobre, le mot “train” avait disparu. D’autres versions linguistiques peuvent encore être en retard : vérifiez le texte dans la langue de votre compte.
Tout le monde ne lit pas la nouvelle formulation comme plus étroite. L’avocat Matt Topic a déclaré, selon Search Engine Journal : “Je pense que ‘develop’ est assez large pour inclure ‘train’.”
Quels robots de Meta visitent votre site ?
Meta documente cinq robots sur sa page Meta Web Crawlers. Chacun envoie son propre nom, appelé user agent. Votre fichier robots.txt, le fichier texte qui indique aux robots les pages qu’ils peuvent lire, peut les traiter différemment, par exemple autoriser les aperçus de liens tout en bloquant l’entraînement de l’IA.
| Robot (user agent) | Ce qu’il fait selon Meta | Remarque de Meta |
|---|---|---|
| FacebookExternalHit | Lit les pages partagées dans les applications de Meta pour afficher un titre, une description et une image | “peut contourner le robots.txt” pour des contrôles de sécurité ou d’intégrité |
| Meta-ExternalAds | Améliore la publicité et les autres produits professionnels | Peut être bloqué dans le robots.txt |
| Meta-WebIndexer | Améliore les résultats de recherche de Meta AI, l’assistant IA de Meta | L’autoriser “nous aide à citer votre contenu et à renvoyer vers lui” |
| Meta-ExternalAgent | Entraînement de modèles d’IA de fondation ou indexation de contenu pour des produits | Peut être bloqué dans le robots.txt |
| Meta-ExternalFetcher | Récupère un lien à la demande d’un utilisateur, y compris quand un assistant IA ouvre une page pour lui | “peut contourner les règles du robots.txt” |
Pour bloquer l’un d’eux, la page de Meta indique d‘“ajouter un disallow pour le robot concerné dans le robots.txt”. Elle prévient aussi que les robots “peuvent mettre en cache le contenu du robots.txt jusqu’à 24 heures” : une modification peut donc mettre un jour à prendre effet.
Votre pare-feu ou votre CDN (réseau de diffusion de contenu, un service comme Cloudflare placé devant votre site) décide peut-être déjà pour vous. Cloudflare permet aux sites de gérer les robots d’IA par catégorie, et son changelog indique qu’il bloque par défaut les catégories Training et Agent sur les pages avec publicité des nouveaux domaines depuis le 15 septembre 2026. La liste de bots de Cloudflare mentionne Meta-ExternalAgent et Meta-ExternalFetcher, mais pas Meta-ExternalAds, Meta-WebIndexer ni FacebookExternalHit.
Qu’est-ce qui reste flou ?
Les nouvelles conditions Meta ne mentionnent pas du tout le robots.txt. Meta affirme que les propriétaires de contenu peuvent continuer à exprimer leurs préférences via le robots.txt. Search Engine Journal note qu’on ne sait pas si une règle du robots.txt limite ce qu’une entreprise accorde dans les conditions. Le média cite aussi un professeur de droit qui explique que le respect du robots.txt est volontaire pour les robots.
Meta n’a pas défini quelles URL comptent comme “associées à vos produits ou services”. Sa page sur les robots ne dit pas qu’un des cinq robots collecte des informations produit pour les catalogues, et elle ne donne aucune adresse IP permettant de vérifier qu’un visiteur vient vraiment de Meta.
Ce que cela signifie pour votre entreprise
À notre avis, les nouvelles conditions sont une bonne raison de décider ce que chaque robot de Meta peut faire sur votre site. Nous procéderions dans cet ordre, avant le 30 octobre, date d’entrée en vigueur des nouvelles conditions.
- Lisez les conditions que Meta vous affiche. Ouvrez l’aperçu dans la langue de votre compte et trouvez le paragraphe sur les logiciels automatisés. Si votre contenu est votre produit, par exemple des articles payants ou un espace membres, demandez à un avocat ce que la clause signifie pour vous. Nous ne sommes pas avocats et ne donnons pas de conseil juridique.
- Ouvrez votre robots.txt. Allez sur votredomaine.fr/robots.txt et cherchez les règles qui nomment les robots de Meta, ainsi qu’une règle qui bloque tous les bots. Un blocage large resté de la phase de développement cache aussi votre site des moteurs de recherche, comme nous l’expliquons dans pourquoi un site n’apparaît pas sur Google.
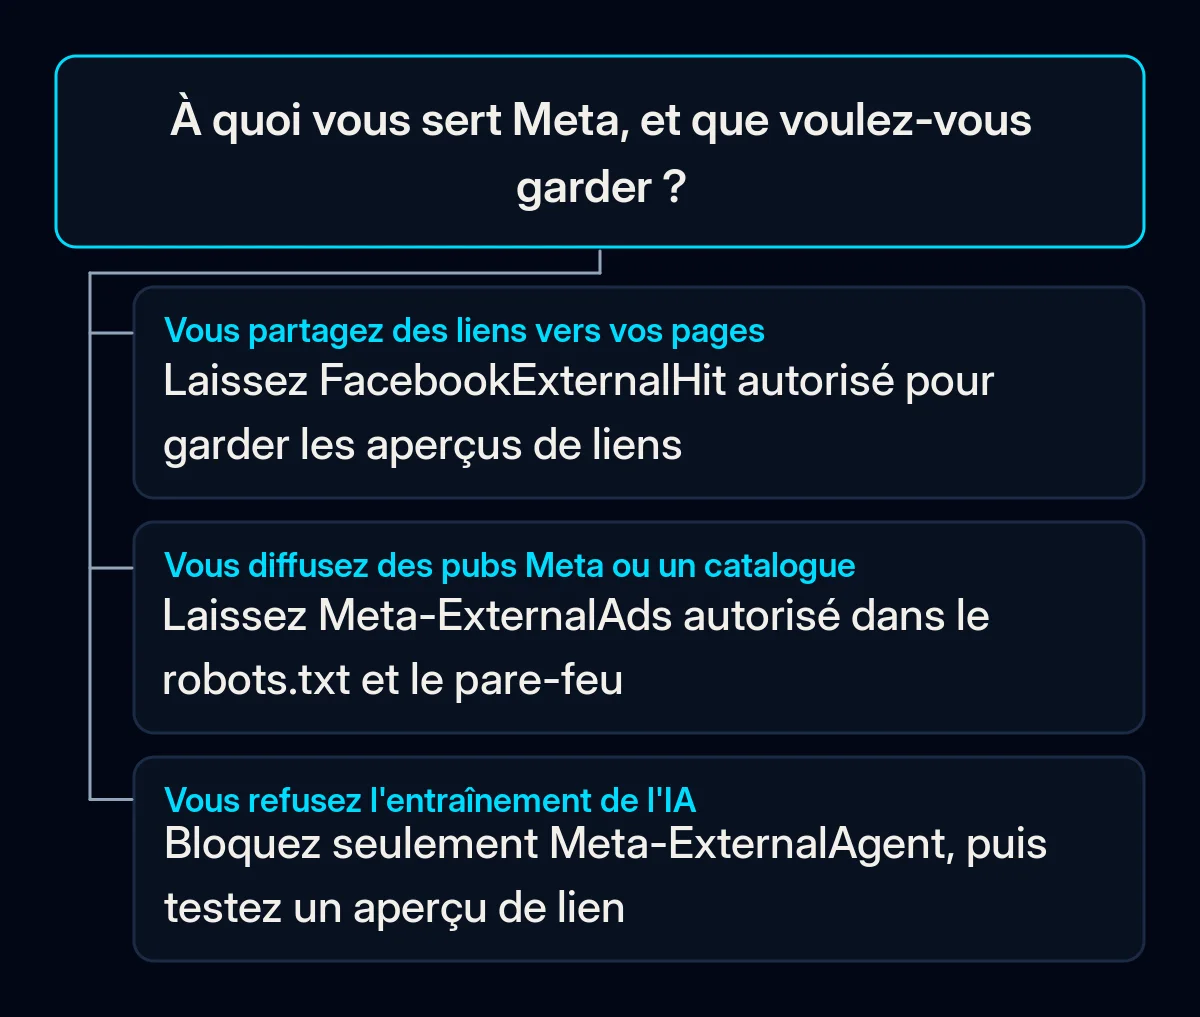
- Décidez robot par robot. Gardez FacebookExternalHit si vous partagez des liens vers vos pages. Gardez Meta-ExternalAds si vous diffusez des publicités Meta ou utilisez un catalogue de produits. Autorisez Meta-WebIndexer si vous voulez que Meta AI cite vos pages. Bloquez Meta-ExternalAgent si vous ne voulez pas que vos pages servent à entraîner l’IA, en gardant à l’esprit que l’effet juridique d’une telle règle sur les conditions reste flou. Nous suivons la même logique pour permettre aux assistants IA de lire vos fiches produits.
- Vérifiez ce que votre pare-feu, votre plugin de sécurité ou votre CDN bloque déjà. N’autorisez pas tout visiteur qui a “facebook” dans son nom. Sur notre propre site, nous avons vu des requêtes qui utilisaient le nom d’un robot de Meta, venaient de réseaux extérieurs à Meta et demandaient des fichiers de configuration. Lire les journaux d’exploration avant d’écrire de nouvelles règles fait partie de notre travail de SEO technique.
- Testez un aperçu de lien après chaque modification. Attendez un jour pour le cache du robots.txt, puis collez l’adresse d’une page dans le Sharing Debugger de Meta et vérifiez que le titre et l’image s’affichent. Les balises Open Graph, qui fournissent ce titre et cette image, figurent dans la checklist de lancement des projets de site web que nous suivons.
Si personne ne s’occupe de votre robots.txt, commencez aujourd’hui par l’étape 2. Elle montre si les robots de Meta sont actuellement autorisés, bloqués ou jamais mentionnés.