Os termos da Meta para uso comercial mudam a 30 de outubro de 2026. A nova versão acrescenta uma cláusula que permite à Meta usar crawlers (programas que leem páginas web automaticamente) nos sites ligados ao seu negócio e voltar para recolher atualizações. Os termos abrangem qualquer uso comercial dos produtos da Meta, como o Facebook e o Instagram, mesmo que se limite a gerir uma Página.
Segundo o PPC Land, continuar a usar a Meta para fins comerciais depois do aviso da Meta sobre a atualização conta como aceitação dos novos termos. Antes de 30 de outubro, decida quais dos crawlers da Meta podem ler o seu site e confirme que as suas regras não estragam as pré-visualizações de links.
O que muda nos termos da Meta a 30 de outubro?
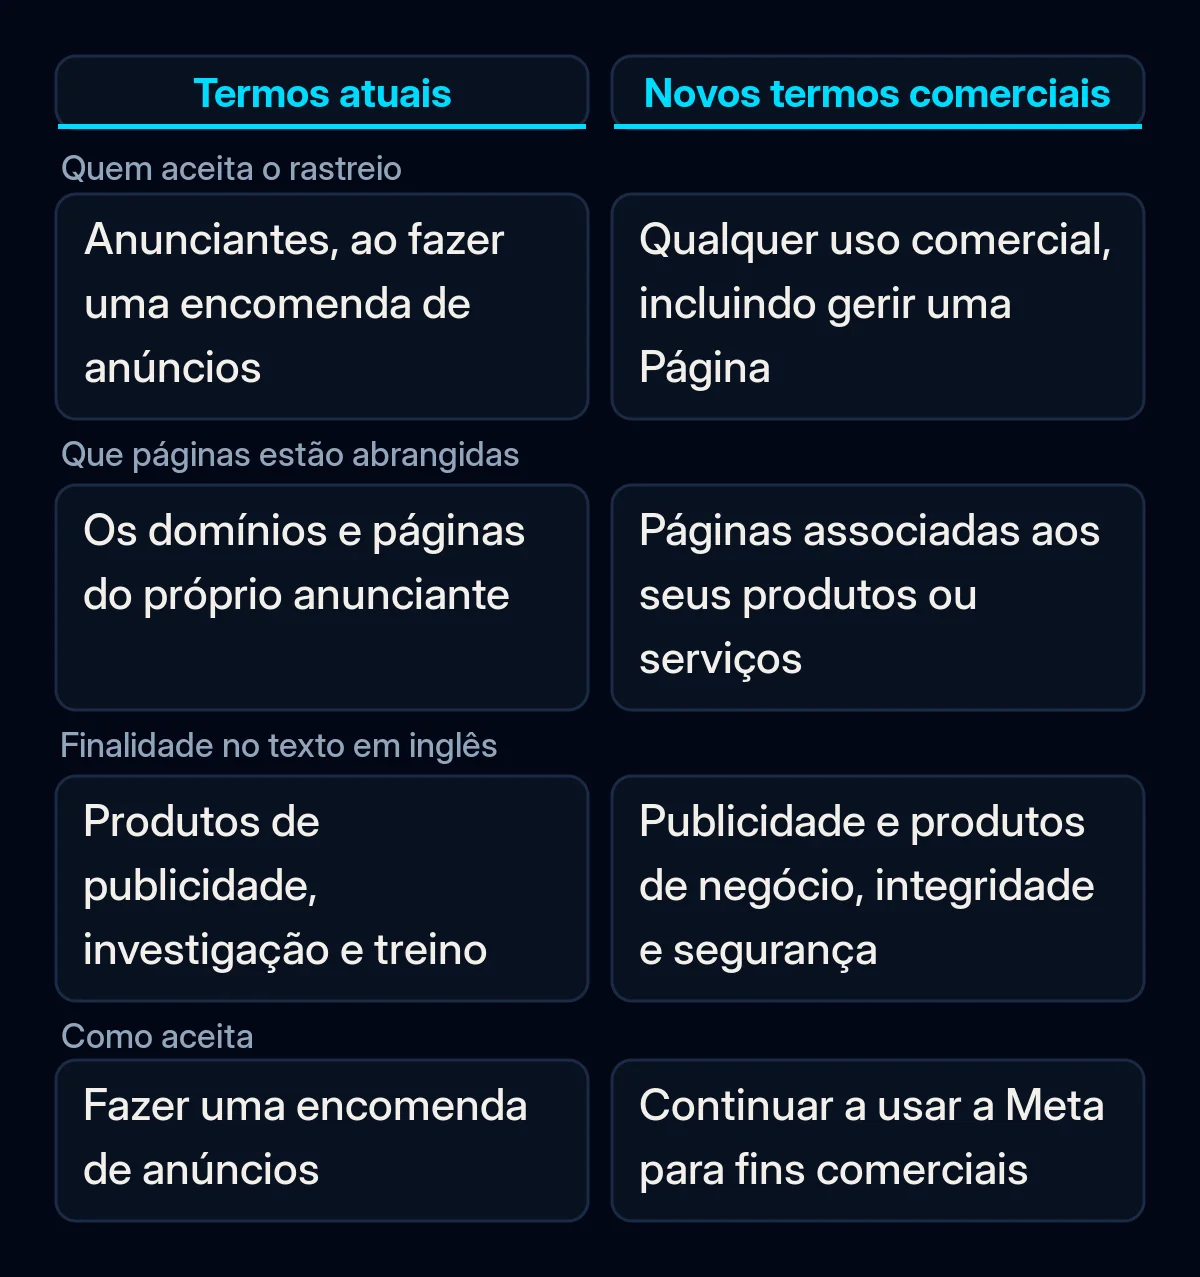
Os Termos Comerciais atualizados acrescentam uma cláusula de rastreio que a versão em vigor desde 6 de março de 2024 não tem. A pré-visualização dos novos termos diz que o utilizador autoriza a Meta, ou quem atue em seu nome, a usar “software automatizado (como web scrapers, bots, robôs, spiders, crawlers e user agents)”. A Meta pode também “criar credenciais de teste” (create test credentials), ou seja, dados de acesso que a própria Meta cria para si.
A cláusula abrange os domínios, páginas web e URL “associados aos seus produtos ou serviços”, bem como os URL disponibilizados através do uso dos produtos da Meta por si ou por outros utilizadores. A Meta pode ainda “obter atualizações periodicamente” desses endereços. No texto em inglês que lemos a 20 de outubro, as finalidades indicadas são os produtos de publicidade e de negócio e “a integridade e a segurança dos Produtos das Empresas Meta”.
Os termos vão muito além dos anunciantes. A Meta inclui “gerir uma Página”, “criar ou usar um catálogo de produtos” e o uso do Meta Business Suite entre as finalidades comerciais.
Os anunciantes já concederam algo parecido antes. Os atuais Termos de Publicidade Self-service da Meta, em vigor desde 22 de agosto de 2025, já dão à Meta o direito de rastrear os domínios de um anunciante, incluindo para “investigação e treino”. A pré-visualização dos novos termos de publicidade mantém a mesma cláusula.
Porque é que a Meta mudou a redação no espaço de uma semana?
A primeira versão publicada dos novos Termos Comerciais ia mais longe. Uma frase à parte dizia que a Meta podia usar conteúdo dos sites ligados a um negócio “para fornecer, desenvolver, melhorar, investigar, treinar e manter a integridade” dos seus produtos. O PPC Land citou essa frase a 16 de outubro, e editores e advogados contestaram-na, como relatou o Search Engine Journal.
A Meta retirou então a finalidade de treino do texto em inglês dos EUA. O Search Engine Journal cita o porta-voz da Meta Daniel Roberts, que disse ao The Verge que a nova redação é mais restrita. Nas suas palavras, os termos de rastreio “aplicavam-se apenas aos nossos produtos de publicidade e de negócio, e clarificámos isso nos próprios termos”. Outro porta-voz da Meta, Andy Stone, afirmou que “não há nenhuma mudança na forma como a Meta usa os web crawlers”, segundo o PPC Land.
O PPC Land encontrou a frase antiga na pré-visualização em inglês do Reino Unido a 18 de outubro, e o Search Engine Journal ainda a encontrou na pré-visualização dos termos de publicidade em inglês do Reino Unido a 19 de outubro. Quando lemos as duas pré-visualizações em inglês a 20 de outubro, a palavra “train” já não estava lá. Outras versões linguísticas podem continuar atrasadas, por isso verifique o texto no idioma da sua conta.
Nem todos leem a nova redação como mais restrita. O advogado Matt Topic disse “acho que ‘desenvolver’ é suficientemente amplo para incluir ‘treinar’”, segundo o Search Engine Journal.
Que crawlers da Meta visitam o seu site?
A Meta documenta cinco crawlers na sua página Meta Web Crawlers. Cada um envia o seu próprio nome, chamado user agent. O seu ficheiro robots.txt, o ficheiro de texto que diz aos crawlers que páginas podem ler, pode tratá-los de forma diferente, por exemplo permitindo as pré-visualizações de links e bloqueando o treino de IA.
| Crawler (user agent) | O que a Meta diz que faz | Nota da Meta |
|---|---|---|
| FacebookExternalHit | Lê as páginas partilhadas nas apps da Meta para mostrar título, descrição e imagem | “pode ignorar o robots.txt” em verificações de segurança ou integridade |
| Meta-ExternalAds | Melhora a publicidade e outros produtos de negócio | Pode ser bloqueado no robots.txt |
| Meta-WebIndexer | Melhora os resultados de pesquisa do Meta AI, o assistente de IA da Meta | Permiti-lo “ajuda-nos a citar o seu conteúdo e a criar links para ele” |
| Meta-ExternalAgent | Treino de modelos de IA de base, ou indexação de conteúdo para produtos | Pode ser bloqueado no robots.txt |
| Meta-ExternalFetcher | Vai buscar um link quando um utilizador o pede, incluindo quando um assistente de IA abre uma página por ele | “pode ignorar as regras do robots.txt” |
Para bloquear um deles, a página da Meta diz para “acrescentar um disallow para o crawler em causa no robots.txt”. Avisa também que os crawlers “podem guardar em cache o conteúdo do robots.txt até 24 horas”, por isso uma alteração pode demorar um dia a fazer efeito.
A sua firewall ou CDN (rede de distribuição de conteúdos, um serviço como a Cloudflare que fica à frente do seu site) pode já estar a decidir por si. A Cloudflare permite aos sites gerir os crawlers de IA por categoria, e o seu changelog diz que, desde 15 de setembro de 2026, bloqueia por predefinição as categorias Training e Agent nas páginas com anúncios dos novos domínios. A lista de bots da Cloudflare inclui o Meta-ExternalAgent e o Meta-ExternalFetcher, mas não o Meta-ExternalAds, o Meta-WebIndexer nem o FacebookExternalHit.
O que continua por esclarecer?
Os novos termos comerciais da Meta não mencionam o robots.txt. A Meta diz que os proprietários de conteúdo podem continuar a usar o robots.txt para indicar as suas preferências. O Search Engine Journal observa que não é claro se uma regra no robots.txt limita aquilo que um negócio concede nos termos. Cita também um professor de Direito que explica que respeitar o robots.txt é voluntário para os crawlers.
A Meta não definiu que URL contam como “associados aos seus produtos ou serviços”. A sua página sobre crawlers não diz que algum dos cinco recolhe informação de produtos para catálogos e não indica endereços IP para confirmar que um visitante vem realmente da Meta.
O que isto significa para o seu negócio
Na nossa opinião, os novos termos são uma boa razão para decidir o que cada crawler da Meta pode fazer no seu site. Nós fá-lo-íamos por esta ordem, antes de 30 de outubro, quando os novos termos entram em vigor.
- Leia os termos que a Meta lhe mostra. Abra a pré-visualização no idioma da sua conta e procure o parágrafo sobre software automatizado. Se o seu conteúdo é o seu produto, por exemplo artigos pagos ou uma área de membros, pergunte a um advogado o que a cláusula significa para si. Não somos advogados e não damos aconselhamento jurídico.
- Abra o seu robots.txt. Vá a oseudominio.pt/robots.txt e procure regras que mencionem os crawlers da Meta, bem como uma regra que bloqueie todos os bots. Um bloqueio geral esquecido desde a fase de desenvolvimento também esconde o site das pesquisas, como explicamos em porque é que o seu site não aparece no Google.
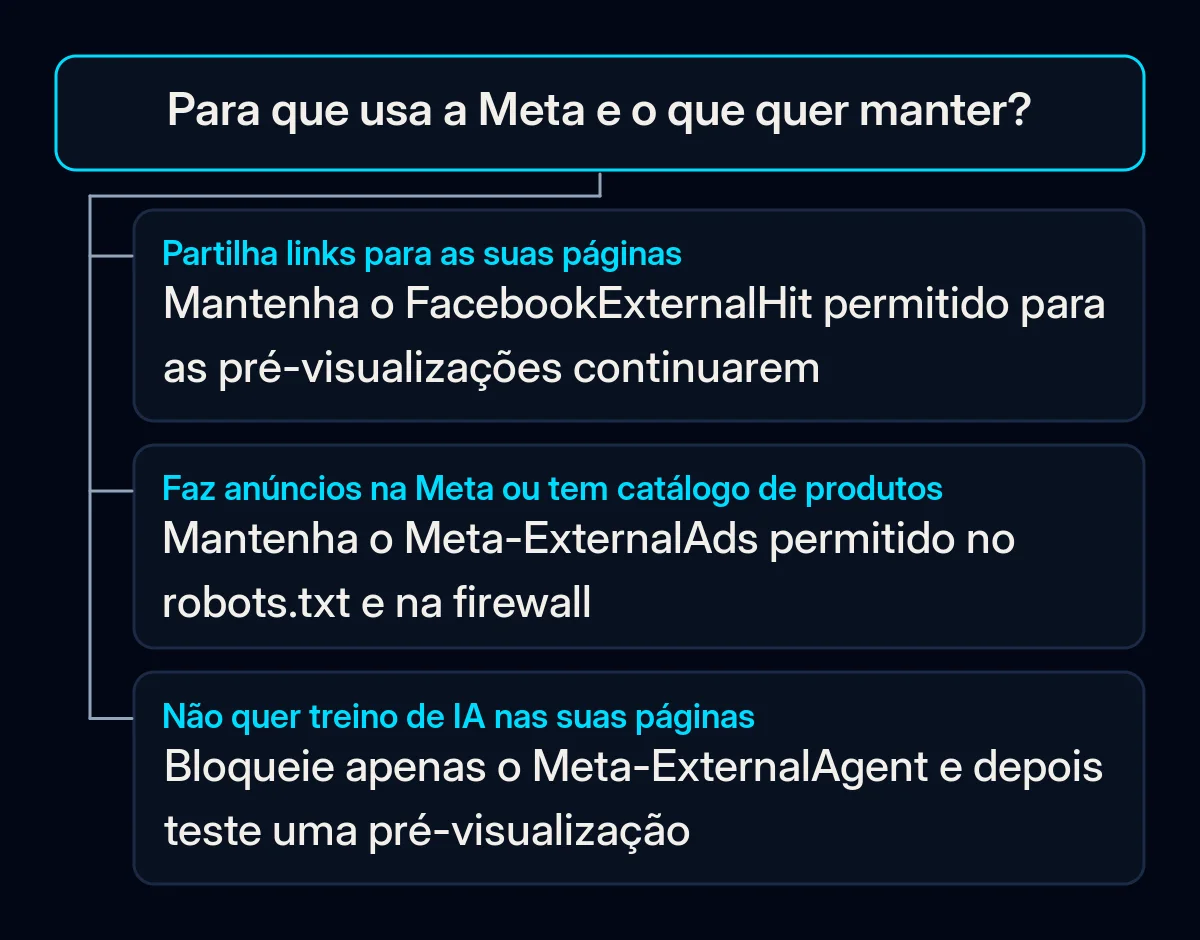
- Decida crawler a crawler. Mantenha o FacebookExternalHit se partilha links para as suas páginas. Mantenha o Meta-ExternalAds se faz anúncios na Meta ou tem um catálogo de produtos. Permita o Meta-WebIndexer se quer que o Meta AI cite as suas páginas. Bloqueie o Meta-ExternalAgent se não quer que as suas páginas sejam usadas para treino de IA, sabendo que o efeito jurídico dessa regra sobre os termos não é claro. Usamos a mesma lógica quando deixamos os assistentes de IA ler as suas páginas de produto.
- Verifique o que a sua firewall, plugin de segurança ou CDN já bloqueia. Não permita todos os visitantes que tenham “facebook” no nome. No nosso próprio site vimos pedidos que usavam o nome de um crawler da Meta, vinham de redes fora da Meta e pediam ficheiros de configuração. Ler os registos de rastreio antes de escrever novas regras faz parte do nosso trabalho de SEO técnico.
- Teste uma pré-visualização de link depois de qualquer alteração. Espere um dia pela cache do robots.txt, cole o endereço de uma página no Sharing Debugger da Meta e confirme que o título e a imagem aparecem. As tags Open Graph, que fornecem esse título e essa imagem, fazem parte da lista de verificação de lançamento dos projetos de sites que seguimos.
Se ninguém trata do seu robots.txt, comece hoje pelo passo 2. Ele mostra se os crawlers da Meta estão neste momento permitidos, bloqueados ou nem sequer mencionados.