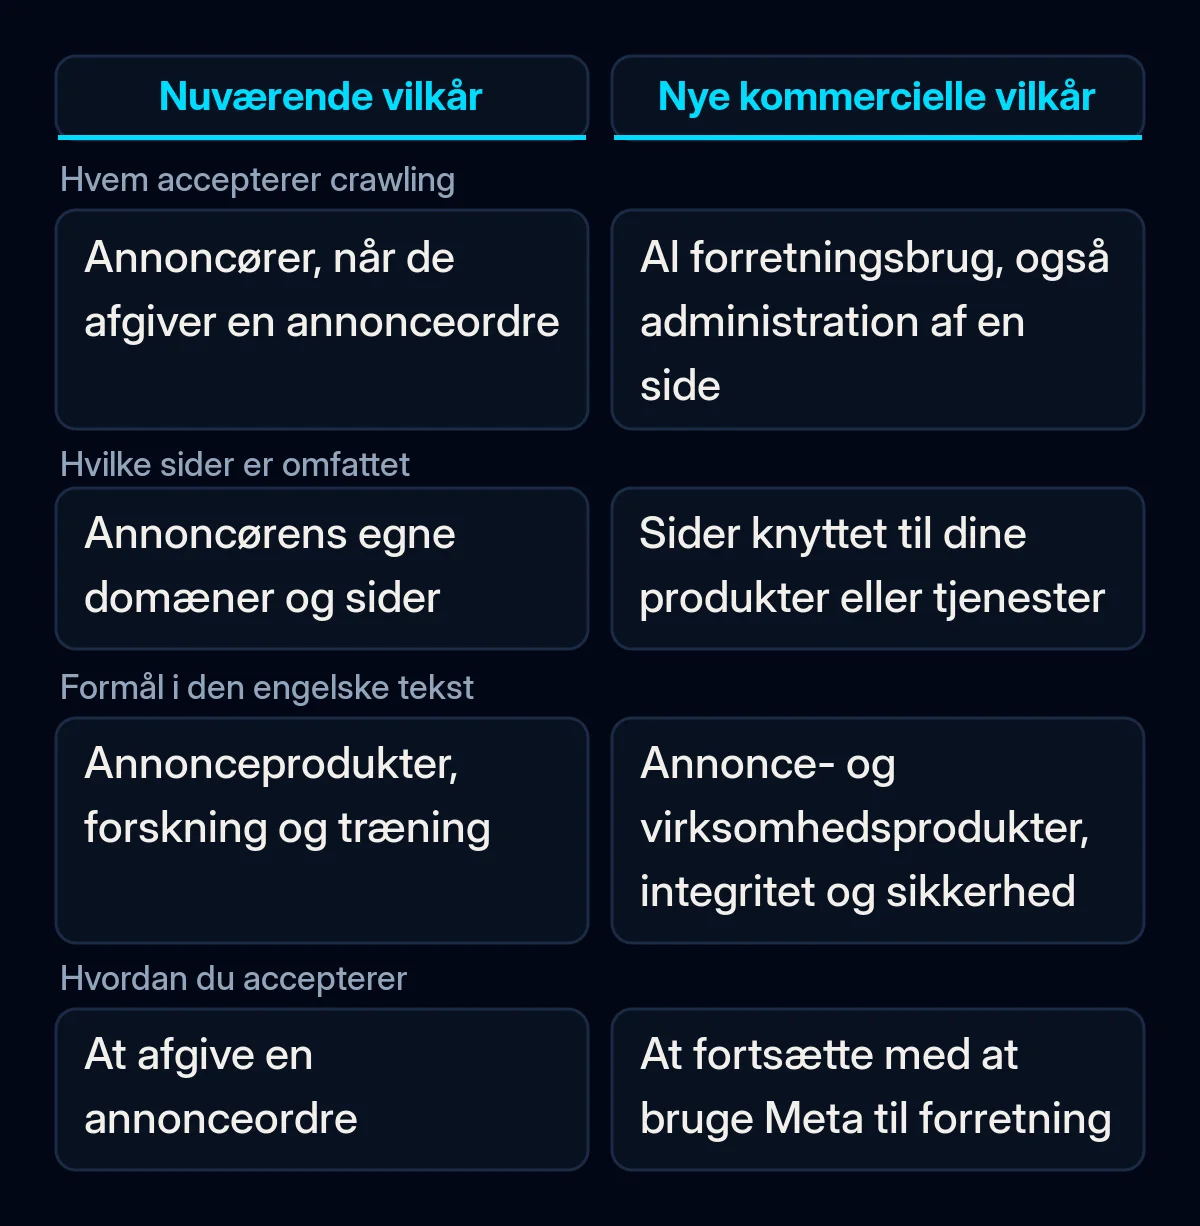
Metas nye vilkår for virksomheder gælder fra 30. oktober 2026. Den nye version tilføjer en klausul, der lader Meta bruge crawlere (programmer, der læser websider automatisk) på websites, der er knyttet til din virksomhed, og lader Meta vende tilbage for at hente opdateringer. Vilkårene dækker al forretningsmæssig brug af Metas produkter, som Facebook og Instagram, også selv om du kun administrerer en side.
Ifølge PPC Land tæller det som accept af de nye vilkår, hvis du fortsætter med at bruge Meta til forretning efter Metas meddelelse om opdateringen. Før den 30. oktober bør du beslutte, hvilke af Metas crawlere der må læse dit website, og tjekke, at dine regler ikke ødelægger linkforhåndsvisningerne.
Hvad ændrer sig i Metas nye vilkår den 30. oktober?
De opdaterede kommercielle vilkår (Commercial Terms) tilføjer en crawlingklausul, som versionen, der har gældt siden 6. marts 2024, ikke har. Forhåndsversionen af de nye vilkår siger, at du giver Meta, eller den, der handler på Metas vegne, ret til at bruge “automatiseret software (såsom web scrapers, bots, robotter, spiders, crawlere og user agents)”. Meta må også “oprette testlogins” (create test credentials), altså loginoplysninger, som Meta opretter til sig selv.
Klausulen dækker de domæner, websider og URL’er, “der er knyttet til dine produkter eller tjenester”, samt URL’er, der bliver tilgængelige, når du eller andre brugere bruger Metas produkter. Meta må også “jævnligt hente opdateringer” fra dem. I den engelske tekst, vi læste den 20. oktober, er de angivne formål annonce- og virksomhedsprodukter samt “integriteten og sikkerheden af Meta-virksomhedernes produkter”.
Vilkårene rækker langt ud over annoncører. Meta nævner “administration af en side”, “oprettelse eller brug af et produktkatalog” og brug af Meta Business Suite blandt forretningsformålene.
Annoncører har givet noget lignende før. Metas nuværende vilkår for selvbetjeningsannoncer, der har gældt siden 22. august 2025, giver allerede Meta ret til at crawle en annoncørs domæner, også til “forskning og træning”. Forhåndsversionen af de nye annoncevilkår indeholder samme klausul.
Hvorfor ændrede Meta formuleringen inden for en uge?
Den første offentliggjorte version af de nye kommercielle vilkår gik længere. En separat sætning sagde, at Meta må bruge indhold fra websites, der er knyttet til en virksomhed, “til at levere, udvikle, forbedre, forske i, træne og opretholde integriteten af” sine produkter. PPC Land citerede sætningen den 16. oktober, og udgivere og advokater protesterede, som Search Engine Journal rapporterede.
Meta fjernede derefter træningsformålet fra den amerikansk-engelske tekst. Search Engine Journal citerer Metas talsperson Daniel Roberts, som sagde til The Verge, at den nye formulering er snævrere. Med hans ord gjaldt crawlingvilkårene “kun vores annonce- og virksomhedsprodukter, og det har vi præciseret i selve vilkårene”. En anden talsperson for Meta, Andy Stone, sagde, at “der er ingen ændring i, hvordan Meta bruger webcrawlere”, ifølge PPC Land.
PPC Land fandt den gamle sætning i den britisk-engelske forhåndsversion den 18. oktober, og Search Engine Journal fandt den stadig i den britisk-engelske forhåndsversion af annoncevilkårene den 19. oktober. Da vi læste begge engelske forhåndsversioner den 20. oktober, var ordet “train” væk. Andre sprogversioner kan stadig halte bagefter, så tjek teksten på din kontos sprog.
Ikke alle læser den nye formulering som snævrere. Advokaten Matt Topic sagde “jeg mener, at ‘udvikle’ er bredt nok til at omfatte ‘træne’”, ifølge Search Engine Journal.
Hvilke Meta-crawlere besøger dit website?
Meta beskriver fem crawlere på sin side Meta Web Crawlers. Hver af dem sender sit eget navn, en såkaldt user agent. Din robots.txt-fil, tekstfilen, der fortæller crawlere, hvilke sider de må læse, kan behandle dem forskelligt, for eksempel tillade linkforhåndsvisninger, men blokere AI-træning.
| Crawler (user agent) | Hvad Meta siger, den gør | Bemærkning fra Meta |
|---|---|---|
| FacebookExternalHit | Læser sider, der deles i Metas apps, for at vise titel, beskrivelse og billede | “kan omgå robots.txt” ved sikkerheds- eller integritetstjek |
| Meta-ExternalAds | Forbedrer annoncering og andre virksomhedsprodukter | Kan blokeres i robots.txt |
| Meta-WebIndexer | Forbedrer søgeresultaterne i Meta AI, Metas AI-assistent | At tillade den “hjælper os med at citere og linke til dit indhold” |
| Meta-ExternalAgent | Træning af grundlæggende AI-modeller eller indeksering af indhold til produkter | Kan blokeres i robots.txt |
| Meta-ExternalFetcher | Henter et link, når en bruger beder om det, også når en AI-assistent åbner en side for brugeren | “kan omgå regler i robots.txt” |
For at blokere en af dem siger Metas side, at man skal “tilføje en disallow for den pågældende crawler i robots.txt”. Den advarer også om, at crawlere “kan cache indholdet af robots.txt i op til 24 timer”, så en ændring kan tage et døgn om at virke.
Din firewall eller dit CDN (content delivery network, en tjeneste som Cloudflare, der ligger foran dit website) bestemmer måske allerede for dig. Cloudflare lader websites styre AI-crawlere efter kategori, og ifølge Cloudflares changelog har den siden 15. september 2026 som standard blokeret kategorierne Training og Agent på sider med annoncer for nye domæner. Cloudflares botliste nævner Meta-ExternalAgent og Meta-ExternalFetcher, men ikke Meta-ExternalAds, Meta-WebIndexer eller FacebookExternalHit.
Hvad er stadig uklart?
Metas nye kommercielle vilkår nævner slet ikke robots.txt. Meta siger, at indholdsejere fortsat kan bruge robots.txt til at vise deres ønsker. Search Engine Journal påpeger, at det er uklart, om en regel i robots.txt begrænser, hvad en virksomhed giver Meta ret til i vilkårene. Mediet citerer også en jurprofessor, der forklarer, at det er frivilligt for crawlere at følge robots.txt.
Meta har ikke defineret, hvilke URL’er der tæller som “knyttet til dine produkter eller tjenester”. Metas side om crawlere siger ikke, at nogen af de fem indsamler produktoplysninger til kataloger, og den angiver ingen IP-adresser til at tjekke, at en besøgende virkelig kommer fra Meta.
Hvad det betyder for din virksomhed
Efter vores vurdering er de nye vilkår en god anledning til at beslutte, hvad hver Meta-crawler må gøre på dit website. Vi ville gøre det i denne rækkefølge, før den 30. oktober, hvor de nye vilkår træder i kraft.
- Læs de vilkår, Meta viser dig. Åbn forhåndsversionen på din kontos sprog, og find afsnittet om automatiseret software. Hvis dit indhold er dit produkt, for eksempel betalte artikler eller et medlemsområde, så spørg en advokat, hvad klausulen betyder for dig. Vi er ikke advokater og giver ikke juridisk rådgivning.
- Åbn din robots.txt. Gå til ditdomæne.dk/robots.txt, og se efter regler, der nævner Metas crawlere, og efter en regel, der blokerer alle bots. En bred blokering, der er blevet glemt fra udviklingen, skjuler også dit website i søgeresultaterne, som vi forklarer i hvorfor dit website ikke vises på Google.
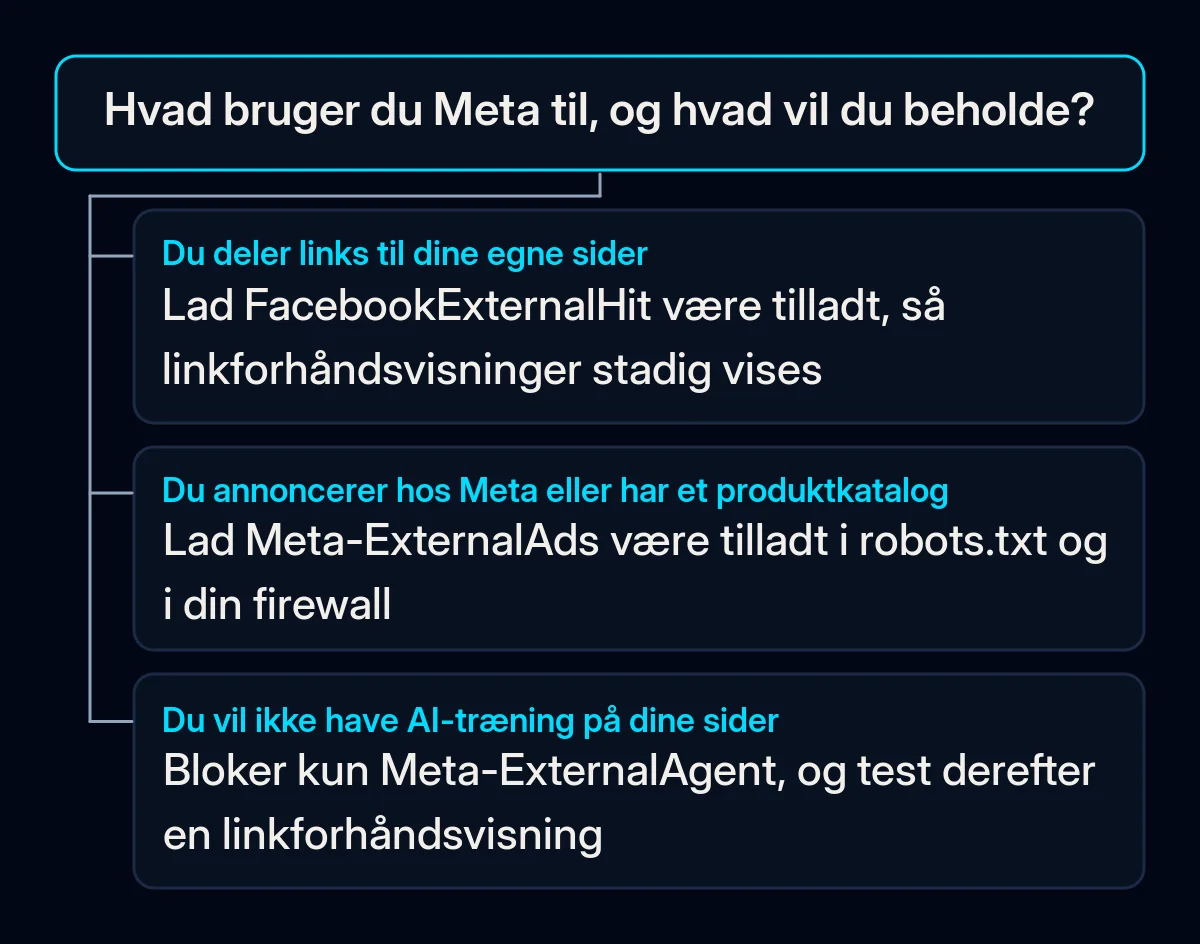
- Beslut crawler for crawler. Behold FacebookExternalHit, hvis du deler links til dine sider. Behold Meta-ExternalAds, hvis du annoncerer hos Meta eller har et produktkatalog. Tillad Meta-WebIndexer, hvis du vil have, at Meta AI citerer dine sider. Bloker Meta-ExternalAgent, hvis du ikke vil have, at dine sider bruges til AI-træning, men husk, at den juridiske virkning af sådan en regel på vilkårene er uklar. Vi bruger samme logik, når vi lader AI-assistenter læse dine produktsider.
- Tjek, hvad din firewall, dit sikkerhedsplugin eller dit CDN allerede blokerer. Lad ikke alle besøgende med “facebook” i navnet slippe igennem. På vores eget website har vi set forespørgsler, der brugte navnet på en Meta-crawler, kom fra netværk uden for Meta og bad om konfigurationsfiler. At læse crawllogs, før der skrives nye regler, er en del af vores arbejde med teknisk SEO.
- Test en linkforhåndsvisning efter hver ændring. Vent et døgn på robots.txt-cachen, sæt så en sideadresse ind i Metas Sharing Debugger, og tjek, at titlen og billedet vises. Open Graph-tags, som leverer den titel og det billede, står på den lanceringstjekliste for webprojekter, vi arbejder efter.
Hvis ingen holder øje med din robots.txt, så start med trin 2 i dag. Det viser, om Metas crawlere lige nu er tilladt, blokeret eller slet ikke nævnt.