Metas nya villkor för företag gäller från 30 oktober 2026. Den nya versionen lägger till en klausul som låter Meta använda crawlers (program som läser webbsidor automatiskt) på webbplatser som är kopplade till ditt företag, och låter Meta komma tillbaka för att hämta uppdateringar. Villkoren gäller all affärsmässig användning av Metas produkter, som Facebook och Instagram, även om du bara hanterar en sida.
Enligt PPC Land räknas det som att du godkänner de nya villkoren om du fortsätter att använda Meta i affärssyfte efter Metas meddelande om uppdateringen. Före den 30 oktober bör du bestämma vilka av Metas crawlers som får läsa din webbplats och kontrollera att dina regler inte förstör länkförhandsvisningarna.
Vad ändras i Metas nya villkor den 30 oktober?
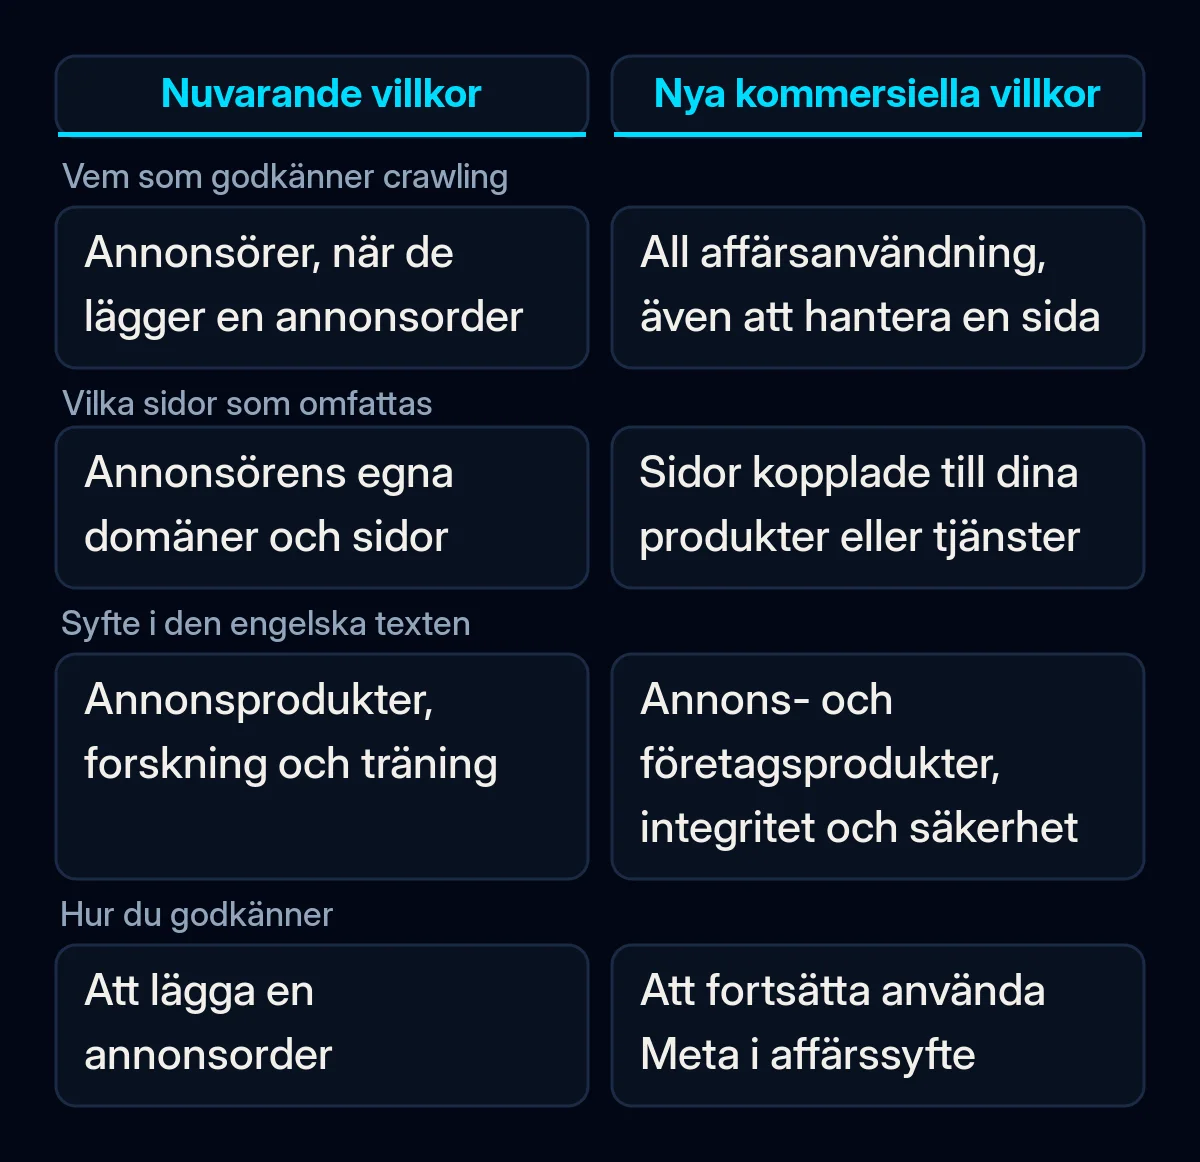
De uppdaterade kommersiella villkoren (Commercial Terms) lägger till en crawlingklausul som versionen som gällt sedan 6 mars 2024 saknar. Förhandsversionen av de nya villkoren säger att du ger Meta, eller den som agerar för Metas räkning, rätt att använda “automatiserad programvara (som web scrapers, botar, robotar, spiders, crawlers och user agents)”. Meta får också “skapa testinloggningar” (create test credentials), alltså inloggningsuppgifter som Meta skapar åt sig själv.
Klausulen omfattar de domäner, webbsidor och URL:er “som är kopplade till dina produkter eller tjänster”, samt URL:er som blir tillgängliga när du eller andra användare använder Metas produkter. Meta får också “regelbundet hämta uppdateringar” från dem. I den engelska text vi läste den 20 oktober är de angivna syftena annons- och företagsprodukter samt “integriteten och säkerheten för Meta-företagens produkter”.
Villkoren gäller långt fler än annonsörer. Meta räknar upp “att hantera en sida”, “att skapa eller använda en produktkatalog” och att använda Meta Business Suite bland affärsändamålen.
Annonsörer har gett liknande rättigheter tidigare. Metas nuvarande villkor för självbetjäningsannonser, som gäller sedan 22 augusti 2025, ger redan Meta rätt att crawla en annonsörs domäner, även för “forskning och träning”. Förhandsversionen av de nya annonsvillkoren innehåller samma klausul.
Varför ändrade Meta formuleringen inom en vecka?
Den första publicerade versionen av de nya kommersiella villkoren gick längre. En separat mening sa att Meta får använda innehåll från webbplatser kopplade till ett företag “för att tillhandahålla, utveckla, förbättra, forska kring, träna och upprätthålla integriteten hos” sina produkter. PPC Land citerade meningen den 16 oktober, och publicister och jurister protesterade, enligt Search Engine Journal.
Meta tog då bort träningssyftet ur den amerikanska engelska texten. Search Engine Journal citerar Metas talesperson Daniel Roberts, som sa till The Verge att den nya formuleringen är snävare. Med hans ord gällde crawlingvillkoren “bara våra annons- och företagsprodukter, och det har vi förtydligat i själva villkoren”. En annan talesperson för Meta, Andy Stone, sa att “det sker ingen förändring i hur Meta använder webbcrawlers”, enligt PPC Land.
PPC Land hittade den gamla meningen i den brittiska engelska förhandsversionen den 18 oktober, och Search Engine Journal hittade den fortfarande i den brittiska engelska förhandsversionen av annonsvillkoren den 19 oktober. När vi läste båda engelska förhandsversionerna den 20 oktober var ordet “train” borta. Andra språkversioner kan fortfarande ligga efter, så kontrollera texten på ditt kontos språk.
Alla läser inte den nya formuleringen som snävare. Juristen Matt Topic sa “jag tror att ‘utveckla’ är tillräckligt brett för att omfatta ‘träna’”, enligt Search Engine Journal.
Vilka Meta-crawlers besöker din webbplats?
Meta beskriver fem crawlers på sin sida Meta Web Crawlers. Var och en skickar sitt eget namn, en så kallad user agent. Din robots.txt-fil, textfilen som talar om för crawlers vilka sidor de får läsa, kan behandla dem olika, till exempel tillåta länkförhandsvisningar men blockera AI-träning.
| Crawler (user agent) | Vad Meta säger att den gör | Kommentar från Meta |
|---|---|---|
| FacebookExternalHit | Läser sidor som delas i Metas appar för att visa rubrik, beskrivning och bild | “kan kringgå robots.txt” vid säkerhets- eller integritetskontroller |
| Meta-ExternalAds | Förbättrar annonsering och andra företagsprodukter | Kan blockeras i robots.txt |
| Meta-WebIndexer | Förbättrar sökresultaten i Meta AI, Metas AI-assistent | Att tillåta den “hjälper oss att citera och länka till ditt innehåll” |
| Meta-ExternalAgent | Träning av grundläggande AI-modeller, eller indexering av innehåll för produkter | Kan blockeras i robots.txt |
| Meta-ExternalFetcher | Hämtar en länk när en användare ber om det, även när en AI-assistent öppnar en sida åt användaren | “kan kringgå regler i robots.txt” |
För att blockera en av dem säger Metas sida att man ska “lägga till en disallow för den aktuella crawlern i robots.txt”. Den varnar också för att crawlers “kan cacha innehållet i robots.txt i upp till 24 timmar”, så en ändring kan ta ett dygn att slå igenom.
Din brandvägg eller ditt CDN (content delivery network, en tjänst som Cloudflare som ligger framför din webbplats) kanske redan bestämmer åt dig. Cloudflare låter webbplatser hantera AI-crawlers per kategori, och enligt dess changelog blockerar Cloudflare sedan 15 september 2026 kategorierna Training och Agent som standard på sidor med annonser för nya domäner. Cloudflares botlista tar upp Meta-ExternalAgent och Meta-ExternalFetcher men inte Meta-ExternalAds, Meta-WebIndexer eller FacebookExternalHit.
Vad är fortfarande oklart?
Metas nya kommersiella villkor nämner inte robots.txt alls. Meta säger att innehållsägare kan fortsätta att använda robots.txt för att visa sina önskemål. Search Engine Journal påpekar att det är oklart om en regel i robots.txt begränsar vad ett företag godkänner i villkoren. Tidningen citerar också en juridikprofessor som förklarar att det är frivilligt för crawlers att följa robots.txt.
Meta har inte definierat vilka URL:er som räknas som “kopplade till dina produkter eller tjänster”. Metas sida om crawlers säger inte att någon av de fem samlar in produktinformation till kataloger, och den anger inga IP-adresser för att kontrollera att en besökare verkligen kommer från Meta.
Vad det betyder för ditt företag
Vi tycker att de nya villkoren är ett bra skäl att bestämma vad varje Meta-crawler får göra på din webbplats. Vi skulle göra det i den här ordningen, före den 30 oktober då de nya villkoren börjar gälla.
- Läs villkoren som Meta visar dig. Öppna förhandsversionen på ditt kontos språk och leta upp stycket om automatiserad programvara. Om ditt innehåll är din produkt, till exempel betalartiklar eller ett medlemsområde, fråga en jurist vad klausulen betyder för dig. Vi är inte jurister och ger ingen juridisk rådgivning.
- Öppna din robots.txt. Gå till dindoman.se/robots.txt och leta efter regler som nämner Metas crawlers, och efter en regel som blockerar alla botar. En bred blockering som blivit kvar från utvecklingen döljer också din webbplats i sökresultaten, som vi förklarar i varför webbplatsen inte syns på Google.
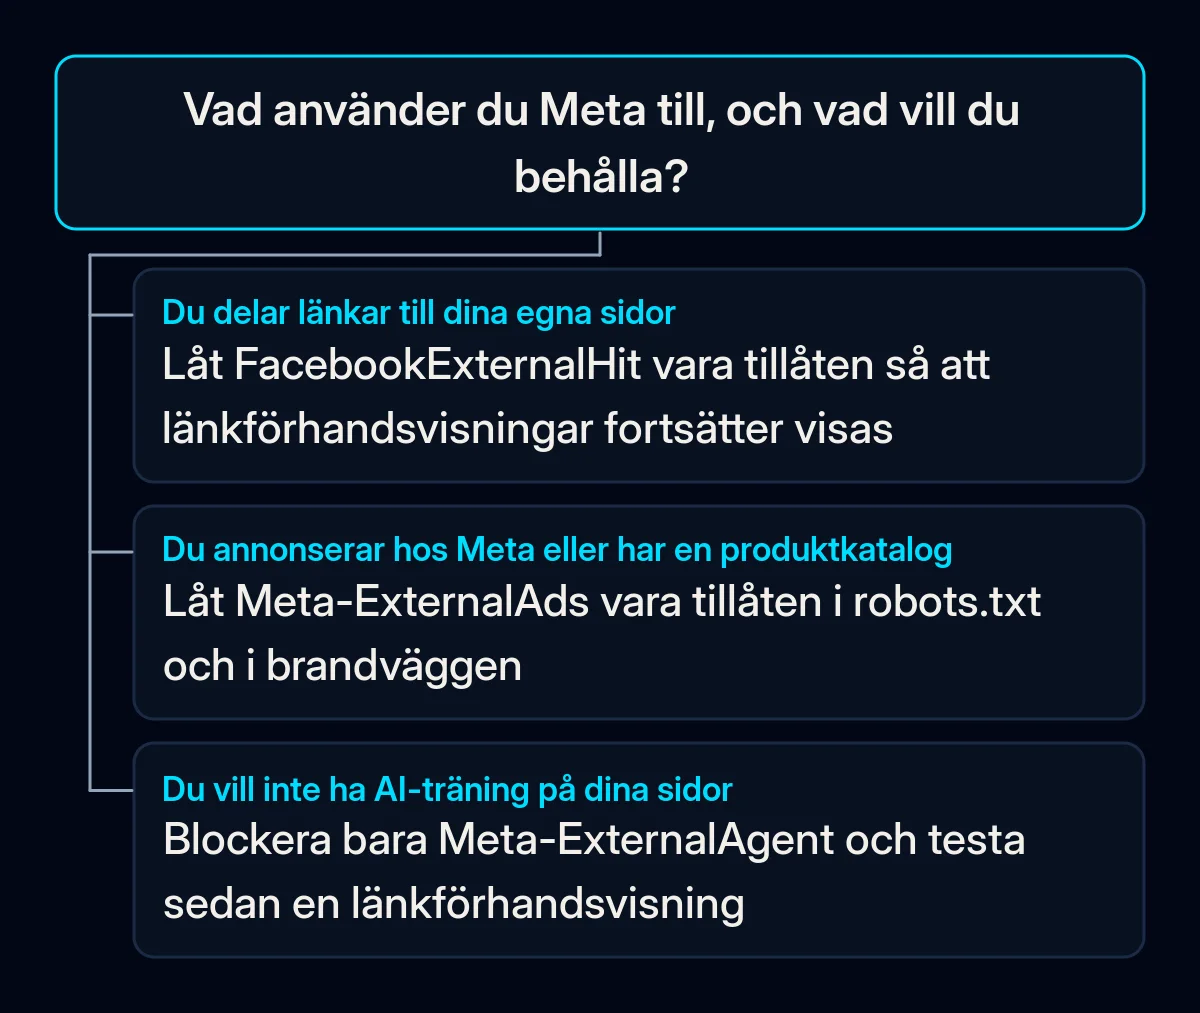
- Bestäm crawler för crawler. Behåll FacebookExternalHit om du delar länkar till dina sidor. Behåll Meta-ExternalAds om du annonserar hos Meta eller har en produktkatalog. Tillåt Meta-WebIndexer om du vill att Meta AI ska citera dina sidor. Blockera Meta-ExternalAgent om du inte vill att dina sidor används för AI-träning, men tänk på att en sådan regels rättsliga effekt på villkoren är oklar. Vi använder samma logik när vi låter AI-assistenter läsa dina produktsidor.
- Kontrollera vad din brandvägg, ditt säkerhetsplugin eller ditt CDN redan blockerar. Släpp inte in alla besökare som har “facebook” i namnet. På vår egen webbplats har vi sett förfrågningar som använde namnet på en Meta-crawler, kom från nätverk utanför Meta och bad om konfigurationsfiler. Att läsa crawlloggarna innan nya regler skrivs är en del av vårt arbete med teknisk SEO.
- Testa en länkförhandsvisning efter varje ändring. Vänta ett dygn på robots.txt-cachen, klistra sedan in en sidadress i Metas Sharing Debugger och kontrollera att rubriken och bilden visas. Open Graph-taggarna, som ger den rubriken och bilden, finns med i den lanseringschecklista för webbprojekt som vi arbetar efter.
Om ingen tar hand om din robots.txt, börja med steg 2 i dag. Det visar om Metas crawlers just nu är tillåtna, blockerade eller inte nämns alls.