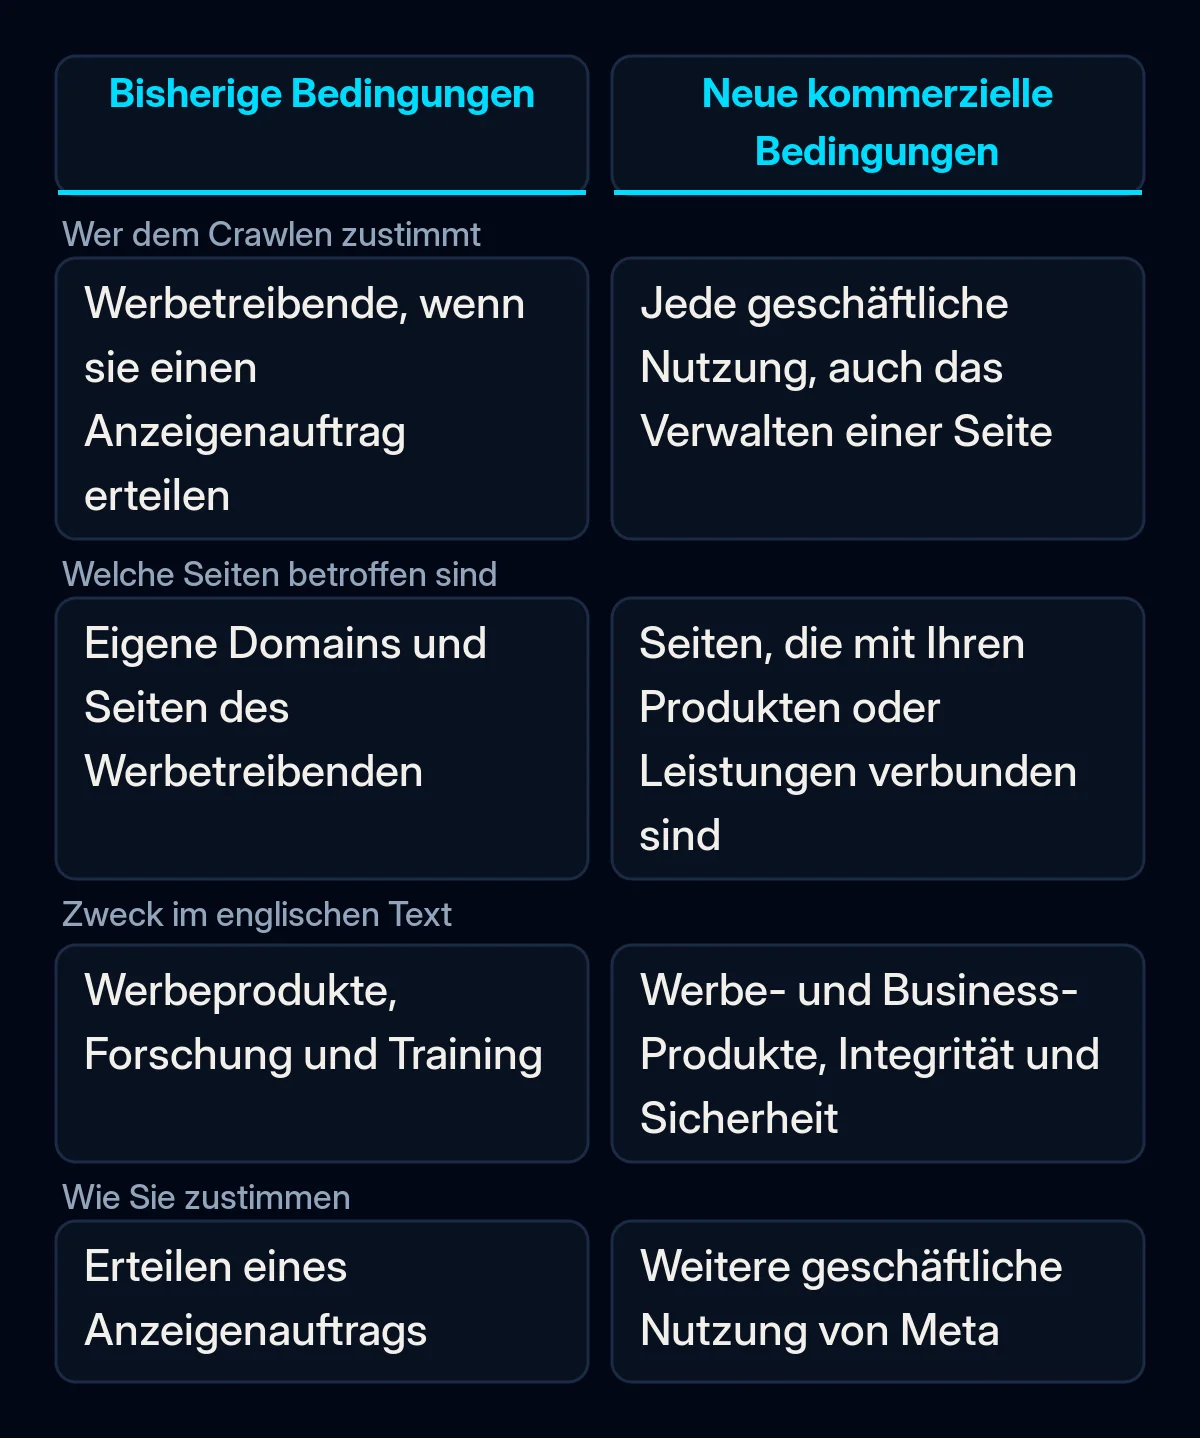
Die neuen Meta Bedingungen gelten ab dem 30. Oktober 2026. Die neue Fassung der kommerziellen Nutzungsbedingungen (Commercial Terms) enthält eine Klausel, nach der Meta Crawler (Programme, die Webseiten automatisch lesen) auf Websites einsetzen darf, die mit Ihrem Unternehmen verknüpft sind, und später für Aktualisierungen zurückkommen darf. Die Bedingungen gelten für jede geschäftliche Nutzung von Meta-Produkten wie Facebook und Instagram, auch wenn Sie nur eine Seite verwalten.
Laut PPC Land gilt die weitere geschäftliche Nutzung von Meta nach Metas Hinweis auf die Änderung als Zustimmung zu den neuen Bedingungen. Legen Sie vor dem 30. Oktober fest, welche Crawler von Meta Ihre Website lesen dürfen, und prüfen Sie, ob Ihre Regeln die Linkvorschau stören.
Was ändert sich an den Meta Bedingungen am 30. Oktober?
Die aktualisierten Commercial Terms enthalten eine Crawling-Klausel, die in der seit dem 6. März 2024 geltenden Fassung fehlt. Laut der Vorschau der neuen Bedingungen ermächtigen Sie Meta oder alle, die in seinem Auftrag handeln, “automatisierte Software (wie Web-Scraper, Bots, Roboter, Spider, Crawler und User Agents)” einzusetzen. Meta darf außerdem “Test-Zugangsdaten erstellen”, also Anmeldedaten, die Meta für sich selbst anlegt.
Die Klausel umfasst Domains, Webseiten und URLs, “die mit Ihren Produkten oder Dienstleistungen in Verbindung stehen”, sowie URLs, die durch Ihre Nutzung oder die anderer Nutzer von Meta-Produkten zugänglich werden. Meta darf zudem “regelmäßig Aktualisierungen abrufen”. Im englischen Text, den wir am 20. Oktober gelesen haben, sind die genannten Zwecke Werbe- und Business-Produkte sowie “die Integrität und Sicherheit der Produkte der Meta-Unternehmen”.
Die Bedingungen reichen weit über Werbetreibende hinaus. Meta zählt “die Verwaltung einer Seite”, “das Erstellen oder Nutzen eines Produktkatalogs” und die Nutzung der Meta Business Suite zu den geschäftlichen Zwecken.
Werbetreibende haben Ähnliches schon früher eingeräumt. Metas aktuelle Nutzungsbedingungen für Self-Service-Werbung, gültig seit dem 22. August 2025, geben Meta bereits das Recht, die Domains eines Werbetreibenden zu crawlen, auch für “Forschung und Training”. Die Vorschau der neuen Werbebedingungen enthält dieselbe Klausel.
Warum hat Meta den Wortlaut innerhalb einer Woche geändert?
Die erste veröffentlichte Fassung der neuen Commercial Terms ging weiter. Ein eigener Satz besagte, dass Meta Inhalte von Websites, die mit einem Unternehmen verknüpft sind, nutzen darf, um seine Produkte “bereitzustellen, zu entwickeln, zu verbessern, zu erforschen, zu trainieren und ihre Integrität zu wahren”. PPC Land zitierte diesen Satz am 16. Oktober, und Verlage sowie Juristen widersprachen, wie Search Engine Journal berichtete.
Meta strich daraufhin den Trainingszweck aus dem US-englischen Text. Search Engine Journal zitiert Meta-Sprecher Daniel Roberts, der The Verge sagte, die neue Formulierung sei enger. Mit seinen Worten galten die Crawling-Bedingungen “nur für unsere Werbe- und Business-Produkte, und das haben wir in den Bedingungen selbst klargestellt”. Ein weiterer Meta-Sprecher, Andy Stone, sagte laut PPC Land: “An der Art, wie Meta Web-Crawler einsetzt, ändert sich nichts.”
PPC Land fand den alten Satz am 18. Oktober in der britisch-englischen Vorschau, und Search Engine Journal fand ihn am 19. Oktober noch in der britisch-englischen Vorschau der Werbebedingungen. Als wir am 20. Oktober beide englischen Vorschauen lasen, war das Wort “train” verschwunden. Andere Sprachfassungen können noch hinterherhinken, prüfen Sie also den Text in der Sprache Ihres Kontos.
Nicht alle lesen die neue Formulierung als enger. Der Anwalt Matt Topic sagte laut Search Engine Journal: “Ich denke, ‘develop’ ist weit genug gefasst, um ‘train’ einzuschließen.”
Welche Meta-Crawler besuchen Ihre Website?
Meta dokumentiert fünf Crawler auf seiner Seite Meta Web Crawlers. Jeder sendet seinen eigenen Namen, den sogenannten User Agent. Ihre robots.txt, die Textdatei, die Crawlern sagt, welche Seiten sie lesen dürfen, kann sie unterschiedlich behandeln, zum Beispiel Linkvorschauen erlauben und gleichzeitig KI-Training blockieren.
| Crawler (User Agent) | Was er laut Meta tut | Hinweis von Meta |
|---|---|---|
| FacebookExternalHit | Liest in Metas Apps geteilte Seiten, um Titel, Beschreibung und Bild anzuzeigen | “kann robots.txt umgehen” bei Sicherheits- oder Integritätsprüfungen |
| Meta-ExternalAds | Verbessert Werbung und andere Business-Produkte | Lässt sich in robots.txt blockieren |
| Meta-WebIndexer | Verbessert die Suchergebnisse von Meta AI, Metas KI-Assistenten | Ihn zuzulassen “hilft uns, Ihre Inhalte zu zitieren und zu verlinken” |
| Meta-ExternalAgent | Training von KI-Basismodellen oder Indexierung von Inhalten für Produkte | Lässt sich in robots.txt blockieren |
| Meta-ExternalFetcher | Ruft einen Link ab, wenn ein Nutzer danach fragt, auch wenn ein KI-Assistent für ihn eine Seite öffnet | “kann robots.txt-Regeln umgehen” |
Um einen davon zu blockieren, sollen Sie laut Metas Seite “für den betreffenden Crawler ein Disallow in robots.txt ergänzen”. Sie warnt auch, dass Crawler “den Inhalt der robots.txt bis zu 24 Stunden zwischenspeichern können”, eine Änderung kann also einen Tag brauchen, bis sie wirkt.
Ihre Firewall oder Ihr CDN (Content Delivery Network, ein Dienst wie Cloudflare, der vor Ihrer Website sitzt) entscheidet womöglich schon für Sie. Cloudflare lässt Websites KI-Crawler nach Kategorien steuern, und laut Changelog blockiert Cloudflare seit dem 15. September 2026 standardmäßig die Kategorien Training und Agent auf Seiten mit Werbung für neue Domains. Cloudflares Bot-Liste nennt Meta-ExternalAgent und Meta-ExternalFetcher, aber nicht Meta-ExternalAds, Meta-WebIndexer oder FacebookExternalHit.
Was ist noch unklar?
Die neuen Meta Bedingungen erwähnen robots.txt überhaupt nicht. Meta sagt, Inhaber von Inhalten könnten ihre Präferenzen weiterhin über robots.txt zeigen. Search Engine Journal merkt an, dass unklar ist, ob eine robots.txt-Regel einschränkt, was ein Unternehmen in den Bedingungen gewährt. Das Medium zitiert außerdem einen Juraprofessor, der erklärt, dass die Beachtung von robots.txt für Crawler freiwillig ist.
Meta hat nicht definiert, welche URLs als “mit Ihren Produkten oder Dienstleistungen in Verbindung stehend” gelten. Seine Crawler-Seite sagt nicht, dass einer der fünf Crawler Produktinformationen für Kataloge sammelt, und sie nennt keine IP-Adressen, mit denen sich prüfen ließe, ob ein Besucher wirklich von Meta kommt.
Was das für Ihr Unternehmen bedeutet
Aus unserer Sicht sind die neuen Bedingungen ein guter Anlass, festzulegen, was jeder Meta-Crawler auf Ihrer Website darf. Wir würden in dieser Reihenfolge vorgehen, vor dem 30. Oktober, wenn die neuen Bedingungen in Kraft treten.
- Lesen Sie die Bedingungen, die Meta Ihnen anzeigt. Öffnen Sie die Vorschau in der Sprache Ihres Kontos und suchen Sie den Absatz zu automatisierter Software. Wenn Ihre Inhalte Ihr Produkt sind, etwa bezahlte Artikel oder ein Mitgliederbereich, fragen Sie einen Anwalt, was die Klausel für Sie bedeutet. Wir sind keine Anwälte und geben keine Rechtsberatung.
- Öffnen Sie Ihre robots.txt. Rufen Sie ihredomain.de/robots.txt auf und suchen Sie nach Regeln, die Metas Crawler nennen, und nach einer Regel, die alle Bots blockiert. Eine breite Sperre, die aus der Entwicklung übrig geblieben ist, versteckt Ihre Website auch vor der Suche, wie wir im Beitrag warum die Website nicht bei Google erscheint erklären.
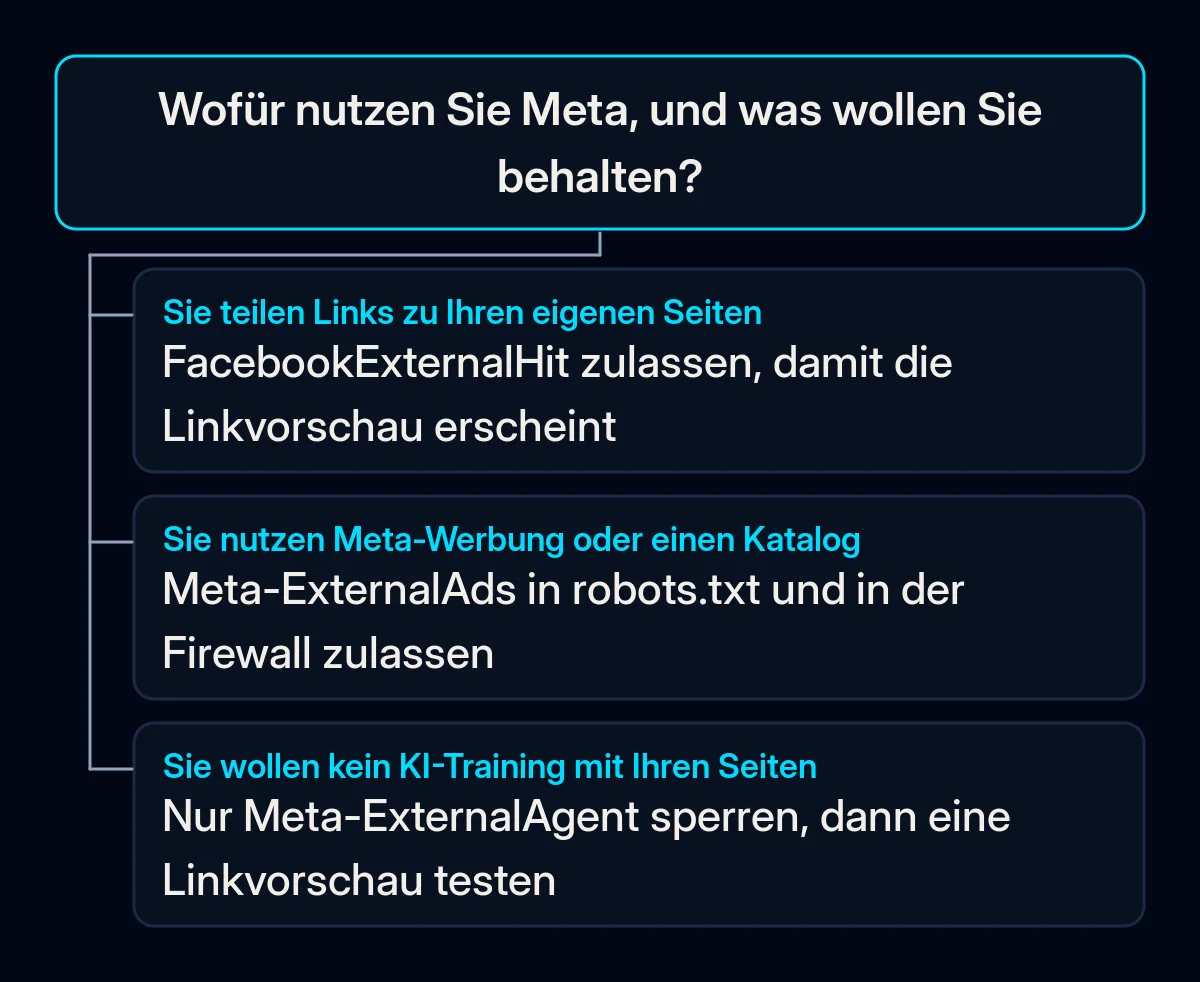
- Entscheiden Sie Crawler für Crawler. Behalten Sie FacebookExternalHit, wenn Sie Links zu Ihren Seiten teilen. Behalten Sie Meta-ExternalAds, wenn Sie Meta-Werbung schalten oder einen Produktkatalog nutzen. Lassen Sie Meta-WebIndexer zu, wenn Meta AI Ihre Seiten zitieren soll. Blockieren Sie Meta-ExternalAgent, wenn Ihre Seiten nicht für KI-Training genutzt werden sollen, und bedenken Sie, dass die rechtliche Wirkung einer solchen Regel auf die Bedingungen unklar ist. Dieselbe Logik nutzen wir, wenn wir KI-Assistenten Ihre Produktseiten lesen lassen.
- Prüfen Sie, was Ihre Firewall, Ihr Sicherheits-Plugin oder Ihr CDN bereits blockiert. Lassen Sie nicht jeden Besucher durch, der “facebook” im Namen trägt. Auf unserer eigenen Website haben wir Anfragen gesehen, die den Namen eines Meta-Crawlers nutzten, aus Netzen außerhalb von Meta kamen und Konfigurationsdateien abfragten. Crawl-Logs zu lesen, bevor neue Regeln entstehen, gehört zu unserer technischen SEO-Arbeit.
- Testen Sie nach jeder Änderung eine Linkvorschau. Warten Sie wegen des robots.txt-Caches einen Tag, fügen Sie dann eine Seitenadresse in Metas Sharing Debugger ein und prüfen Sie, ob Titel und Bild erscheinen. Open-Graph-Tags, die diesen Titel und dieses Bild liefern, stehen auf der Launch-Checkliste für Website-Projekte, nach der wir arbeiten.
Wenn sich niemand um Ihre robots.txt kümmert, beginnen Sie heute mit Schritt 2. Er zeigt, ob Metas Crawler derzeit erlaubt, blockiert oder gar nicht erwähnt sind.