Meta smluvní podmínky pro firmy, oficiálně obchodní podmínky Meta (Commercial Terms), se mění 30. října 2026. Nová verze přidává ustanovení, podle kterého smí Meta na webech spojených s vaší firmou používat roboty (programy, které automaticky čtou webové stránky) a vracet se pro aktualizace. Podmínky se vztahují na jakékoli obchodní používání produktů Meta, například Facebooku a Instagramu, i když spravujete jen stránku.
Podle PPC Land se další obchodní používání Mety poté, co Meta aktualizaci oznámí, počítá jako přijetí nových podmínek. Do 30. října se rozhodněte, které roboty Meta smějí váš web číst, a zkontrolujte, že vaše pravidla nerozbijí náhledy odkazů.
Meta smluvní podmínky: co se mění 30. října?
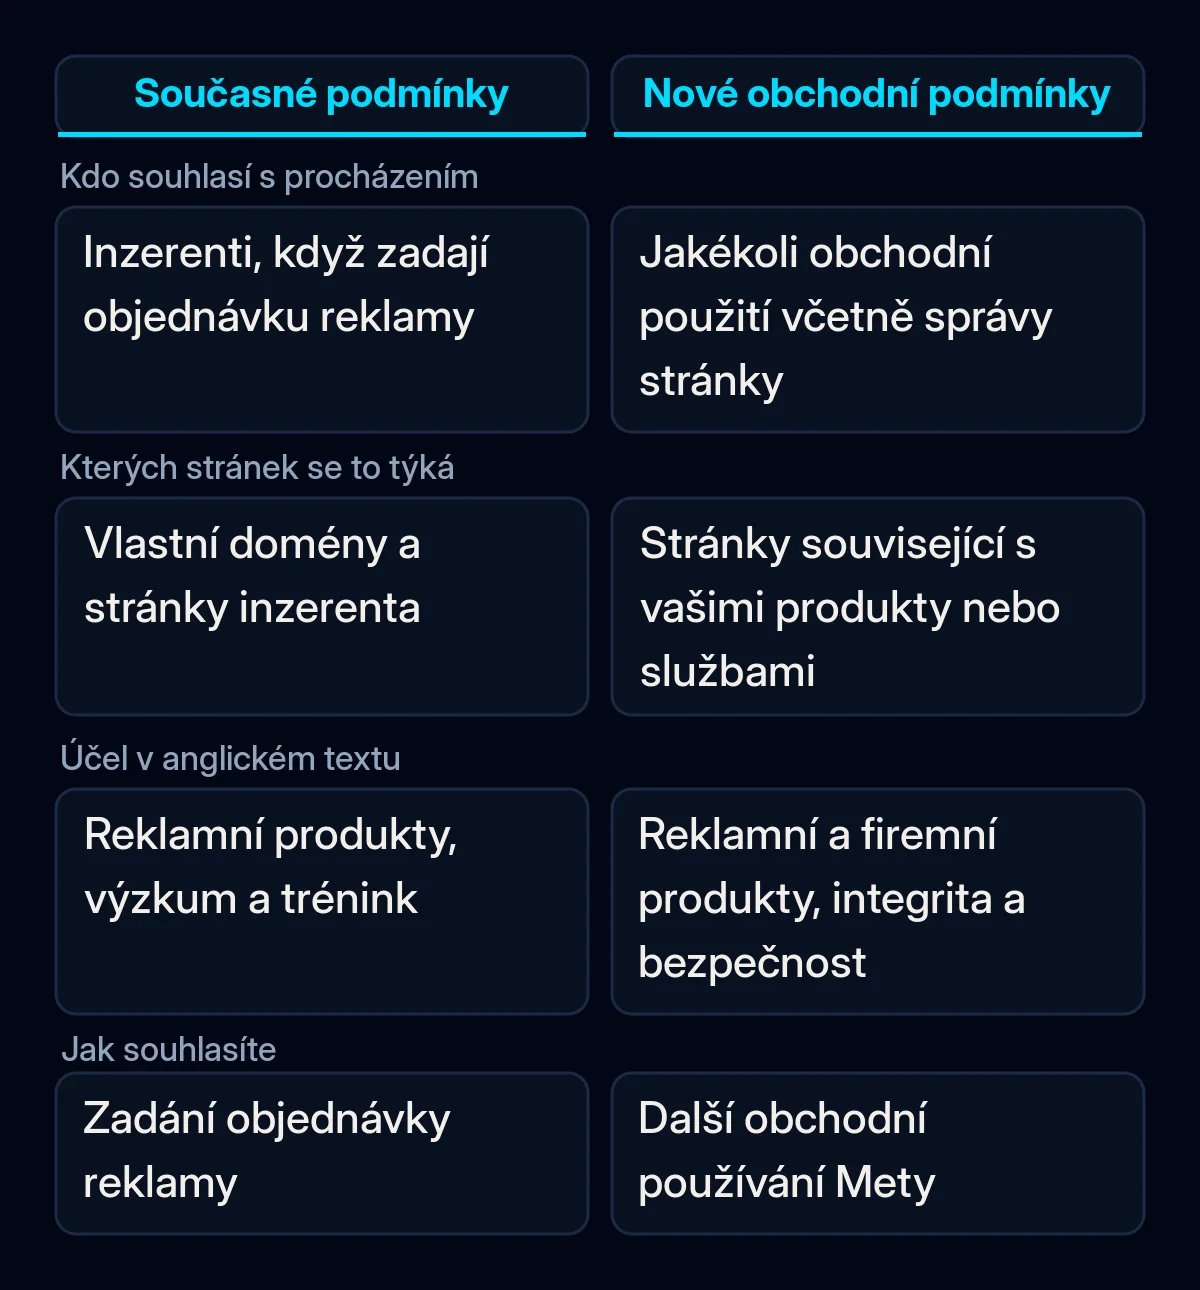
Aktualizované obchodní podmínky přidávají ustanovení o procházení webu, které verze platná od 6. března 2024 nemá. Náhled nových podmínek uvádí, že Metu nebo kohokoli, kdo jedná jejím jménem, opravňujete používat (v našem překladu) “automatizovaný software (například web scrapery, boty, roboty, pavouky, crawlery a user agenty)”. Meta také smí “vytvářet testovací přihlašovací údaje” (create test credentials), tedy přístupy, které si Meta založí sama.
Ustanovení se týká domén, webových stránek a URL, “které souvisejí s vašimi produkty nebo službami”, a také URL zpřístupněných tím, že vy nebo jiní uživatelé používáte produkty Meta. Meta z nich také smí “pravidelně stahovat aktualizace”. V anglickém textu, který jsme četli 20. října, jsou uvedenými účely reklamní a firemní produkty a “integrita a bezpečnost produktů společností Meta”.
Podmínky sahají daleko za inzerenty. Meta mezi obchodní účely řadí “správu stránky”, “vytváření nebo používání katalogu produktů” i používání Meta Business Suite.
Inzerenti už podobné oprávnění udělovali. Současné podmínky samoobslužné reklamy Meta (Self-serve Ad Terms), platné od 22. srpna 2025, dávají Metě právo procházet domény inzerenta, a to i pro “výzkum a trénink”. Náhled nových reklamních podmínek obsahuje stejné ustanovení.
Proč Meta změnila znění během týdne?
První zveřejněná verze nových obchodních podmínek šla ještě dál. Samostatná věta uváděla, že Meta smí obsah z webů spojených s firmou používat “k poskytování, vývoji, zlepšování, výzkumu, tréninku a udržování integrity” svých produktů. PPC Land tuto větu citoval 16. října a vydavatelé i právníci se proti ní ohradili, jak informoval Search Engine Journal.
Meta pak účel tréninku z amerického anglického textu odstranila. Search Engine Journal cituje mluvčího Mety Daniela Robertse, který serveru The Verge řekl, že nové znění je užší. Podle jeho slov se podmínky procházení “vztahovaly jen na naše reklamní a firemní produkty a v samotných podmínkách jsme to upřesnili”. Další mluvčí Mety, Andy Stone, podle PPC Land řekl, že “na tom, jak Meta používá webové roboty, se nic nemění”.
PPC Land našel starou větu v britském anglickém náhledu 18. října a Search Engine Journal ji 19. října stále našel v britském anglickém náhledu reklamních podmínek. Když jsme 20. října četli oba anglické náhledy, slovo “train” v nich už nebylo. Jiné jazykové verze mohou ještě zaostávat, proto si text zkontrolujte v jazyce svého účtu.
Ne všichni ale nové znění čtou jako užší. Právník Matt Topic podle Search Engine Journal řekl: “Myslím, že ‘vývoj’ je dost široký pojem, aby zahrnoval i ‘trénink’.”
Kteří roboti Meta navštěvují váš web?
Meta na stránce Meta Web Crawlers popisuje pět robotů. Každý posílá vlastní jméno, kterému se říká user agent. Soubor robots.txt, tedy textový soubor, který robotům říká, jaké stránky smějí číst, s nimi může zacházet různě, například povolit náhledy odkazů a zároveň zablokovat trénink AI.
| Robot (user agent) | Co podle Mety dělá | Poznámka Mety |
|---|---|---|
| FacebookExternalHit | Čte stránky sdílené v aplikacích Meta, aby zobrazil název, popis a obrázek | “může obejít robots.txt” při kontrolách bezpečnosti nebo integrity |
| Meta-ExternalAds | Zlepšuje reklamu a další firemní produkty | Lze zablokovat v robots.txt |
| Meta-WebIndexer | Zlepšuje výsledky vyhledávání v Meta AI, asistentovi Mety s umělou inteligencí | Jeho povolení “nám pomáhá citovat váš obsah a odkazovat na něj” |
| Meta-ExternalAgent | Trénink základních modelů AI nebo indexování obsahu pro produkty | Lze zablokovat v robots.txt |
| Meta-ExternalFetcher | Stáhne odkaz, když o to uživatel požádá, včetně situace, kdy pro něj stránku otevírá asistent AI | “může obejít pravidla robots.txt” |
Pokud chcete některého z nich zablokovat, stránka Mety radí “přidat do robots.txt pravidlo disallow pro příslušného robota”. Upozorňuje také, že roboti “mohou obsah robots.txt ukládat do mezipaměti až na 24 hodin”, takže změna se může projevit až za den.
Váš firewall nebo CDN (síť pro doručování obsahu, služba jako Cloudflare, která stojí před vaším webem) už možná rozhoduje za vás. Cloudflare umožňuje spravovat roboty AI podle kategorií a podle jeho changelogu od 15. září 2026 ve výchozím stavu blokuje kategorie Training a Agent na stránkách s reklamou u nových domén. Seznam robotů Cloudflare uvádí Meta-ExternalAgent a Meta-ExternalFetcher, ale ne Meta-ExternalAds, Meta-WebIndexer ani FacebookExternalHit.
Co je zatím nejasné?
Nové obchodní podmínky Meta robots.txt vůbec nezmiňují. Meta říká, že vlastníci obsahu mohou dál vyjadřovat své preference v robots.txt. Search Engine Journal upozorňuje, že není jasné, zda pravidlo v robots.txt omezuje to, co firma v podmínkách uděluje. Cituje také profesora práva, který vysvětluje, že respektování robots.txt je pro roboty dobrovolné.
Meta nedefinovala, které URL se počítají za “související s vašimi produkty nebo službami”. Její stránka o robotech neuvádí, že by kterýkoli z pěti robotů sbíral informace o produktech pro katalogy, a neuvádí ani IP adresy, podle kterých by šlo ověřit, že návštěvník opravdu přichází od Mety.
Co to znamená pro vaši firmu
Podle nás jsou nové podmínky dobrým důvodem rozhodnout, co smí každý robot Meta na vašem webu dělat. My bychom postupovali v tomto pořadí, a to do 30. října, kdy nové podmínky začnou platit.
- Přečtěte si podmínky, které vám Meta zobrazí. Otevřete náhled v jazyce svého účtu a najděte odstavec o automatizovaném softwaru. Pokud je vaším produktem samotný obsah, například placené články nebo členská sekce, zeptejte se právníka, co pro vás ustanovení znamená. Nejsme právníci a právní poradenství neposkytujeme.
- Otevřete svůj robots.txt. Přejděte na vasedomena.cz/robots.txt a hledejte pravidla, která jmenují roboty Meta, i pravidlo, které blokuje všechny roboty. Plošný zákaz, který zůstal z vývoje, skryje web i před vyhledávači, jak vysvětlujeme v článku pravidlo v robots.txt zapomenuté z vývoje.
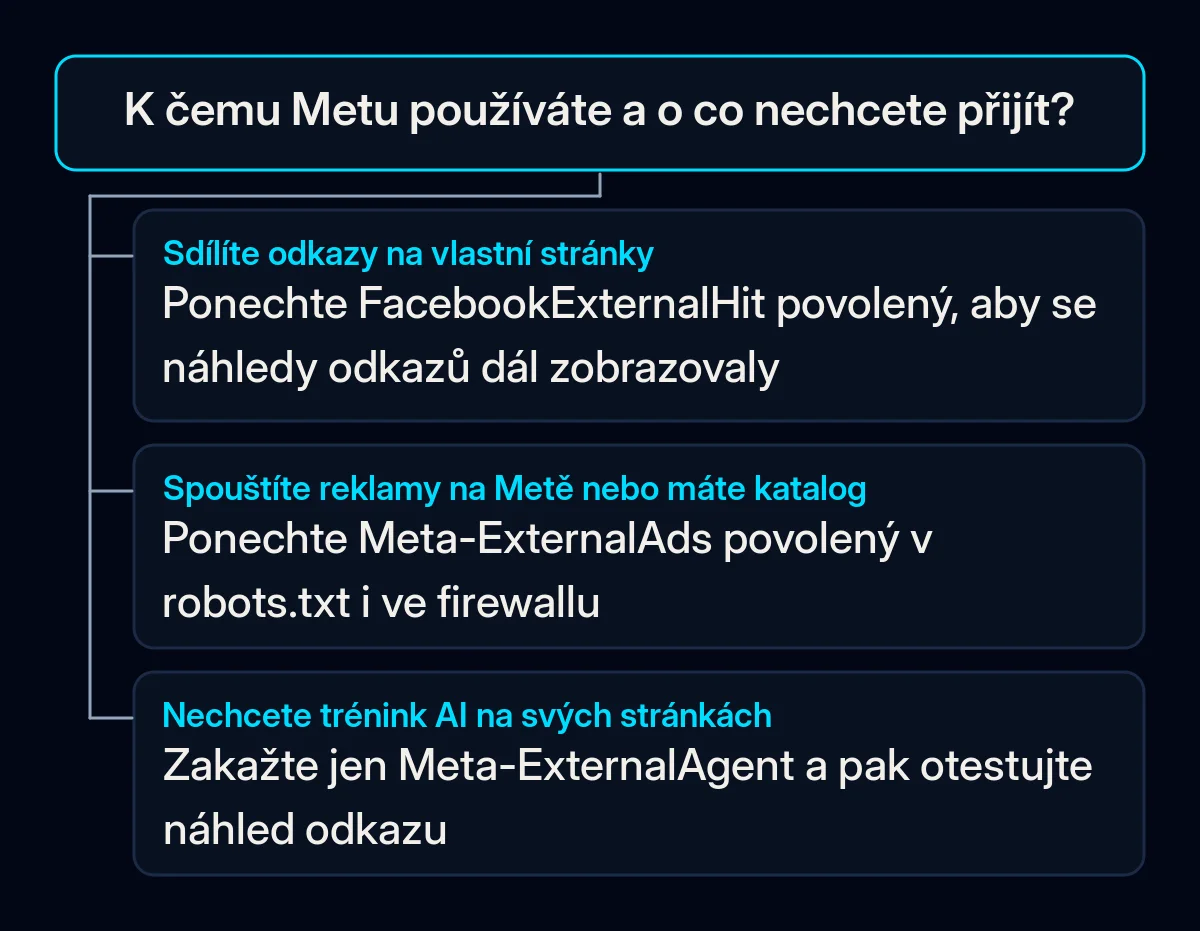
- Rozhodujte robot po robotu. Ponechte FacebookExternalHit, pokud sdílíte odkazy na své stránky. Ponechte Meta-ExternalAds, pokud spouštíte reklamy na Metě nebo používáte katalog produktů. Povolte Meta-WebIndexer, pokud chcete, aby Meta AI citovala vaše stránky. Zablokujte Meta-ExternalAgent, pokud nechcete, aby se vaše stránky používaly k tréninku AI, a mějte na paměti, že právní účinek takového pravidla na podmínky je nejasný. Stejnou logiku používáme, když zpřístupňujeme produktové stránky asistentům AI.
- Zkontrolujte, co už blokuje váš firewall, bezpečnostní plugin nebo CDN. Nepovolujte každého návštěvníka, který má v názvu “facebook”. Na vlastním webu jsme viděli požadavky, které používaly jméno robota Meta, přicházely ze sítí mimo Metu a žádaly o konfigurační soubory. Čtení logů procházení ještě před psaním nových pravidel je součástí našeho technického SEO.
- Po každé změně otestujte náhled odkazu. Počkejte den kvůli mezipaměti robots.txt, pak vložte adresu stránky do nástroje Sharing Debugger od Mety a zkontrolujte, že se zobrazí název a obrázek. Značky Open Graph, které tento název a obrázek dodávají, jsou na kontrolním seznamu před spuštěním webu, podle kterého pracujeme.
Pokud se o váš robots.txt nikdo nestará, začněte ještě dnes krokem 2. Ukáže vám, zda jsou roboti Meta momentálně povolení, zablokovaní, nebo v souboru vůbec nejsou zmínění.