Un client vous transfère une conversation : l’assistant de votre site lui a dit que les retours sont gratuits pendant soixante jours, alors que votre politique en prévoit trente. Ou une collègue cite une clause de contrat que l’assistant interne a “trouvée”, et personne ne la retrouve dans le contrat. Dans les deux cas, l’IA se trompe et donne de mauvaises réponses. La réponse courte : vous ne pouvez pas supprimer complètement les erreurs, mais vous pouvez généralement trouver de quel type d’erreur il s’agit et rendre les mauvaises réponses assurées rares, visibles et transmises à une personne.
Les réactions habituelles consistent à accuser le modèle, à ajouter “n’invente rien” à ses instructions ou à désactiver l’assistant. Souvent, la cause est plus banale : on a posé à l’assistant une question à laquelle ses contenus ne répondent pas, il a lu la mauvaise page, ou personne ne lui a dit que “Je ne sais pas” est une réponse acceptable. Chacune de ces causes laisse une trace que vous pouvez vérifier vous-même.
Pourquoi votre IA se trompe-t-elle ?
Un modèle de langage écrit les mots suivants les plus plausibles. Quand il a le fait sous les yeux, la réponse plausible est généralement la bonne. Quand il ne l’a pas, il écrit quand même quelque chose de fluide, et le NIST appelle cela la confabulation : “un contenu affirmé avec assurance mais erroné ou faux”, connu familièrement sous le nom d’hallucinations.
Les chercheurs d’OpenAI expliquent cette assurance : l’entraînement et l’évaluation habituels “récompensent le fait de deviner plutôt que de reconnaître l’incertitude”. Son centre d’aide ajoute que “l’assurance n’est pas la fiabilité” : une réponse fluide et sûre d’elle peut quand même être fausse. Dans un assistant d’entreprise, cette tendance générale se manifeste à travers quelques lacunes précises.
La réponse ne figure pas dans ses contenus. Un client pose une question sur un service que vous ne proposez plus, un pays où vous n’avez jamais livré ou une remise qui n’a jamais été écrite nulle part. Une étude de Barnett et de ses collègues sur les assistants fondés sur des documents cite cela comme premier point de défaillance : une question “à laquelle on ne peut pas répondre à partir des documents disponibles”. L’assistant devine à partir de ses connaissances générales, et c’est ainsi qu’apparaît un délai de retour plausible mais inventé.
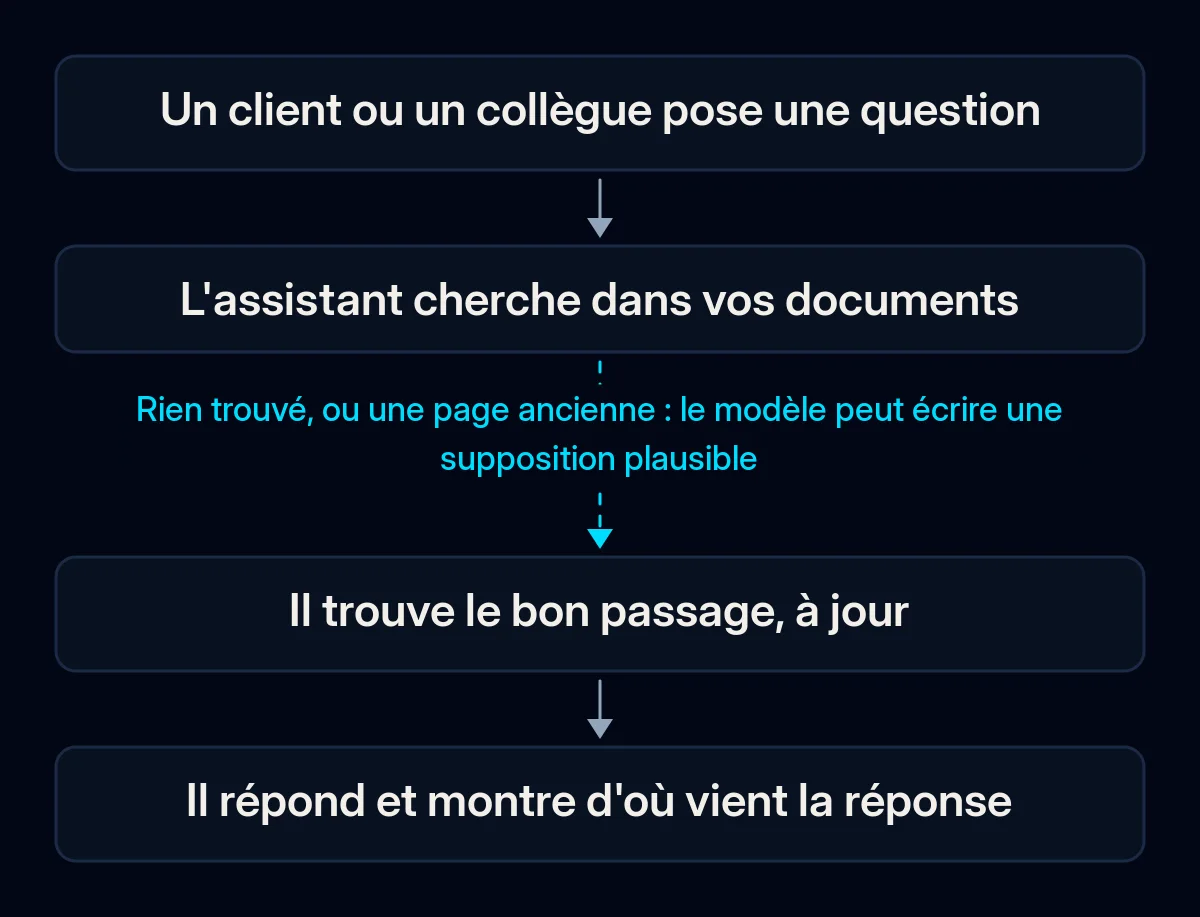
Il a trouvé la mauvaise page. L’assistant cherche d’abord dans vos documents et répond à partir de ce qu’il trouve : si la grille tarifaire de l’an dernier, un projet de politique et la version en vigueur se trouvent dans le même dossier, il peut citer n’importe laquelle. Les recommandations de Microsoft sur la vérification des réponses par rapport aux sources partent du même constat : les sources elles-mêmes doivent être “exactes et à jour”. Vous reconnaîtrez cette cause quand la mauvaise réponse s’avère vraie quelque part dans vos fichiers, simplement périmée.
La règle n’existe que dans la tête de quelqu’un. Votre équipe sait que les remboursements au-delà d’un certain montant demandent l’accord d’un responsable, ou que vous ne promettez pas de dates de livraison en décembre. Si rien de ce que lit l’assistant ne contient cette règle, il comble le vide avec une politique de son cru qui semble raisonnable.
La question sort de son rôle. Un assistant configuré pour les horaires d’ouverture et les réservations reçoit une demande de conseil juridique, médical ou tarifaire. Sans instruction de refuser, il essaie d’aider.
Rien ne l’autorise à dire “Je ne sais pas”. Des instructions comme “aide toujours le client” peuvent pousser le modèle à répondre même quand il n’a rien sur quoi s’appuyer. La documentation d’Anthropic indique qu’autoriser explicitement le modèle à admettre son incertitude “peut réduire considérablement les fausses informations”.
Ces lacunes se situent sur un même chemin, de la question à la réponse, et la réponse déraille à la première étape qui échoue.
Qui répond de ce que dit l’assistant ?
L’entreprise, dans une affaire bien connue. Dans Moffatt v. Air Canada (2024), le chatbot de la compagnie aérienne a laissé entendre à un client qu’il pouvait demander un tarif deuil de façon rétroactive, ce que la politique de la compagnie ne permettait pas. Le tribunal de Colombie-Britannique a estimé qu‘“il est indifférent que l’information provienne d’une page statique ou d’un chatbot”. Il a jugé que la compagnie “n’a pas pris de précautions raisonnables pour s’assurer que son chatbot était exact” et a accordé au client 812,02 CA$.
Le même principe s’applique aux assistants qu’utilisent vos équipes. Dans Mata v. Avianca (2023), un tribunal américain a condamné deux avocats et leur cabinet à verser solidairement une amende de 5 000 dollars après qu’ils ont déposé des décisions de justice inventées par ChatGPT et ont continué à les défendre lorsqu’on les a interrogés. Le tribunal a indiqué qu’il n’y a “rien d’intrinsèquement inapproprié” à utiliser un outil d’IA fiable, mais que la personne qui dépose conserve un “rôle de contrôle” sur l’exactitude. Quand quelqu’un transmet à un client la mauvaise réponse d’un assistant interne, le client risque de la lire comme la réponse de votre entreprise.
Comment identifier la cause dans votre cas
Pour comprendre pourquoi votre IA se trompe, rassemblez un ensemble de vraies questions et comparez chaque réponse à ce que vous savez être vrai. Aucun outil payant n’est nécessaire, seulement l’assistant, vos documents et un accès à l’historique de ses conversations. Prises ensemble, les mauvaises réponses vous indiquent quelle lacune combler en premier.
- Notez de vraies questions. Tirez-les de discussions, d’e-mails et d’appels récents, avec les mots des clients. Ajoutez des questions auxquelles vos documents ne répondent pas, et quelques-unes qui sortent du rôle de l’assistant.
- Écrivez la bonne réponse en face de chacune. Pour les questions sans réponse dans vos contenus, la bonne réponse est “Je ne sais pas, je vous mets en relation avec un collègue”.
- Posez chaque question à l’assistant, puis reposez-en certaines autrement. Si les faits d’une réponse changent d’une exécution à l’autre, l’assistant les devine probablement.
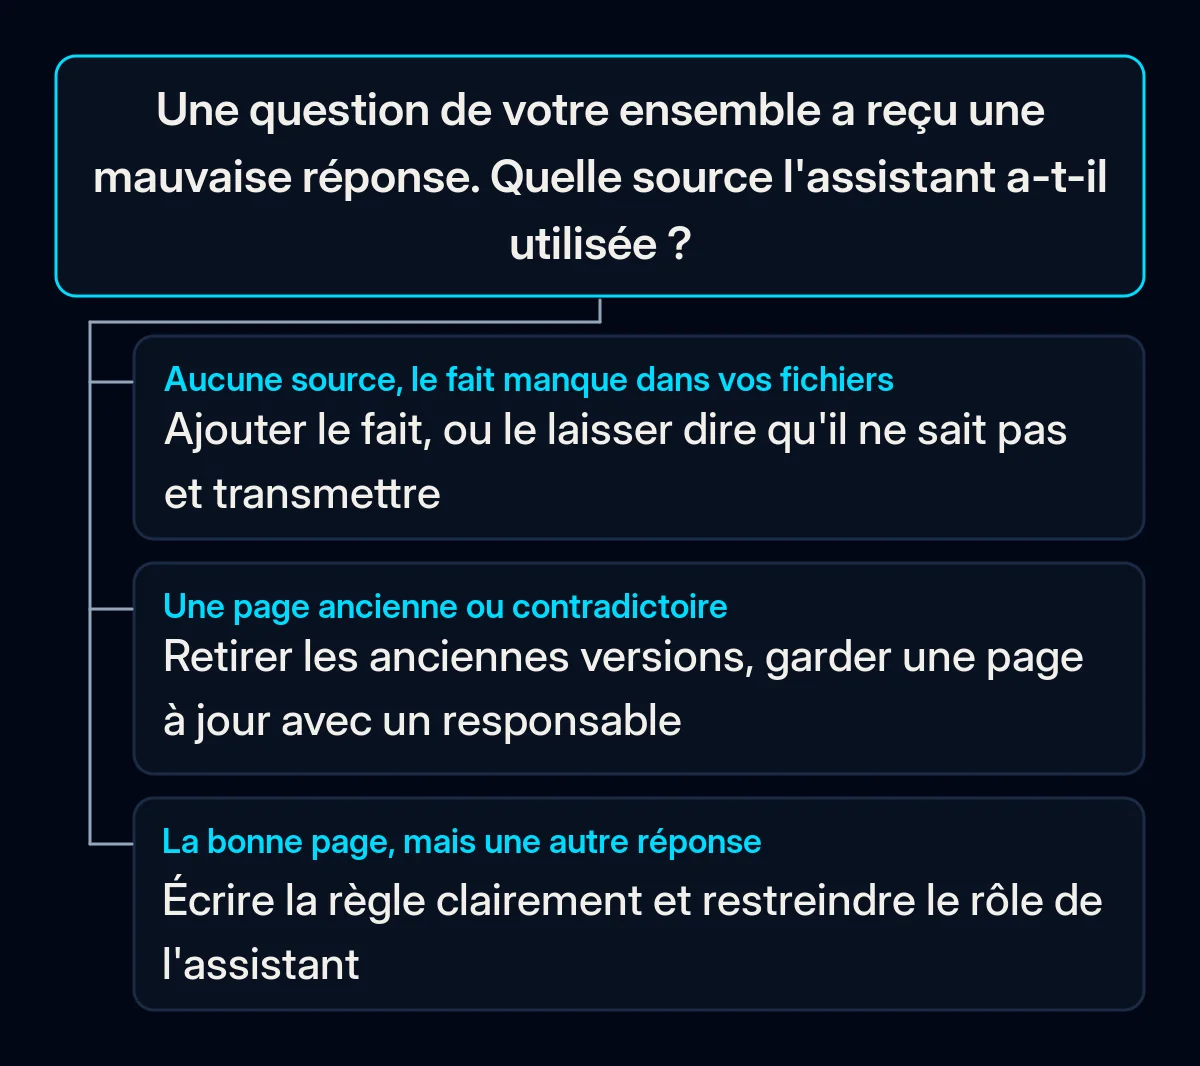
- Pour chaque mauvaise réponse, regardez ce qu’il a utilisé. Beaucoup d’assistants de connaissance peuvent afficher le passage source ou consigner les documents qu’ils ont récupérés ; vérifiez si le vôtre le fait. Notez s’il n’y avait aucune source, une source ancienne ou contradictoire, ou la bonne source qu’il a mal lue.
- Classez les mauvaises réponses par cause. Aucun document, document erroné ou périmé, règle non écrite, hors de son rôle, ou cas qui demandait de toute façon une personne. Le groupe le plus important est votre point de départ.
Conservez cet ensemble de questions et relancez-le après chaque modification. L’article de Barnett note que la validation d’un tel système “n’est possible qu’en exploitation” : ajoutez donc les nouvelles questions que les gens posent après le lancement.
Comment empêcher un assistant IA d’inventer ?
Commencez par les correctifs les moins coûteux : laissez l’assistant dire “Je ne sais pas” et transmettre la conversation à une personne, faites-le répondre uniquement à partir de vos documents avec une source visible, et tenez ces documents à jour. Viennent ensuite la mise par écrit des règles, la réduction de son rôle, la mention qu’il s’agit d’une IA et des tests réguliers. Relancez votre ensemble de questions après chaque modification, pour voir laquelle a aidé.
-
Laissez-le dire “Je ne sais pas” et transmettre. Modifiez les instructions pour que, lorsque les documents ne contiennent pas la réponse, l’assistant le dise et transmette la conversation à une personne, avec la question et les coordonnées du client. Les chercheurs d’OpenAI disent la même chose de l’autre côté : les modèles “peuvent s’abstenir en cas d’incertitude”. Un transfert n’aide que si quelqu’un le prend en charge ; notre article sur la question de savoir si un chatbot IA doit répondre à vos clients explique où ces transferts doivent arriver.
-
Faites-le répondre uniquement à partir de vos documents, en montrant la source. Ce dispositif s’appelle souvent génération augmentée par récupération, ou RAG : l’assistant cherche d’abord dans vos contenus, puis répond à partir des passages trouvés. Anthropic recommande de limiter le modèle aux “informations issues des documents fournis et non à ses connaissances générales”. Une source visible sous chaque réponse permet aux clients et aux équipes de la vérifier, et vous montre quelle page a causé une erreur. Dans nos projets d’intégration de l’IA, un assistant de connaissance répond avec un lien vers la source, si bien qu’une mauvaise réponse peut être remontée jusqu’à la page qui l’a produite. Attendez-vous tout de même à quelques erreurs : des chercheurs de Stanford qui testaient des outils d’IA pour la recherche juridique ont constaté que “même les systèmes RAG ne sont pas exempts d’hallucinations”.
-
Nettoyez les contenus qu’il lit. Une seule version en vigueur de chaque politique, grille tarifaire et modèle de contrat ; les anciennes versions hors du dossier ; pour chaque document, un responsable nommé qui le met à jour quand la règle change. Si l’assistant répond à partir de votre CRM, il en va de même pour les fiches qui s’y trouvent, comme nous l’avons expliqué dans notre article sur la qualité des données CRM.
-
Écrivez les règles qu’il ne cesse d’inventer. Conditions de remboursement, engagements de livraison, remises, ce qui compte comme une réclamation. Là où les enjeux sont élevés, donnez à l’assistant une formulation fixe, ou faites de ce sujet un cas où une personne valide la réponse avant son envoi.
-
Restreignez son rôle. Listez ce à quoi il répond et ce qu’il décline poliment. Les questions hors de la liste reçoivent un bref refus et, si c’est utile, un transfert.
-
Dites aux gens qu’ils parlent à une IA. Dans l’UE, le règlement sur l’intelligence artificielle impose que les personnes soient informées qu’elles interagissent avec un système d’IA, sauf si c’est évident, au plus tard lors de la première interaction. L’obligation incombe au fournisseur du système et s’applique depuis le 2 août 2026. Signaler les réponses de l’IA permet aussi de cadrer les attentes : après que son bot de support a inventé une règle d’utilisation en 2025, Cursor a commencé à signaler les réponses de l’IA dans son support par e-mail. Dans les projets de sites web où nous ajoutons un assistant, indiquer aux visiteurs qu’ils parlent à une IA fait partie de la page dès le départ.
-
Testez à nouveau après chaque modification. De nouveaux documents, des instructions modifiées et les mises à jour de modèle du fournisseur peuvent tous changer les réponses à des questions qui fonctionnaient jusque-là. Relancez l’ensemble de questions après chacune d’elles et avant une période chargée.
Qu’est-ce qui n’arrête pas, à lui seul, les hallucinations de l’IA ?
Trois correctifs sont souvent essayés en premier : une ligne demandant au modèle de ne pas halluciner, une température à 0 et le fine-tuning sur vos propres textes. Chacun ne change qu’une partie de l’assistant. Les faits qui lui manquent et l’autorisation de dire “Je ne sais pas” viennent de ses documents et de ses instructions : si les mauvaises réponses continuent après ces correctifs, vérifiez-les en premier.
| Ce qu’on essaie | Ce que cela change | Ce qui reste identique |
|---|---|---|
| Une ligne “n’hallucine pas” dans les instructions | La formulation de la demande faite au modèle | Sans autorisation de dire “Je ne sais pas”, le modèle doit quand même produire une réponse |
| Baisser la température à 0 | À quel point la formulation varie d’une exécution à l’autre ; Anthropic précise que même à 0 “les résultats ne seront pas totalement déterministes” | Les documents que lit l’assistant, et les faits qui y manquent |
| Le fine-tuning (entraînement complémentaire) d’un modèle sur vos propres textes | À notre avis, surtout la façon dont le modèle écrit et se comporte | Les prix et conditions qui changent, dont la place est dans des documents qu’il lit au moment de répondre |
Comment savoir si les mauvaises réponses deviennent plus rares ?
Suivez quelques indicateurs issus de l’ensemble de questions et de vraies conversations, en commençant avant votre premier correctif pour avoir un point de comparaison. Vérifiez-les après chaque modification, puis à intervalles réguliers une fois l’assistant stabilisé, et lisez les mauvaises réponses elles-mêmes en plus des totaux.
- Les bonnes réponses sur votre ensemble de questions, y compris celles où la bonne réponse est “Je ne sais pas”.
- Les mauvaises réponses par semaine et par cause, en lisant de vraies conversations. Une cause qui revient sans cesse est le prochain correctif.
- Les transferts pris en charge par une personne, et le temps d’attente. Un transfert auquel personne ne répond se termine souvent par le départ du client.
- Les réponses qui affichent une source. Si la part des réponses sans source augmente, vérifiez que les documents couvrent encore les questions posées.
Notre rôle
Nous partons de vos questions et de vos documents : l’ensemble de questions, les bonnes réponses et les sources que l’assistant doit utiliser. Nous configurons ensuite l’assistant pour qu’il réponde à partir de ces contenus avec une source visible, et avec une personne qui valide les réponses là où c’est important. Nous continuons à le tester sur l’ensemble de questions dans le cadre de contrôles qualité réguliers. Si l’un de vos assistants donne déjà de mauvaises réponses, le brief est le moyen le plus simple de nous montrer où.