Klient przesyła Ci zapis czatu: asystent na Twojej stronie napisał mu, że zwrot jest bezpłatny przez sześćdziesiąt dni, choć regulamin mówi o trzydziestu. Albo współpracownik cytuje klauzulę umowy, którą “znalazł” wewnętrzny asystent, a nikt nie może jej w umowie odnaleźć. W obu przypadkach to halucynacje AI, czyli błędne odpowiedzi podawane z pełnym przekonaniem. Krótka odpowiedź: błędów nie da się wyłączyć całkowicie, ale zwykle można ustalić, jakiego rodzaju to błąd, i sprawić, by pewne siebie błędne odpowiedzi były rzadkie, widoczne i trafiały do człowieka.
Typowe reakcje to obwinianie modelu, dopisanie do instrukcji “nie zmyślaj” albo wyłączenie asystenta. Często przyczyna jest bardziej prozaiczna: asystent dostał pytanie, na które jego materiały nie odpowiadają, przeczytał niewłaściwą stronę albo nikt mu nie powiedział, że “nie wiem” to dopuszczalna odpowiedź. Każda z tych przyczyn zostawia ślad, który możesz sprawdzić sam.
Skąd biorą się halucynacje AI w Twoim asystencie?
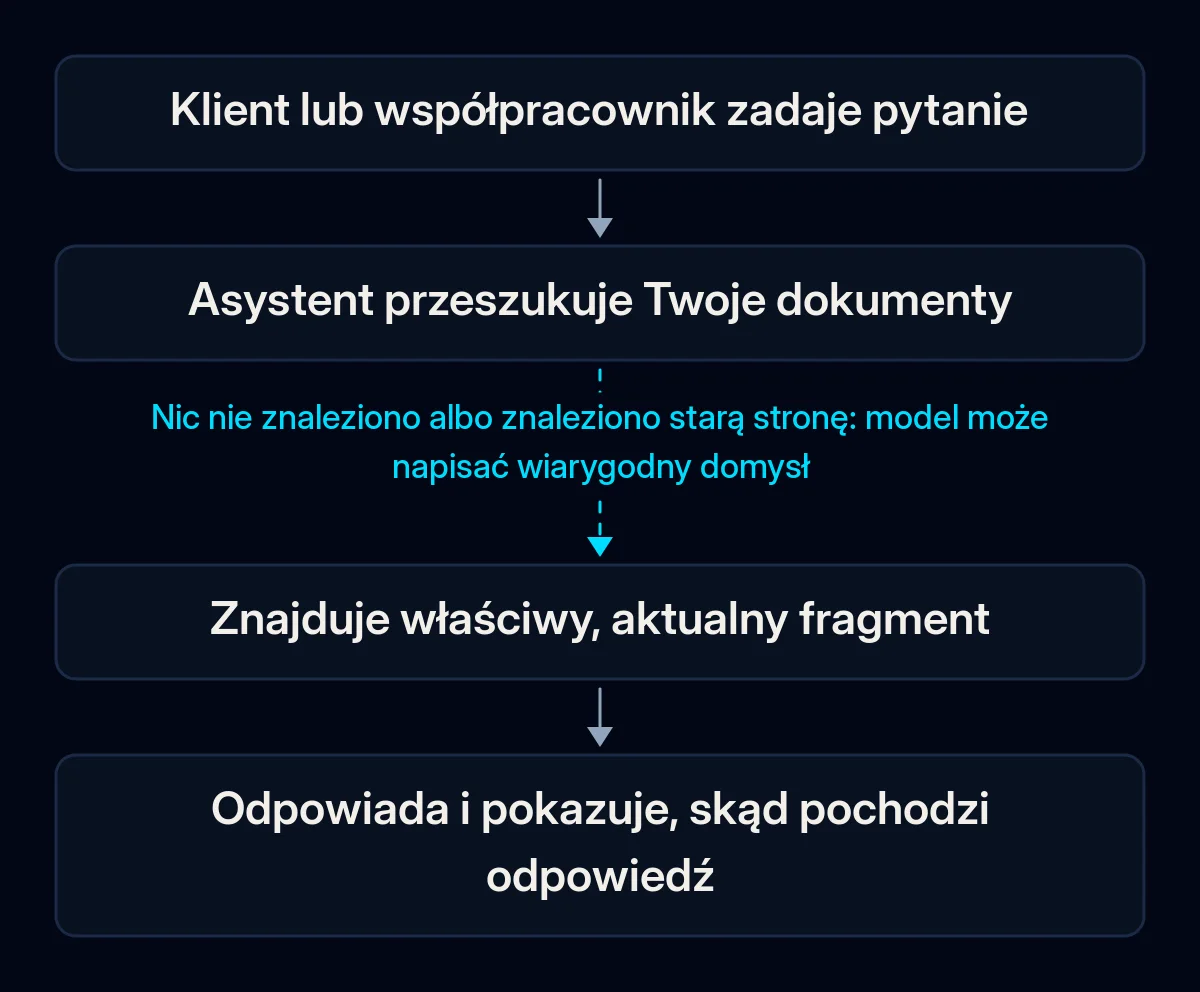
Model językowy pisze najbardziej prawdopodobne kolejne słowa. Gdy ma fakt przed sobą, prawdopodobna odpowiedź jest zwykle prawidłowa. Gdy go nie ma, i tak napisze coś płynnego. NIST nazywa to konfabulacją: “treści podane z pewnością siebie, ale błędne lub fałszywe”, potocznie zwane halucynacjami.
Badacze OpenAI wyjaśniają, skąd ta pewność siebie: standardowe trenowanie i ocena modeli “nagradzają zgadywanie bardziej niż przyznanie się do niepewności”. Centrum pomocy OpenAI dodaje, że “pewność siebie to nie wiarygodność”: płynna, stanowcza odpowiedź nadal może być błędna. W asystencie firmowym ten ogólny nawyk ujawnia się przez kilka konkretnych luk.
Odpowiedzi nie ma w jego materiałach. Klient pyta o usługę, której już nie oferujesz, o kraj, do którego nigdy nie wysyłałeś, albo o rabat, którego nikt nigdy nie spisał. Badanie asystentów opartych na dokumentach autorstwa Barnetta i współpracowników wymienia to jako pierwszy punkt awarii: pytanie, “na które nie da się odpowiedzieć na podstawie dostępnych dokumentów”. Asystent zgaduje na podstawie wiedzy ogólnej i tak powstaje wiarygodnie brzmiący, ale zmyślony termin zwrotu.
Znalazł niewłaściwą stronę. Asystent najpierw przeszukuje Twoje dokumenty i odpowiada na podstawie tego, co znajdzie, więc jeśli zeszłoroczny cennik, projekt regulaminu i obecna wersja leżą w tym samym folderze, może zacytować dowolny z nich. Wytyczne Microsoftu dotyczące sprawdzania odpowiedzi względem źródeł zaczynają od tego samego: same źródła muszą być “dokładne i aktualne”. Tę przyczynę rozpoznasz, gdy błędna odpowiedź okaże się gdzieś w Twoich plikach prawdziwa, tylko nieaktualna.
Zasada istnieje tylko w czyjejś głowie. Twój zespół wie, że zwroty powyżej pewnej kwoty wymagają zgody kierownika albo że w grudniu nie obiecujecie terminów dostawy. Gdy nic, co czyta asystent, nie zawiera tej zasady, wypełnia on lukę własną, rozsądnie brzmiącą zasadą.
Pytanie wykracza poza jego zadanie. Asystent ustawiony do godzin otwarcia i rezerwacji dostaje prośbę o poradę prawną, medyczną albo cenową. Bez instrukcji, by odmówić, próbuje pomóc.
Nic nie pozwala mu powiedzieć “nie wiem”. Instrukcje typu “zawsze pomagaj klientowi” mogą skłaniać model do odpowiedzi nawet wtedy, gdy nie ma na czym jej oprzeć. Dokumentacja Anthropic mówi, że wyraźne pozwolenie modelowi na przyznanie się do niepewności “może drastycznie ograniczyć fałszywe informacje”.
Te luki leżą na jednej ścieżce od pytania do odpowiedzi, a odpowiedź psuje się na pierwszym kroku, który zawiedzie.
Kto odpowiada za to, co mówi asystent?
W jednej głośnej sprawie odpowiadała firma. W sprawie Moffatt v. Air Canada (2024) chatbot linii lotniczej zasugerował klientowi, że o taryfę żałobną może wystąpić z mocą wsteczną, na co polityka przewoźnika nie pozwalała. Trybunał w Kolumbii Brytyjskiej uznał, że “nie ma znaczenia, czy informacja pochodzi ze statycznej strony, czy z chatbota”. Stwierdził, że linia “nie dołożyła należytej staranności, by jej chatbot był dokładny”, i przyznał klientowi 812,02 CA$.
Ta sama zasada dotyczy asystentów, z których korzystają Twoi pracownicy. W sprawie Mata v. Avianca (2023) sąd w USA nakazał dwóm prawnikom i ich kancelarii zapłacić solidarnie karę 5000 USD po tym, jak złożyli orzeczenia sądowe wymyślone przez ChatGPT i nadal się przy nich upierali, gdy zostali o nie zapytani. Sąd stwierdził, że korzystanie z wiarygodnego narzędzia AI nie jest “samo w sobie niczym niewłaściwym”, ale osoba składająca pismo zachowuje “rolę strażnika” jego poprawności. Gdy ktoś prześle klientowi błędną odpowiedź wewnętrznego asystenta, klient najpewniej uzna ją za odpowiedź Twojej firmy.
Jak ustalić, która przyczyna dotyczy Ciebie
Aby znaleźć przyczynę błędnych odpowiedzi AI, zbierz zestaw prawdziwych pytań i porównaj każdą odpowiedź z tym, o czym wiesz, że jest prawdą. Nie potrzebujesz płatnych narzędzi, tylko asystenta, swoich dokumentów i dostępu do historii jego rozmów. Błędne odpowiedzi zebrane razem pokażą, którą lukę zamknąć najpierw.
- Spisz prawdziwe pytania. Weź je z ostatnich czatów, maili i rozmów telefonicznych, słowami samych klientów. Dodaj pytania, na które Twoje dokumenty nie odpowiadają, i kilka spoza zadania asystenta.
- Przy każdym zapisz prawidłową odpowiedź. Dla pytań bez odpowiedzi w materiałach prawidłowa odpowiedź brzmi: “nie wiem, przekażę Cię koledze”.
- Zadaj asystentowi każde pytanie, a część powtórz innymi słowami. Jeśli fakty w odpowiedzi zmieniają się między próbami, asystent prawdopodobnie je zgaduje.
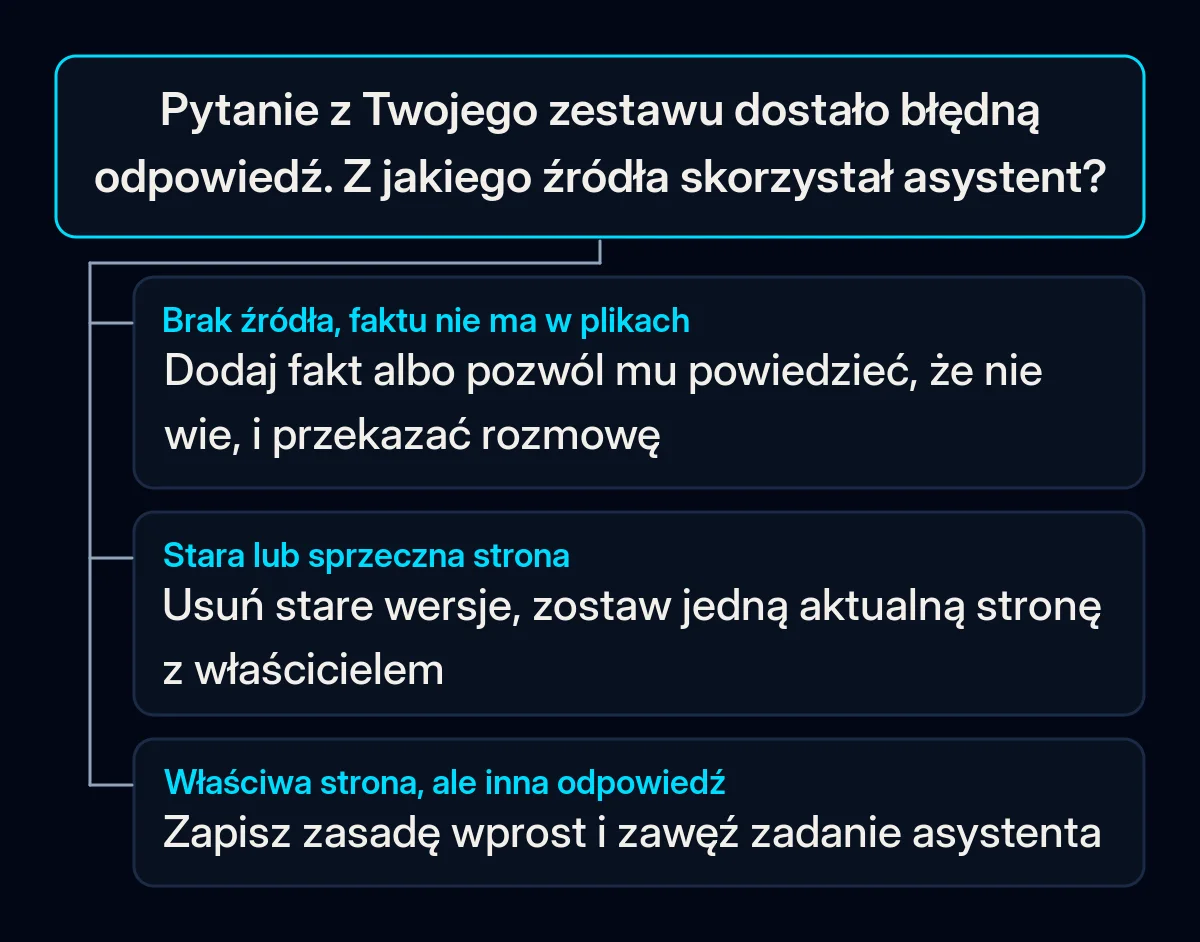
- Przy każdej błędnej odpowiedzi sprawdź, z czego skorzystał. Wiele asystentów wiedzy potrafi pokazać fragment źródłowy albo zapisuje, które dokumenty pobrał; sprawdź, czy Twój to robi. Zanotuj, czy źródła nie było, czy było stare lub sprzeczne, czy było właściwe, ale asystent źle je odczytał.
- Posortuj błędne odpowiedzi według przyczyn. Brak dokumentu, zły lub nieaktualny dokument, niespisana zasada, pytanie spoza zadania albo sprawa, która i tak wymagała człowieka. Największa grupa to miejsce, od którego warto zacząć.
Zachowaj ten zestaw i uruchamiaj go po każdej zmianie. Praca Barnetta zauważa, że walidacja takiego systemu “jest możliwa tylko w trakcie działania”, więc dopisuj nowe pytania, które ludzie zadają po uruchomieniu.
Jak sprawić, by asystent AI przestał zmyślać?
Zacznij od najtańszych poprawek: pozwól asystentowi mówić “nie wiem” i przekazywać rozmowę człowiekowi, każ mu odpowiadać tylko na podstawie Twoich dokumentów z widocznym źródłem i dbaj, by te dokumenty były aktualne. Potem przychodzi czas na spisanie zasad, zawężenie zadania, oznaczenie, że to AI, i regularne testy. Po każdej zmianie uruchamiaj ponownie zestaw pytań, żeby widzieć, która pomogła.
-
Pozwól mu powiedzieć “nie wiem” i przekazać rozmowę. Zmień instrukcje tak, by gdy dokumenty nie zawierają odpowiedzi, asystent to mówił i przekazywał rozmowę człowiekowi razem z pytaniem klienta i jego danymi kontaktowymi. Badacze OpenAI mówią to samo z drugiej strony: modele “mogą się wstrzymać, gdy nie są pewne”. Przekazanie pomaga tylko wtedy, gdy ktoś je odbierze; nasz tekst o tym, czy chatbot AI powinien odpowiadać Twoim klientom, opisuje, gdzie takie przekazania powinny trafiać.
-
Każ mu odpowiadać tylko na podstawie Twoich dokumentów i pokazywać źródło. Taki układ nazywa się często generowaniem wspomaganym wyszukiwaniem, czyli RAG: asystent najpierw przeszukuje Twoje materiały, a potem odpowiada na podstawie znalezionych fragmentów. Anthropic zaleca ograniczenie modelu do “informacji z dostarczonych dokumentów, a nie jego wiedzy ogólnej”. Widoczne źródło pod każdą odpowiedzią pozwala klientom i pracownikom ją sprawdzić, a Tobie zobaczyć, która strona spowodowała błąd. W naszych projektach wdrożenia AI asystent wiedzy odpowiada z linkiem do źródła, więc błędną odpowiedź da się prześledzić do strony, na której się opiera. Nawet wtedy licz się z pewnymi błędami: badacze ze Stanfordu, testując narzędzia AI do researchu prawniczego, stwierdzili, że “nawet systemy RAG nie są wolne od halucynacji”.
-
Uporządkuj materiały, które czyta. Jedna aktualna wersja każdego regulaminu, cennika i wzoru umowy; stare wersje poza folderem; każdy dokument z wyznaczonym właścicielem, który aktualizuje go, gdy zasada się zmienia. Jeśli asystent odpowiada na podstawie CRM, to samo dotyczy zapisanych tam rekordów, o czym pisaliśmy w tekście o jakości danych w CRM.
-
Spisz zasady, które ciągle wymyśla. Warunki zwrotów, obietnice dostawy, rabaty, co liczy się jako reklamacja. Tam, gdzie stawka jest wysoka, daj asystentowi stałe sformułowanie albo zrób z tego temat, w którym człowiek zatwierdza odpowiedź, zanim zostanie wysłana.
-
Zawęź jego zadanie. Wypisz, na co odpowiada, a czego uprzejmie odmawia. Pytania spoza listy dostają krótką odmowę, a tam, gdzie to przydatne, przekazanie rozmowy.
-
Informuj ludzi, że rozmawiają z AI. W UE akt w sprawie sztucznej inteligencji wymaga, aby ludzie byli informowani, że wchodzą w interakcję z systemem AI, chyba że jest to oczywiste, najpóźniej przy pierwszej interakcji. Obowiązek spoczywa na dostawcy systemu i obowiązuje od 2 sierpnia 2026 r. Oznaczanie odpowiedzi AI ustawia też oczekiwania: po tym, jak w 2025 roku jego bot wsparcia wymyślił zasadę korzystania z usługi, Cursor zaczął oznaczać odpowiedzi AI w obsłudze mailowej. W projektach stron internetowych, w których dodajemy asystenta, informacja dla odwiedzających, że rozmawiają z AI, jest częścią strony od początku.
-
Testuj ponownie po każdej zmianie. Nowe dokumenty, zmienione instrukcje i aktualizacje modelu od dostawcy mogą zmienić odpowiedzi na pytania, które wcześniej działały. Uruchamiaj zestaw pytań po każdej z nich i przed gorącym sezonem.
Co samo nie powstrzyma halucynacji AI?
Trzy poprawki często próbuje się najpierw: zdanie zakazujące modelowi halucynowania, temperaturę 0 i fine-tuning na własnych tekstach. Każda zmienia tylko jedną część asystenta. Brakujące fakty i pozwolenie na “nie wiem” pochodzą z jego dokumentów i instrukcji, więc jeśli błędne odpowiedzi nie znikają po tych poprawkach, najpierw sprawdź właśnie je.
| Co się próbuje | Co to zmienia | Co zostaje bez zmian |
|---|---|---|
| Zdanie “nie halucynuj” w instrukcjach | Sposób sformułowania prośby do modelu | Bez pozwolenia na “nie wiem” model nadal musi wygenerować odpowiedź |
| Obniżenie temperatury do 0 | Jak bardzo sformułowania różnią się między próbami; Anthropic zaznacza, że nawet przy 0 “wyniki nie będą w pełni deterministyczne” | Dokumenty, które czyta asystent, i fakty, których w nich brakuje |
| Fine-tuning (dotrenowanie) modelu na własnych tekstach | Naszym zdaniem głównie to, jak model pisze i się zachowuje | Zmieniające się ceny i warunki, których miejsce jest w dokumentach czytanych w chwili odpowiedzi |
Skąd wiesz, że błędnych odpowiedzi jest coraz mniej?
Śledź kilka wskaźników z zestawu pytań i z prawdziwych rozmów, zaczynając przed pierwszą poprawką, żeby mieć punkt odniesienia. Sprawdzaj je po każdej zmianie, a gdy asystent się ustabilizuje, regularnie według harmonogramu, i obok sum czytaj same błędne odpowiedzi.
- Prawidłowe odpowiedzi na zestaw pytań, w tym na pytania, na które właściwa odpowiedź brzmi “nie wiem”.
- Błędne odpowiedzi tygodniowo według przyczyn, z lektury prawdziwych rozmów. Przyczyna, która ciągle wraca, to następna poprawka.
- Przekazania odebrane przez człowieka i jak długo czekały. Przekazanie, na które nikt nie odpowiada, często kończy się i tak odejściem klienta.
- Odpowiedzi z widocznym źródłem. Jeśli rośnie udział odpowiedzi bez źródła, sprawdź, czy dokumenty nadal obejmują pytania, które zadają ludzie.
Jak możemy pomóc
Zaczynamy od Twoich pytań i dokumentów: zestawu pytań, prawidłowych odpowiedzi i źródeł, z których asystent powinien korzystać. Potem ustawiamy asystenta tak, by odpowiadał na podstawie tych materiałów z widocznym źródłem, a tam, gdzie to ważne, z człowiekiem zatwierdzającym odpowiedzi. Dalej sprawdzamy go zestawem pytań w ramach regularnej kontroli jakości. Jeśli Twój asystent już podaje błędne odpowiedzi, brief to najprostszy sposób, żeby pokazać nam, gdzie.