Ένας πελάτης σάς προωθεί μια συνομιλία: ο βοηθός του ιστότοπού σας τού είπε ότι οι επιστροφές είναι δωρεάν για εξήντα ημέρες, ενώ η πολιτική σας λέει τριάντα. Ή ένας συνάδελφος παραθέτει έναν όρο σύμβασης που “βρήκε” ο εσωτερικός βοηθός και που κανείς δεν μπορεί να εντοπίσει στη σύμβαση. Και τα δύο είναι AI hallucinations: το AI δίνει λάθος απαντήσεις με απόλυτη σιγουριά. Η σύντομη απάντηση: δεν μπορείτε να κλείσετε εντελώς τα λάθη, αλλά συνήθως μπορείτε να βρείτε τι είδους λάθος είναι και να κάνετε τις σίγουρες λάθος απαντήσεις σπάνιες, ορατές και να περνούν σε άνθρωπο.
Οι συνηθισμένες αντιδράσεις είναι να κατηγορήσετε το μοντέλο, να προσθέσετε “μην επινοείς πράγματα” στις οδηγίες του ή να κλείσετε τον βοηθό. Συχνά η αιτία είναι πιο απλή: ο βοηθός ρωτήθηκε κάτι που το υλικό του δεν απαντά, διάβασε τη λάθος σελίδα ή κανείς δεν του είπε ότι το “δεν ξέρω” είναι αποδεκτή απάντηση. Κάθε μία από αυτές τις αιτίες αφήνει ίχνος που μπορείτε να ελέγξετε μόνοι σας.
Γιατί εμφανίζονται AI hallucinations στον βοηθό σας;
Ένα γλωσσικό μοντέλο γράφει τις πιο πιθανές επόμενες λέξεις. Όταν έχει το στοιχείο μπροστά του, η πιθανή απάντηση είναι συνήθως η σωστή. Όταν δεν το έχει, γράφει παρ’ όλα αυτά κάτι που ακούγεται άνετο, και το NIST το ονομάζει confabulation: “περιεχόμενο που διατυπώνεται με σιγουριά αλλά είναι εσφαλμένο ή ψευδές”, γνωστό στην καθομιλουμένη ως ψευδαισθήσεις (hallucinations).
Οι ερευνητές της OpenAI εξηγούν τη σιγουριά: η συνήθης εκπαίδευση και αξιολόγηση “επιβραβεύουν τη μαντεψιά αντί για την παραδοχή της αβεβαιότητας”. Το κέντρο βοήθειάς της προσθέτει ότι “η σιγουριά δεν είναι αξιοπιστία”: μια άνετη, βέβαιη απάντηση μπορεί να είναι λάθος. Σε έναν επιχειρηματικό βοηθό, αυτή η γενική συνήθεια εκδηλώνεται μέσα από μερικά συγκεκριμένα κενά.
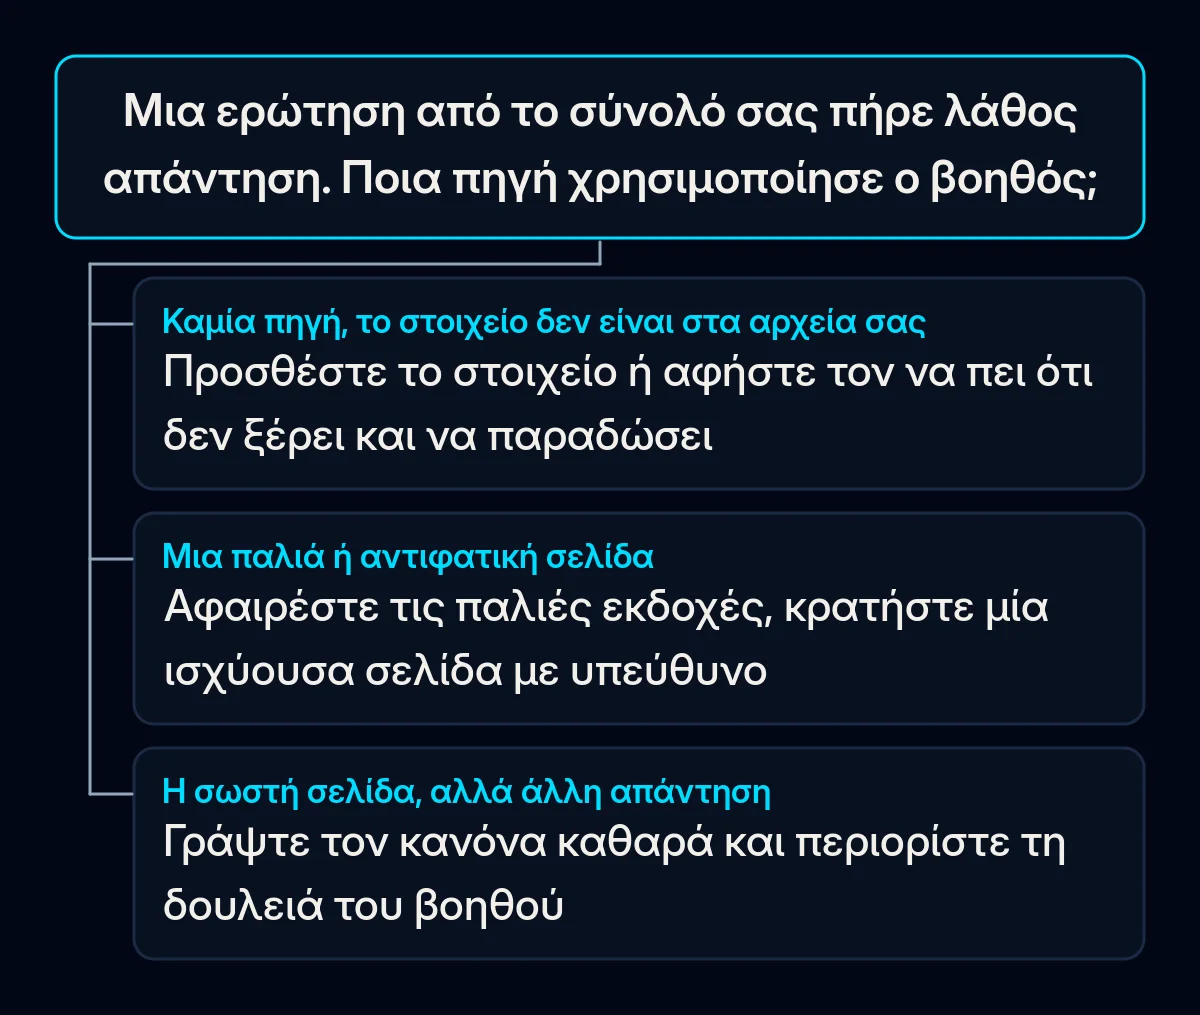
Η απάντηση δεν υπάρχει στο υλικό του. Ένας πελάτης ρωτά για μια υπηρεσία που σταματήσατε να προσφέρετε, για μια χώρα όπου δεν στείλατε ποτέ ή για μια έκπτωση που δεν καταγράφηκε ποτέ. Μια μελέτη του Barnett και των συνεργατών του για βοηθούς που βασίζονται σε έγγραφα το αναφέρει ως πρώτο σημείο αποτυχίας: μια ερώτηση “που δεν μπορεί να απαντηθεί από τα διαθέσιμα έγγραφα”. Ο βοηθός μαντεύει από τη γενική του γνώση, και έτσι εμφανίζεται μια πειστική αλλά επινοημένη προθεσμία επιστροφής.
Βρήκε τη λάθος σελίδα. Ο βοηθός ψάχνει πρώτα στα έγγραφά σας και απαντά από ό,τι βρει, οπότε αν ο περσινός τιμοκατάλογος, ένα προσχέδιο πολιτικής και η ισχύουσα εκδοχή βρίσκονται στον ίδιο φάκελο, μπορεί να παραθέσει οποιοδήποτε από αυτά. Οι οδηγίες της Microsoft για τον έλεγχο των απαντήσεων απέναντι στις πηγές ξεκινούν από το ίδιο σημείο: οι ίδιες οι πηγές πρέπει να είναι “ακριβείς και ενημερωμένες”. Θα αναγνωρίσετε αυτή την αιτία όταν η λάθος απάντηση αποδειχθεί σωστή κάπου στα αρχεία σας, απλώς παρωχημένη.
Ο κανόνας υπάρχει μόνο στο μυαλό κάποιου. Η ομάδα σας ξέρει ότι οι επιστροφές χρημάτων πάνω από ένα ποσό χρειάζονται έγκριση προϊσταμένου ή ότι τον Δεκέμβριο δεν υπόσχεστε ημερομηνίες παράδοσης. Όταν τίποτα από όσα διαβάζει ο βοηθός δεν περιέχει αυτόν τον κανόνα, καλύπτει το κενό με μια δική του πολιτική που ακούγεται λογική.
Η ερώτηση είναι εκτός της δουλειάς του. Ένας βοηθός που στήθηκε για ωράρια και κρατήσεις δέχεται ερωτήσεις για νομικές, ιατρικές ή τιμολογιακές συμβουλές. Χωρίς οδηγία να αρνηθεί, προσπαθεί να βοηθήσει.
Τίποτα δεν του επιτρέπει να πει “δεν ξέρω”. Οδηγίες όπως “βοήθα πάντα τον πελάτη” μπορεί να σπρώξουν το μοντέλο να απαντήσει ακόμη και όταν δεν έχει από πού να απαντήσει. Η τεκμηρίωση της Anthropic αναφέρει ότι αν επιτρέψετε ρητά στο μοντέλο να παραδεχτεί αβεβαιότητα, αυτό “μπορεί να μειώσει δραστικά τις ψευδείς πληροφορίες”.
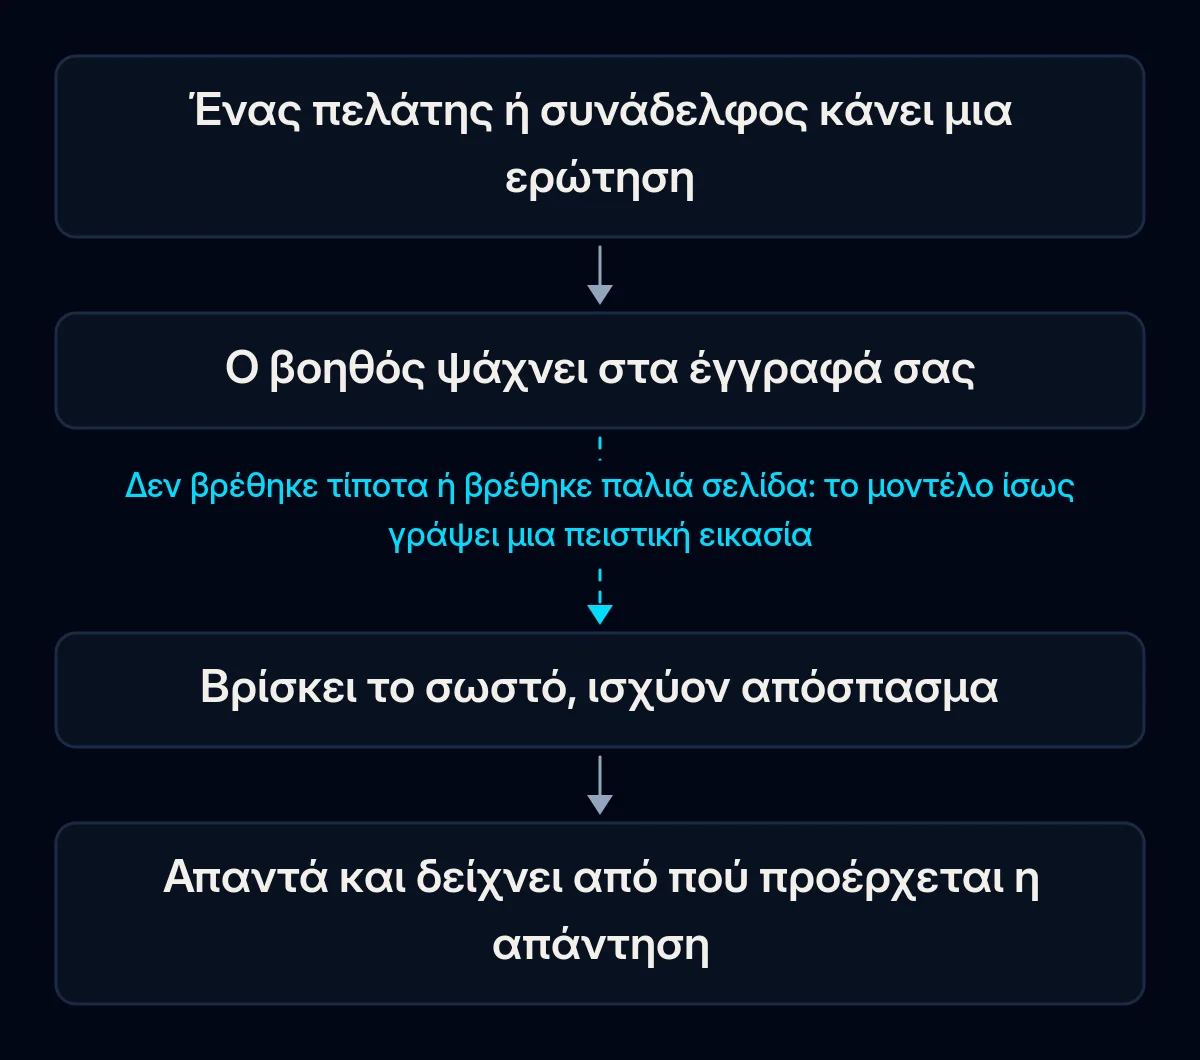
Αυτά τα κενά βρίσκονται σε μία διαδρομή από την ερώτηση ως την απάντηση, και η απάντηση στραβώνει στο πρώτο βήμα που αποτυγχάνει.
Ποιος ευθύνεται για ό,τι λέει ο βοηθός;
Σε μια γνωστή υπόθεση, η επιχείρηση. Στην Moffatt v. Air Canada (2024), το chatbot της αεροπορικής άφησε να εννοηθεί ότι ένας πελάτης μπορούσε να ζητήσει αναδρομικά ναύλο πένθους, κάτι που η πολιτική της αεροπορικής δεν επέτρεπε. Το δικαιοδοτικό όργανο της Βρετανικής Κολομβίας έκρινε ότι “δεν έχει καμία διαφορά αν η πληροφορία προέρχεται από μια στατική σελίδα ή από ένα chatbot”. Έκρινε ότι η αεροπορική “δεν έδειξε εύλογη επιμέλεια ώστε να διασφαλίσει ότι το chatbot της ήταν ακριβές” και επιδίκασε στον πελάτη 812,02 CA$.
Η ίδια αρχή ισχύει για βοηθούς που χρησιμοποιεί το προσωπικό σας. Στην Mata v. Avianca (2023), ένα αμερικανικό δικαστήριο υποχρέωσε δύο δικηγόρους και το γραφείο τους να πληρώσουν από κοινού κύρωση 5.000 $, αφού κατέθεσαν δικαστικές αποφάσεις που είχε επινοήσει το ChatGPT και συνέχισαν να τις υπερασπίζονται όταν ρωτήθηκαν. Το δικαστήριο είπε ότι δεν υπάρχει “τίποτα εγγενώς ανάρμοστο” στη χρήση ενός αξιόπιστου εργαλείου AI, αλλά όποιος καταθέτει διατηρεί τον “ρόλο του θυρωρού” για την ακρίβεια. Όταν κάποιος προωθεί σε πελάτη μια λάθος απάντηση του εσωτερικού βοηθού, ο πελάτης πιθανότατα θα τη διαβάσει ως απάντηση της εταιρείας σας.
Πώς βρίσκετε ποια αιτία ισχύει για εσάς
Για να βρείτε γιατί το AI δίνει λάθος απαντήσεις, συγκεντρώστε ένα σύνολο πραγματικών ερωτήσεων και ελέγξτε κάθε απάντηση απέναντι σε ό,τι ξέρετε ότι ισχύει. Δεν χρειάζεστε επί πληρωμή εργαλεία, μόνο τον βοηθό, τα έγγραφά σας και πρόσβαση στο ιστορικό συνομιλιών του. Όλες μαζί, οι λάθος απαντήσεις σάς δείχνουν ποιο κενό να κλείσετε πρώτο.
- Γράψτε πραγματικές ερωτήσεις. Πάρτε τις από πρόσφατα chat, email και τηλεφωνήματα, με τα λόγια των ίδιων των πελατών. Προσθέστε ερωτήσεις που τα έγγραφά σας δεν απαντούν και μερικές που είναι εκτός της δουλειάς του βοηθού.
- Γράψτε δίπλα σε καθεμία τη σωστή απάντηση. Για τις ερωτήσεις χωρίς απάντηση στο υλικό σας, η σωστή απάντηση είναι “δεν ξέρω, σας συνδέω με έναν συνάδελφο”.
- Κάντε στον βοηθό όλες τις ερωτήσεις και μερικές ξανά με άλλα λόγια. Αν τα στοιχεία μιας απάντησης αλλάζουν από εκτέλεση σε εκτέλεση, ο βοηθός μάλλον τα μαντεύει.
- Για κάθε λάθος απάντηση, δείτε τι χρησιμοποίησε. Πολλοί βοηθοί γνώσης μπορούν να δείξουν το απόσπασμα της πηγής ή να καταγράψουν ποια έγγραφα ανέκτησαν· ελέγξτε αν το κάνει ο δικός σας. Σημειώστε αν δεν υπήρχε πηγή, αν η πηγή ήταν παλιά ή αντιφατική, ή αν ήταν η σωστή πηγή αλλά τη διάβασε λάθος.
- Ταξινομήστε τις λάθος απαντήσεις ανά αιτία. Κανένα έγγραφο, λάθος ή παρωχημένο έγγραφο, άγραφος κανόνας, εκτός δουλειάς ή περίπτωση που ούτως ή άλλως χρειαζόταν άνθρωπο. Η μεγαλύτερη ομάδα είναι το σημείο εκκίνησης.
Κρατήστε αυτό το σύνολο και τρέξτε το μετά από κάθε αλλαγή. Η μελέτη του Barnett σημειώνει ότι η επικύρωση ενός τέτοιου συστήματος “είναι εφικτή μόνο κατά τη λειτουργία”, οπότε προσθέστε τις νέες ερωτήσεις που κάνουν οι άνθρωποι μετά την έναρξη.
Πώς σταματάτε έναν βοηθό AI από το να επινοεί πράγματα;
Ξεκινήστε από τις φθηνότερες διορθώσεις: επιτρέψτε στον βοηθό να λέει “δεν ξέρω” και να περνά τη συζήτηση σε άνθρωπο, βάλτε τον να απαντά μόνο από τα έγγραφά σας με ορατή πηγή και κρατήστε αυτά τα έγγραφα ενημερωμένα. Ακολουθούν η καταγραφή κανόνων, ο περιορισμός της δουλειάς του, η σήμανση ως AI και οι τακτικοί επανέλεγχοι. Τρέξτε ξανά το σύνολο ερωτήσεων μετά από κάθε αλλαγή, για να δείτε ποια βοήθησε.
-
Επιτρέψτε του να λέει “δεν ξέρω” και να παραδίδει. Αλλάξτε τις οδηγίες ώστε, όταν τα έγγραφα δεν περιέχουν την απάντηση, ο βοηθός να το λέει και να περνά τη συζήτηση σε άνθρωπο, μαζί με την ερώτηση και τα στοιχεία επικοινωνίας του πελάτη. Οι ερευνητές της OpenAI λένε το ίδιο από την άλλη πλευρά: τα μοντέλα “μπορούν να απέχουν όταν είναι αβέβαια”. Η παράδοση βοηθά μόνο αν κάποιος την αναλάβει· το άρθρο μας για το αν ένα AI chatbot πρέπει να απαντά στους πελάτες σας εξετάζει πού πρέπει να καταλήγουν αυτές οι παραδόσεις.
-
Βάλτε τον να απαντά μόνο από τα έγγραφά σας και να δείχνει την πηγή. Αυτή η διάταξη λέγεται συχνά retrieval-augmented generation ή RAG: ο βοηθός ψάχνει πρώτα στο υλικό σας και μετά απαντά από τα αποσπάσματα που βρήκε. Η οδηγία της Anthropic είναι να περιορίζεται το μοντέλο σε “πληροφορίες από τα παρεχόμενα έγγραφα και όχι από τη γενική του γνώση”. Μια ορατή πηγή κάτω από κάθε απάντηση επιτρέπει σε πελάτες και προσωπικό να την ελέγξουν και σε εσάς να δείτε ποια σελίδα προκάλεσε ένα λάθος. Στα έργα μας για εφαρμογή AI, ένας βοηθός γνώσης απαντά με σύνδεσμο προς την πηγή, ώστε μια λάθος απάντηση να εντοπίζεται στη σελίδα πίσω της. Περιμένετε κάποια λάθη ακόμη και τότε: ερευνητές του Stanford που δοκίμασαν εργαλεία AI για νομική έρευνα διαπίστωσαν ότι “ακόμη και τα συστήματα RAG δεν είναι απαλλαγμένα από ψευδαισθήσεις”.
-
Καθαρίστε το υλικό που διαβάζει. Μία ισχύουσα εκδοχή για κάθε πολιτική, τιμοκατάλογο και πρότυπο σύμβασης· οι παλιές εκδοχές έξω από τον φάκελο· κάθε έγγραφο με επώνυμο υπεύθυνο που το ενημερώνει όταν αλλάζει ο κανόνας. Αν ο βοηθός απαντά από το CRM σας, το ίδιο ισχύει για τις εγγραφές εκεί, όπως εξηγήσαμε στο άρθρο μας για την ποιότητα δεδομένων στο CRM.
-
Καταγράψτε τους κανόνες που συνεχίζει να επινοεί. Όροι επιστροφής χρημάτων, υποσχέσεις παράδοσης, εκπτώσεις, τι μετρά ως παράπονο. Όπου διακυβεύονται πολλά, δώστε στον βοηθό σταθερή διατύπωση ή κάντε το θέμα ένα από εκείνα όπου άνθρωπος επιβεβαιώνει την απάντηση πριν σταλεί.
-
Περιορίστε τη δουλειά του. Καταγράψτε τι απαντά και τι αρνείται ευγενικά. Οι ερωτήσεις εκτός λίστας παίρνουν μια σύντομη άρνηση και, όπου είναι χρήσιμο, παράδοση σε άνθρωπο.
-
Πείτε στους ανθρώπους ότι μιλούν με AI. Στην ΕΕ, η πράξη για την τεχνητή νοημοσύνη απαιτεί να ενημερώνονται οι άνθρωποι ότι αλληλεπιδρούν με σύστημα AI, εκτός αν αυτό είναι προφανές, το αργότερο κατά την πρώτη αλληλεπίδραση. Η υποχρέωση βαραίνει τον πάροχο του συστήματος και ισχύει από τις 2 Αυγούστου 2026. Η σήμανση των απαντήσεων AI διαμορφώνει επίσης τις προσδοκίες: αφού το bot υποστήριξης της Cursor επινόησε το 2025 μια πολιτική χρήσης, η Cursor άρχισε να σημαίνει τις απαντήσεις AI στην υποστήριξη μέσω email. Στα έργα ιστότοπων όπου προσθέτουμε βοηθό, η ενημέρωση των επισκεπτών ότι μιλούν με AI είναι μέρος της σελίδας από την αρχή.
-
Ελέγχετε ξανά μετά από κάθε αλλαγή. Νέα έγγραφα, αλλαγμένες οδηγίες και ενημερώσεις μοντέλου από τον προμηθευτή μπορούν όλα να αλλάξουν τις απαντήσεις σε ερωτήσεις που παλιά λειτουργούσαν. Τρέξτε το σύνολο ερωτήσεων μετά από καθεμία και πριν από μια φορτωμένη περίοδο.
Τι δεν σταματά από μόνο του τα AI hallucinations;
Τρεις διορθώσεις δοκιμάζονται συχνά πρώτες: μια γραμμή που λέει στο μοντέλο να μην έχει ψευδαισθήσεις, θερμοκρασία 0 και fine-tuning στα δικά σας κείμενα. Η καθεμία αλλάζει μόνο ένα μέρος του βοηθού. Τα στοιχεία που του λείπουν και η άδεια να πει “δεν ξέρω” προέρχονται από τα έγγραφα και τις οδηγίες του, οπότε αν οι λάθος απαντήσεις συνεχιστούν μετά από αυτές τις διορθώσεις, ελέγξτε πρώτα αυτά.
| Τι δοκιμάζουν | Τι αλλάζει | Τι μένει ίδιο |
|---|---|---|
| Μια γραμμή “μην έχεις ψευδαισθήσεις” στις οδηγίες | Πώς διατυπώνεται το αίτημα προς το μοντέλο | Χωρίς άδεια να πει “δεν ξέρω”, το μοντέλο πρέπει ακόμη να δώσει απάντηση |
| Μείωση της θερμοκρασίας στο 0 | Πόσο αλλάζει η διατύπωση από εκτέλεση σε εκτέλεση· η Anthropic σημειώνει ότι ακόμη και στο 0 “τα αποτελέσματα δεν θα είναι πλήρως ντετερμινιστικά” | Τα έγγραφα που διαβάζει ο βοηθός και τα στοιχεία που λείπουν από αυτά |
| Fine-tuning (επιπλέον εκπαίδευση) ενός μοντέλου στα δικά σας κείμενα | Κατά τη γνώμη μας, κυρίως τον τρόπο που το μοντέλο γράφει και συμπεριφέρεται | Τιμές και όροι που αλλάζουν, που ανήκουν σε έγγραφα που διαβάζει τη στιγμή που απαντά |
Πώς ξέρετε ότι οι λάθος απαντήσεις γίνονται σπανιότερες;
Παρακολουθείτε μερικούς αριθμούς από το σύνολο ερωτήσεων και από πραγματικές συνομιλίες, ξεκινώντας πριν από την πρώτη σας διόρθωση, ώστε να έχετε κάτι για σύγκριση. Ελέγξτε τους μετά από κάθε αλλαγή και έπειτα σε τακτική βάση, όταν ο βοηθός σταθεροποιηθεί, και διαβάζετε τις ίδιες τις λάθος απαντήσεις παράλληλα με τα σύνολα.
- Σωστές απαντήσεις στο σύνολο ερωτήσεών σας, μαζί με τις ερωτήσεις όπου η σωστή απάντηση είναι “δεν ξέρω”.
- Λάθος απαντήσεις ανά εβδομάδα και αιτία, από την ανάγνωση πραγματικών συνομιλιών. Μια αιτία που επανέρχεται είναι η επόμενη διόρθωση.
- Παραδόσεις που ανέλαβε άνθρωπος, και πόσο περίμεναν. Μια παράδοση που δεν απαντά κανείς συχνά καταλήγει με τον πελάτη να φεύγει ούτως ή άλλως.
- Απαντήσεις που δείχνουν πηγή. Αν μεγαλώνει το ποσοστό των απαντήσεων χωρίς πηγή, ελέγξτε αν τα έγγραφα καλύπτουν ακόμη τις ερωτήσεις που κάνουν οι άνθρωποι.
Πού μπαίνουμε εμείς
Ξεκινάμε από τις ερωτήσεις και τα έγγραφά σας: το σύνολο ερωτήσεων, τις σωστές απαντήσεις και τις πηγές που πρέπει να χρησιμοποιεί ο βοηθός. Μετά στήνουμε τον βοηθό να απαντά από αυτό το υλικό με ορατή πηγή και με άνθρωπο που εγκρίνει τις απαντήσεις όπου έχει σημασία. Συνεχίζουμε να τον ελέγχουμε με το σύνολο ερωτήσεων ως μέρος των τακτικών ελέγχων ποιότητας. Αν κάποιος βοηθός σας δίνει ήδη λάθος απαντήσεις, το brief είναι ο πιο απλός τρόπος να μας δείξετε πού.