Zákazník vám přepošle chat: asistent na vašem webu mu napsal, že vrácení zboží je zdarma šedesát dní, přičemž vaše pravidla říkají třicet. Nebo kolega cituje smluvní ustanovení, které interní asistent “našel”, a nikdo ho ve smlouvě nemůže najít. V obou případech jde o halucinace AI, tedy špatné odpovědi podané s naprostou jistotou. Stručná odpověď: chyby úplně vypnout nejde, ale obvykle zjistíte, o jaký druh chyby jde, a můžete zařídit, aby sebejisté špatné odpovědi byly vzácné, viditelné a předané člověku.
Obvyklé reakce jsou obvinit model, přidat do instrukcí “nevymýšlej si” nebo asistenta vypnout. Příčina bývá často všednější: asistent dostal otázku, na kterou jeho podklady neodpovídají, přečetl špatnou stránku, nebo mu nikdo neřekl, že “nevím” je přijatelná odpověď. Každá z těchto příčin zanechává stopu, kterou si můžete ověřit sami.
Proč vznikají halucinace AI ve vašem asistentovi?
Jazykový model píše nejpravděpodobnější další slova. Když má fakt před sebou, pravděpodobná odpověď bývá správná. Když ho nemá, stejně napíše něco plynulého. NIST tomu říká konfabulace: “sebejistě podaný, ale chybný nebo nepravdivý obsah”, hovorově známý jako halucinace.
Výzkumníci OpenAI tu sebejistotu vysvětlují: standardní trénink a hodnocení “odměňují hádání víc než přiznání nejistoty”. Centrum nápovědy OpenAI dodává, že “sebejistota není spolehlivost”: plynulá, jistá odpověď může být přesto špatná. Ve firemním asistentovi se tento obecný zvyk projevuje přes několik konkrétních mezer.
Odpověď v jeho podkladech není. Zákazník se ptá na službu, kterou už nenabízíte, na zemi, kam jste nikdy nedoručovali, nebo na slevu, kterou nikdy nikdo nesepsal. Studie asistentů založených na dokumentech od Barnetta a kolegů to uvádí jako první bod selhání: otázku, “na kterou nelze odpovědět z dostupných dokumentů”. Asistent hádá ze svých obecných znalostí, a tak vzniká věrohodná, ale vymyšlená lhůta pro vrácení.
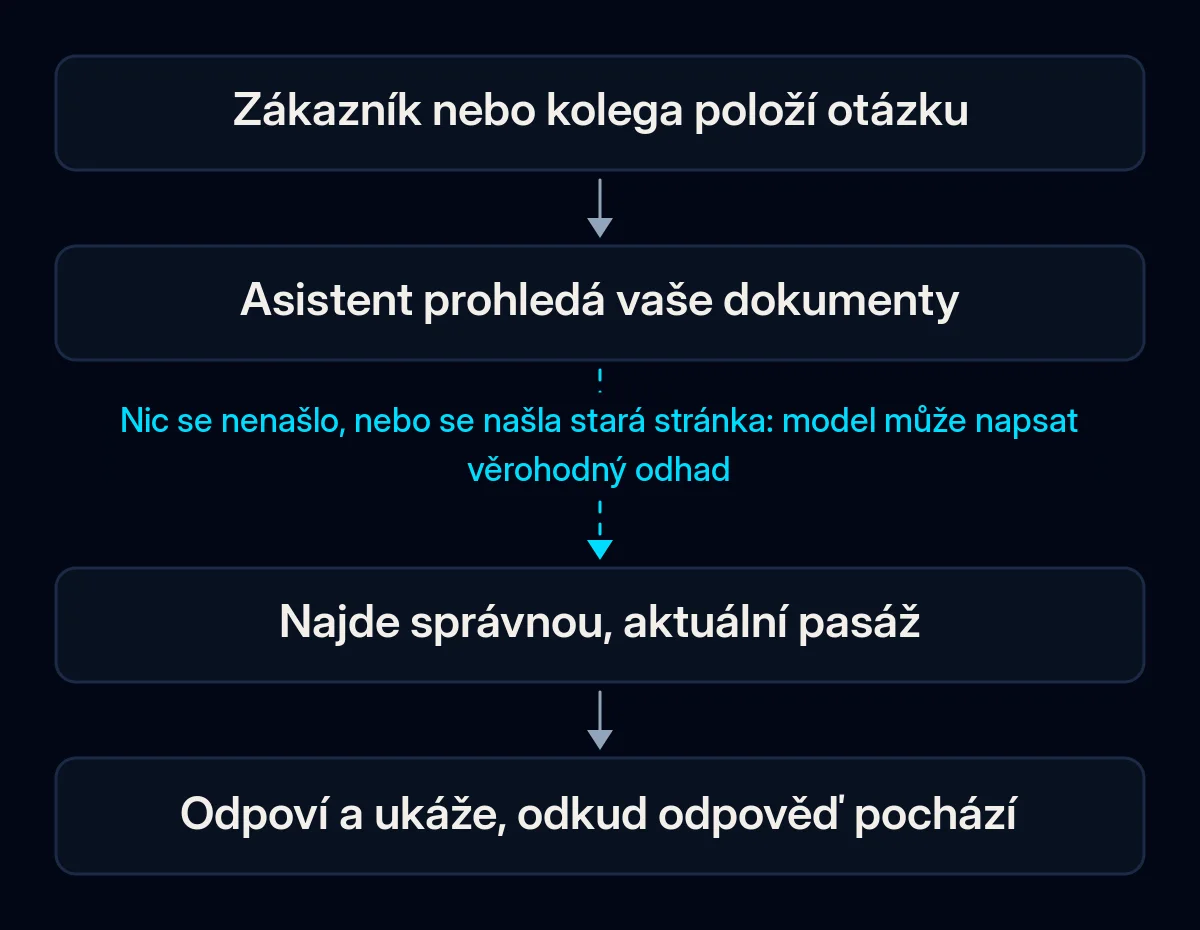
Našel špatnou stránku. Asistent nejdřív prohledá vaše dokumenty a odpovídá z toho, co najde, takže pokud loňský ceník, návrh pravidel a aktuální verze leží ve stejné složce, může citovat kterýkoli z nich. Doporučení Microsoftu ke kontrole odpovědí proti zdrojům začínají stejně: samotné zdroje musí být “přesné a aktuální”. Tuto příčinu poznáte podle toho, že špatná odpověď se někde ve vašich souborech ukáže jako pravdivá, jen zastaralá.
Pravidlo existuje jen v něčí hlavě. Váš tým ví, že vrácení peněz nad určitou částku musí schválit vedoucí, nebo že v prosinci neslibujete termíny doručení. Když nic, co asistent čte, toto pravidlo neobsahuje, zaplní mezeru vlastním, rozumně znějícím pravidlem.
Otázka je mimo jeho úkol. Asistent nastavený na otevírací dobu a rezervace dostane dotaz na právní, zdravotní nebo cenovou radu. Bez pokynu odmítnout se snaží pomoct.
Nic mu nedovoluje říct “nevím”. Instrukce jako “vždy zákazníkovi pomoz” mohou model tlačit k odpovědi, i když nemá z čeho odpovídat. Dokumentace Anthropic uvádí, že výslovné dovolení přiznat nejistotu “může drasticky omezit nepravdivé informace”.
Tyto mezery leží na jedné cestě od otázky k odpovědi a odpověď se pokazí v prvním kroku, který selže.
Kdo odpovídá za to, co asistent řekne?
V jednom známém případě firma. Ve věci Moffatt v. Air Canada (2024) chatbot letecké společnosti naznačil zákazníkovi, že o zvláštní tarif pro pozůstalé může požádat zpětně, což pravidla aerolinky neumožňovala. Tribunál v Britské Kolumbii shledal, že “nezáleží na tom, zda informace pochází ze statické stránky, nebo z chatbota”. Konstatoval, že aerolinka “nevynaložila přiměřenou péči, aby zajistila přesnost svého chatbota”, a přiznal zákazníkovi 812,02 CA$.
Stejný princip platí pro asistenty, které používají vaši zaměstnanci. Ve věci Mata v. Avianca (2023) americký soud nařídil dvěma advokátům a jejich kanceláři zaplatit společně pokutu 5 000 USD poté, co předložili soudní rozhodnutí vymyšlená ChatGPT a trvali na nich i ve chvíli, kdy na ně byli dotázáni. Soud uvedl, že na používání spolehlivého nástroje AI není “nic samo o sobě nepatřičného”, ale ten, kdo podání předkládá, si ponechává “roli strážce” jeho správnosti. Když někdo přepošle zákazníkovi špatnou odpověď interního asistenta, zákazník ji nejspíš bude brát jako odpověď vaší firmy.
Jak zjistit, která příčina je ta vaše
Abyste našli příčinu špatných odpovědí AI, sestavte sadu skutečných otázek a každou odpověď porovnejte s tím, o čem víte, že je pravda. Nepotřebujete placené nástroje, jen asistenta, své dokumenty a přístup k historii jeho konverzací. Špatné odpovědi dohromady ukážou, kterou mezeru zavřít jako první.
- Sepište skutečné otázky. Vezměte je z nedávných chatů, e-mailů a hovorů, vlastními slovy zákazníků. Přidejte otázky, na které vaše dokumenty neodpovídají, a několik mimo úkol asistenta.
- Ke každé napište správnou odpověď. U otázek bez odpovědi v podkladech je správná odpověď “nevím, předám vás kolegovi”.
- Položte asistentovi každou otázku a některé zopakujte jinými slovy. Pokud se fakta v odpovědi mezi běhy mění, asistent je pravděpodobně hádá.
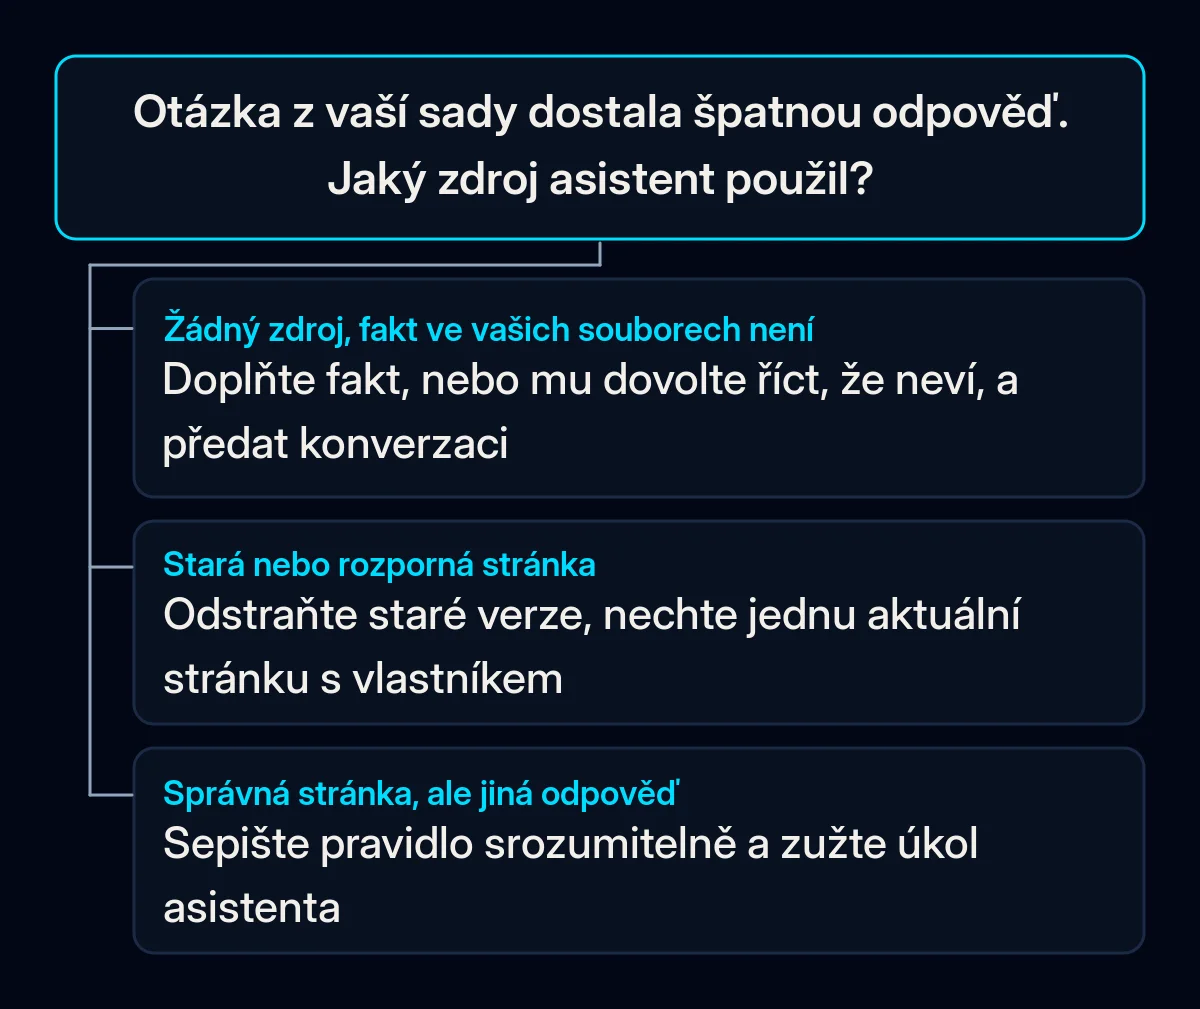
- U každé špatné odpovědi se podívejte, z čeho vycházel. Mnoho znalostních asistentů umí ukázat zdrojovou pasáž nebo zaznamenává, které dokumenty načetli; ověřte, jestli to umí ten váš. Poznamenejte si, jestli zdroj chyběl, byl starý či rozporný, nebo byl správný, ale asistent ho špatně pochopil.
- Roztřiďte špatné odpovědi podle příčin. Chybějící dokument, špatný nebo zastaralý dokument, nesepsané pravidlo, mimo úkol, nebo případ, který stejně potřeboval člověka. Největší skupina je místo, kde začít.
Tuto sadu si ponechte a spouštějte ji po každé změně. Barnettova studie upozorňuje, že validace takového systému “je proveditelná jen za provozu”, takže přidávejte nové otázky, které lidé kladou po spuštění.
Jak zařídit, aby si asistent AI přestal vymýšlet?
Začněte nejlevnějšími opravami: dovolte asistentovi říct “nevím” a předat konverzaci člověku, nechte ho odpovídat jen z vašich dokumentů s viditelným zdrojem a udržujte ty dokumenty aktuální. Pak přijde na řadu sepsání pravidel, zúžení úkolu, označení, že jde o AI, a pravidelné testy. Po každé změně sadu otázek spusťte znovu, abyste viděli, která pomohla.
-
Dovolte mu říct “nevím” a předat konverzaci. Upravte instrukce tak, aby asistent, když dokumenty odpověď neobsahují, to řekl a předal konverzaci člověku i s dotazem zákazníka a jeho kontaktem. Výzkumníci OpenAI říkají totéž z druhé strany: modely “se mohou zdržet odpovědi, když si nejsou jisté”. Předání pomůže, jen když ho někdo převezme; náš článek o tom, jestli má AI chatbot odpovídat vašim zákazníkům, popisuje, kam by taková předání měla směřovat.
-
Nechte ho odpovídat jen z vašich dokumentů a ukazovat zdroj. Tomuto uspořádání se často říká generování rozšířené o vyhledávání, neboli RAG: asistent nejdřív prohledá vaše podklady a pak odpovídá z nalezených pasáží. Anthropic doporučuje omezit model na “informace z poskytnutých dokumentů, nikoli na jeho obecné znalosti”. Viditelný zdroj pod každou odpovědí umožní zákazníkům i zaměstnancům ji ověřit a vám uvidět, která stránka chybu způsobila. V našich projektech zavádění AI odpovídá znalostní asistent s odkazem na zdroj, takže špatnou odpověď lze dohledat ke stránce, ze které vychází. I tak počítejte s nějakými chybami: výzkumníci ze Stanfordu, kteří testovali nástroje AI pro právní rešerše, zjistili, že “ani systémy RAG nejsou bez halucinací”.
-
Vyčistěte podklady, které čte. Jedna aktuální verze každých pravidel, ceníku a vzoru smlouvy; staré verze pryč ze složky; každý dokument s určeným vlastníkem, který ho aktualizuje, když se pravidlo změní. Pokud asistent odpovídá z vašeho CRM, platí totéž pro záznamy v něm, jak jsme popsali v článku o kvalitě dat v CRM.
-
Sepište pravidla, která si pořád vymýšlí. Podmínky vrácení peněz, sliby doručení, slevy, co se počítá jako reklamace. Kde jde o hodně, dejte asistentovi pevnou formulaci, nebo z toho udělejte téma, u kterého odpověď před odesláním potvrdí člověk.
-
Zužte jeho úkol. Sepište, na co odpovídá a co zdvořile odmítá. Otázky mimo seznam dostanou krátké odmítnutí a tam, kde to dává smysl, předání člověku.
-
Řekněte lidem, že mluví s AI. V EU akt o umělé inteligenci vyžaduje, aby lidé byli informováni, že komunikují se systémem AI, pokud to není zřejmé, a to nejpozději při první interakci. Povinnost má poskytovatel systému a platí od 2. srpna 2026. Označení odpovědí AI také nastavuje očekávání: poté, co si jeho podpůrný bot v roce 2025 vymyslel pravidlo používání, začal Cursor označovat odpovědi AI v e-mailové podpoře. V projektech tvorby webů, do kterých přidáváme asistenta, je informace pro návštěvníky, že mluví s AI, součástí stránky od začátku.
-
Po každé změně znovu testujte. Nové dokumenty, upravené instrukce i aktualizace modelu od dodavatele mohou změnit odpovědi na otázky, které dřív fungovaly. Spusťte sadu otázek po každé z nich a před rušnou sezónou.
Co samo o sobě halucinace AI nezastaví?
Tři opravy se často zkoušejí jako první: věta, která modelu zakazuje halucinovat, teplota 0 a fine-tuning na vlastních textech. Každá mění jen jednu část asistenta. Chybějící fakta a dovolení říct “nevím” pocházejí z jeho dokumentů a instrukcí, takže pokud špatné odpovědi po těchto opravách pokračují, zkontrolujte nejdřív je.
| Co lidé zkoušejí | Co to mění | Co zůstává stejné |
|---|---|---|
| Věta “nehalucinuj” v instrukcích | Jak je formulován požadavek na model | Bez dovolení říct “nevím” model stále musí vytvořit odpověď |
| Snížení teploty na 0 | Jak moc se formulace liší mezi běhy; Anthropic upozorňuje, že ani při 0 “nebudou výsledky plně deterministické” | Dokumenty, které asistent čte, a fakta, která v nich chybí |
| Fine-tuning (dotrénování) modelu na vlastních textech | Podle nás hlavně to, jak model píše a jak se chová | Ceny a podmínky, které se mění a patří do dokumentů čtených v okamžiku odpovědi |
Jak poznáte, že špatných odpovědí ubývá?
Sledujte několik čísel ze sady otázek a ze skutečných konverzací a začněte ještě před první opravou, abyste měli s čím srovnávat. Kontrolujte je po každé změně, a jakmile se asistent ustálí, v pravidelném intervalu, a vedle součtů čtěte i samotné špatné odpovědi.
- Správné odpovědi na sadu otázek, včetně otázek, kde je správná odpověď “nevím”.
- Špatné odpovědi za týden podle příčin, ze čtení skutečných konverzací. Příčina, která se stále vrací, je další oprava.
- Předání převzatá člověkem a jak dlouho čekala. Předání, na které nikdo neodpoví, často skončí tím, že zákazník stejně odejde.
- Odpovědi se zdrojem. Pokud roste podíl odpovědí bez zdroje, ověřte, jestli dokumenty stále pokrývají otázky, které lidé kladou.
Kde vstupujeme my
Začínáme od vašich otázek a dokumentů: sady otázek, správných odpovědí a zdrojů, které má asistent používat. Pak asistenta nastavíme tak, aby odpovídal z těchto podkladů s viditelným zdrojem a tam, kde na tom záleží, s člověkem, který odpovědi schvaluje. Dál ho kontrolujeme sadou otázek v rámci pravidelných kontrol kvality. Pokud už váš asistent dává špatné odpovědi, nejjednodušší cesta, jak nám ukázat kde, je brief.