Een klant stuurt u een chat door: de assistent op uw website zei dat retourneren zestig dagen gratis is, terwijl in uw voorwaarden dertig staat. Of een collega citeert een contractbepaling die de interne assistent “gevonden” heeft, en niemand kan haar in het contract terugvinden. In beide gevallen geeft AI verkeerde antwoorden: zogenoemde AI-hallucinaties. Het korte antwoord: u kunt de fouten niet helemaal uitschakelen, maar meestal kunt u vaststellen om welk soort fout het gaat en ervoor zorgen dat stellige foute antwoorden zeldzaam en zichtbaar worden en bij een mens terechtkomen.
De gebruikelijke reacties zijn het model de schuld geven, “verzin niets” aan de instructies toevoegen of de assistent uitzetten. Vaak is de oorzaak alledaagser: de assistent kreeg een vraag waarop zijn materiaal geen antwoord geeft, hij las de verkeerde pagina, of niemand vertelde hem dat “dat weet ik niet” een acceptabel antwoord is. Elk van deze oorzaken laat een spoor na dat u zelf kunt controleren.
Waarom geeft uw AI verkeerde antwoorden?
Een taalmodel schrijft de meest aannemelijke volgende woorden. Als het het feit voor zich heeft, is het aannemelijke antwoord meestal het juiste. Als het dat niet heeft, schrijft het toch iets vloeiends, en NIST noemt dit confabulatie: “met stelligheid gebrachte maar onjuiste of valse inhoud”, in de volksmond bekend als hallucinaties.
De onderzoekers van OpenAI verklaren die stelligheid: gangbare training en evaluatie “belonen gokken boven het erkennen van onzekerheid”. Het helpcentrum van OpenAI voegt eraan toe dat “zelfvertrouwen geen betrouwbaarheid is”: een vloeiend, zeker antwoord kan nog steeds fout zijn. In een zakelijke assistent ontstaan AI-hallucinaties door een paar specifieke gaten.
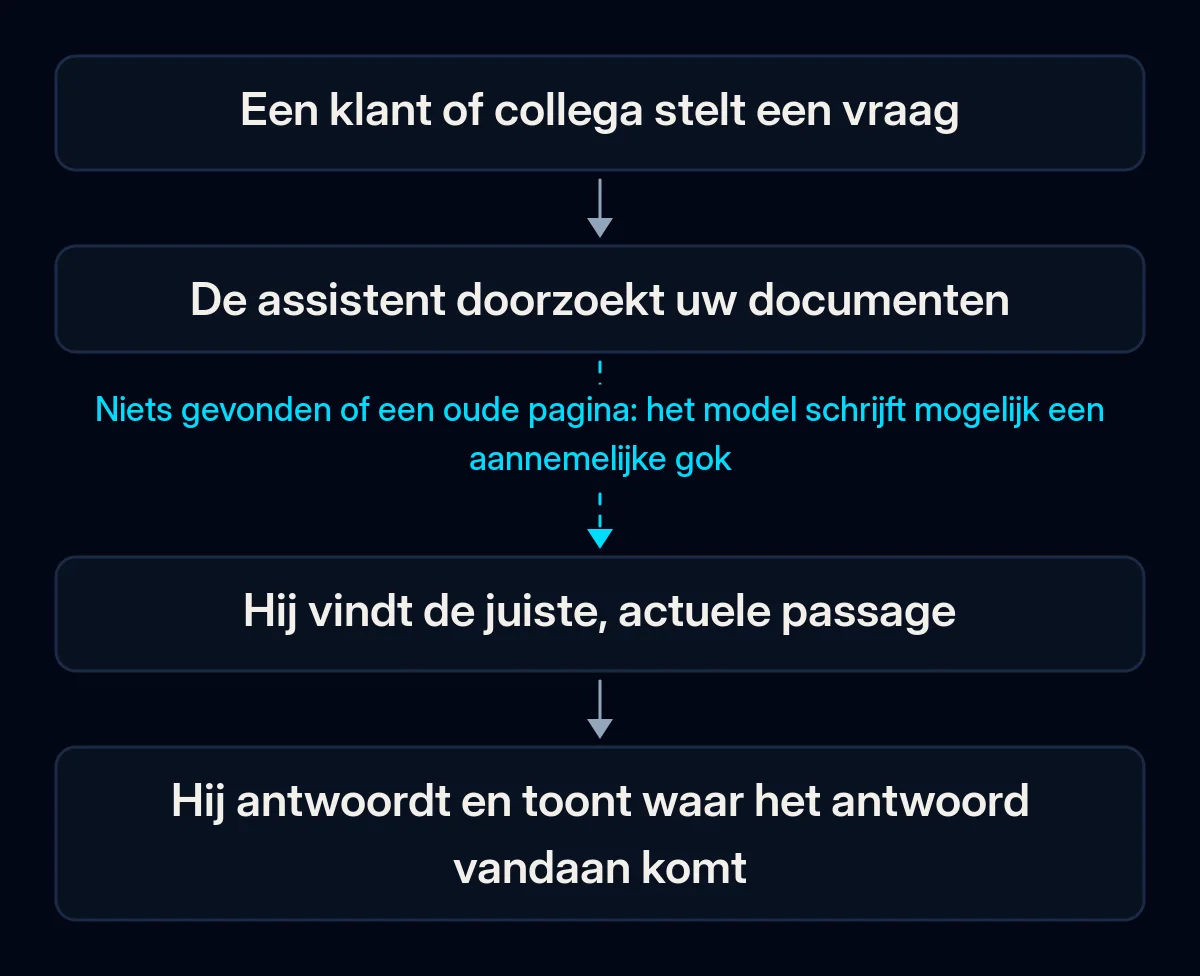
Het antwoord staat niet in zijn materiaal. Een klant vraagt naar een dienst die u niet meer aanbiedt, een land waar u nooit naartoe hebt verzonden of een korting die nooit op papier is gezet. Een studie van Barnett en collega’s naar assistenten die met documenten werken noemt dit het eerste faalpunt: een vraag “die niet met de beschikbare documenten te beantwoorden is”. De assistent gokt op basis van zijn algemene kennis, en zo ontstaat een aannemelijke maar verzonnen retourtermijn.
Hij vond de verkeerde pagina. De assistent doorzoekt eerst uw documenten en antwoordt op basis van wat hij vindt. Staan de prijslijst van vorig jaar, een conceptbeleid en het huidige beleid in dezelfde map, dan kan hij uit elk ervan citeren. De richtlijnen van Microsoft voor het toetsen van antwoorden aan bronnen beginnen bij hetzelfde punt: de bronnen zelf moeten “juist en actueel” zijn. U herkent deze oorzaak wanneer het foute antwoord ergens in uw bestanden wel klopt, alleen verouderd.
De regel bestaat alleen in iemands hoofd. Uw team weet dat terugbetalingen boven een bepaald bedrag een manager nodig hebben, of dat u in december geen levertijden belooft. Als niets wat de assistent leest die regel bevat, vult hij het gat met een eigen beleid dat redelijk klinkt.
De vraag valt buiten zijn taak. Een assistent die is ingericht voor openingstijden en reserveringen krijgt een vraag om juridisch, medisch of prijsadvies. Zonder instructie om te weigeren probeert hij te helpen.
Niets staat hem toe “dat weet ik niet” te zeggen. Instructies als “help de klant altijd” kunnen het model ertoe brengen te antwoorden, zelfs als het nergens op kan bouwen. De documentatie van Anthropic zegt dat het model uitdrukkelijk toestaan onzekerheid toe te geven “valse informatie drastisch kan verminderen”.
Deze gaten liggen op één route van vraag naar antwoord, en het antwoord gaat mis bij de eerste stap die faalt.
Wie is verantwoordelijk voor wat de assistent zegt?
In een bekende zaak was dat het bedrijf. In Moffatt v. Air Canada (2024) suggereerde de chatbot van de luchtvaartmaatschappij dat een klant achteraf een rouwtarief kon aanvragen, wat het beleid van de maatschappij niet toestond. Het tribunaal in British Columbia oordeelde dat “het geen verschil maakt of de informatie van een statische pagina of van een chatbot komt”. Het stelde vast dat de maatschappij “geen redelijke zorg heeft betracht om ervoor te zorgen dat haar chatbot juist was”, en kende de klant CA$ 812,02 toe.
Hetzelfde principe geldt voor assistenten die uw medewerkers gebruiken. In Mata v. Avianca (2023) veroordeelde een Amerikaanse rechtbank twee advocaten en hun kantoor tot een gezamenlijke boete van $ 5.000, nadat zij door ChatGPT verzonnen rechterlijke uitspraken hadden ingediend en daar bij vragen aan bleven vasthouden. De rechtbank zei dat er “niets inherent ongepasts” is aan het gebruik van een betrouwbaar AI-hulpmiddel, maar dat wie stukken indient een “poortwachtersrol” houdt voor de juistheid. Stuurt iemand het foute antwoord van een interne assistent door naar een klant, dan leest de klant het waarschijnlijk als het antwoord van uw bedrijf.
Zo vindt u uw oorzaak
Om te achterhalen waarom uw AI verkeerde antwoorden geeft, verzamelt u een reeks echte vragen en legt u elk antwoord naast wat u weet dat klopt. U hebt geen betaalde tools nodig, alleen de assistent, uw documenten en toegang tot de gespreksgeschiedenis. Samen laten de foute antwoorden zien welk gat u het eerst moet dichten.
- Schrijf echte vragen op. Haal ze uit recente chats, e-mails en telefoongesprekken, in de woorden van de klant zelf. Voeg vragen toe waarop uw documenten geen antwoord geven, en een paar die buiten de taak van de assistent vallen.
- Zet bij elke vraag het juiste antwoord. Voor de vragen zonder antwoord in uw materiaal is het juiste antwoord “Dat weet ik niet, ik verbind u door met een collega”.
- Stel de assistent elke vraag en stel sommige opnieuw in andere woorden. Veranderen de feiten in een antwoord van keer tot keer, dan gokt de assistent ze waarschijnlijk.
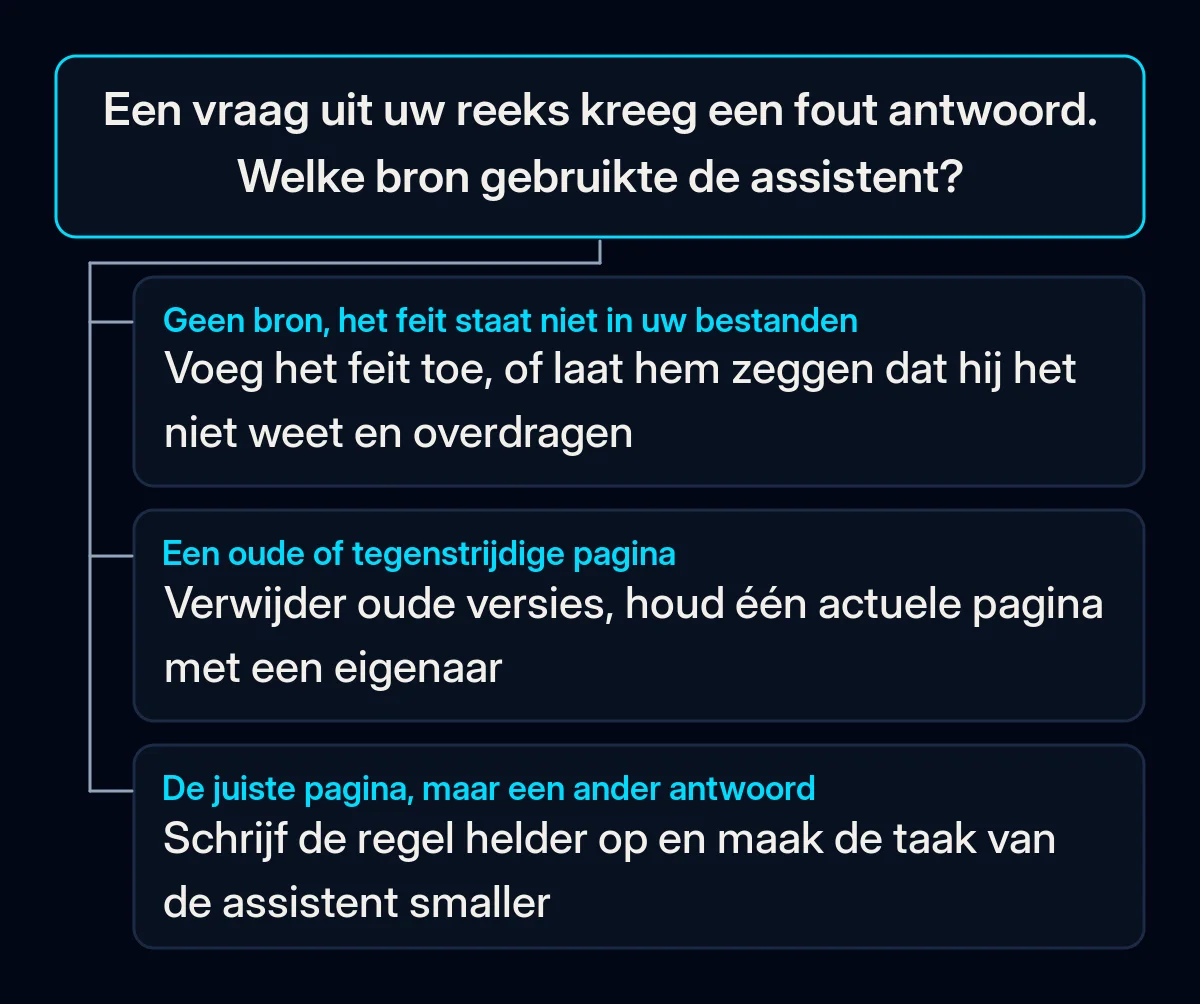
- Kijk bij elk fout antwoord wat hij heeft gebruikt. Veel kennisassistenten kunnen de bronpassage tonen of vastleggen welke documenten ze hebben opgehaald; ga na of de uwe dat doet. Noteer of er geen bron was, een oude of tegenstrijdige bron, of de juiste bron die hij verkeerd las.
- Sorteer de foute antwoorden op oorzaak. Geen document, verkeerd of verouderd document, ongeschreven regel, buiten de taak, of een geval dat sowieso een mens nodig had. De grootste groep is waar u begint.
Bewaar deze reeks en draai hem na elke wijziging opnieuw. Het artikel van Barnett merkt op dat het valideren van zo’n systeem “alleen tijdens gebruik haalbaar is”, dus voeg de nieuwe vragen toe die mensen na de lancering stellen.
Hoe voorkomt u dat een AI-assistent dingen verzint?
Begin met de goedkoopste oplossingen: laat de assistent “dat weet ik niet” zeggen en het gesprek aan een mens overdragen, laat hem alleen uit uw documenten antwoorden met een zichtbare bron, en houd die documenten actueel. Daarna volgen regels op papier, een smallere taak, vermelden dat het om AI gaat en regelmatige hertests. Draai uw vragenreeks na elke wijziging opnieuw, zodat u ziet welke heeft geholpen.
-
Laat hem “dat weet ik niet” zeggen en overdragen. Pas de instructies aan zodat de assistent, als het antwoord niet in de documenten staat, dat zegt en het gesprek aan een mens overdraagt, met de vraag en de contactgegevens van de klant erbij. De onderzoekers van OpenAI zeggen hetzelfde van de andere kant: modellen “kunnen zich onthouden wanneer ze onzeker zijn”. Een overdracht helpt alleen als iemand hem oppakt; in ons stuk over een AI chatbot voor bedrijven leest u waar die overdrachten terecht moeten komen.
-
Laat hem alleen uit uw documenten antwoorden en de bron tonen. Deze opzet heet vaak retrieval-augmented generation, of RAG: de assistent doorzoekt eerst uw materiaal en antwoordt dan op basis van de gevonden passages. Het advies van Anthropic is het model te beperken tot “informatie uit aangeleverde documenten en niet zijn algemene kennis”. Een zichtbare bron onder elk antwoord laat klanten en medewerkers het controleren, en laat u zien welke pagina een fout veroorzaakte. In onze projecten voor AI-implementatie antwoordt een kennisassistent met een link naar de bron, zodat een fout antwoord terug te voeren is op de pagina erachter. Reken ook dan op enkele fouten: onderzoekers van Stanford die AI-tools voor juridisch onderzoek testten, ontdekten dat “zelfs RAG-systemen niet vrij van hallucinaties zijn”.
-
Ruim het materiaal op dat hij leest. Eén actuele versie van elk beleid, elke prijslijst en elk contractsjabloon; oude versies uit de map; elk document met een benoemde eigenaar die het bijwerkt als de regel verandert. Antwoordt de assistent uit uw CRM, dan geldt hetzelfde voor de records daarin, zoals we beschreven in ons stuk over datakwaliteit in uw CRM.
-
Schrijf de regels op die hij blijft verzinnen. Terugbetalingsvoorwaarden, leverbeloften, kortingen, wat als klacht telt. Waar veel op het spel staat, geeft u de assistent een vaste formulering, of maakt u van dat onderwerp er een waarbij een mens het antwoord bevestigt voordat het verstuurd wordt.
-
Maak zijn taak smaller. Leg vast waarop hij antwoordt en wat hij beleefd afwijst. Vragen buiten die lijst krijgen een korte weigering en, waar nuttig, een overdracht.
-
Vertel mensen dat ze met AI praten. In de EU vereist de verordening artificiële intelligentie dat mensen worden geïnformeerd dat zij interageren met een AI-systeem, tenzij dat duidelijk is, uiterlijk bij de eerste interactie. De plicht ligt bij de aanbieder van het systeem en geldt sinds 2 augustus 2026. AI-antwoorden labelen schept ook verwachtingen: nadat de supportbot van Cursor in 2025 een gebruiksbeleid had verzonnen, begon het bedrijf AI-antwoorden in de e-mailsupport te labelen. In de websiteprojecten waarin we een assistent toevoegen, hoort de melding aan bezoekers dat ze met AI praten vanaf het begin bij de pagina.
-
Test opnieuw na elke wijziging. Nieuwe documenten, aangepaste instructies en modelupdates van de leverancier kunnen allemaal de antwoorden veranderen op vragen die eerder goed gingen. Draai de vragenreeks na elke wijziging en voor een drukke periode.
Wat stopt AI-hallucinaties niet op zichzelf?
Drie oplossingen worden vaak als eerste geprobeerd: een regel die het model opdraagt niet te hallucineren, een temperatuur van 0 en fine-tuning op uw eigen teksten. Elk ervan verandert maar één deel van de assistent. De feiten die hij mist en de toestemming om “dat weet ik niet” te zeggen komen uit zijn documenten en instructies, dus als de AI-hallucinaties na deze oplossingen doorgaan, kijk daar dan eerst naar.
| Wat men probeert | Wat het verandert | Wat hetzelfde blijft |
|---|---|---|
| Een regel “niet hallucineren” in de instructies | Hoe het verzoek aan het model is geformuleerd | Zonder toestemming om “dat weet ik niet” te zeggen, moet het model nog steeds een antwoord geven |
| De temperatuur verlagen naar 0 | Hoeveel de formulering van keer tot keer varieert; Anthropic merkt op dat zelfs bij 0 “de resultaten niet volledig deterministisch zullen zijn” | De documenten die de assistent leest, en de feiten die daarin ontbreken |
| Fine-tuning (verdere training) van een model op uw eigen teksten | Volgens ons vooral hoe het model schrijft en zich gedraagt | Prijzen en voorwaarden die veranderen, en die thuishoren in documenten die hij op het moment van antwoorden leest |
Hoe weet u dat de foute antwoorden minder worden?
Houd een paar cijfers bij uit de vragenreeks en uit echte gesprekken, en begin daarmee voor uw eerste aanpassing, zodat u iets hebt om mee te vergelijken. Controleer ze na elke wijziging, daarna op een vast schema zodra de assistent stabiel is, en lees naast de totalen ook de foute antwoorden zelf.
- Juiste antwoorden op uw vragenreeks, inclusief de vragen waarop “dat weet ik niet” het juiste antwoord is.
- Foute antwoorden per week per oorzaak, uit het lezen van echte gesprekken. Een oorzaak die steeds terugkomt, is de volgende oplossing.
- Overdrachten die een mens oppakt, en hoe lang die wachtten. Een overdracht waar niemand op reageert, eindigt vaak alsnog met een klant die vertrekt.
- Antwoorden met een bron. Groeit het aandeel antwoorden zonder bron, ga dan na of de documenten de vragen die mensen stellen nog dekken.
Waar wij instappen
We beginnen bij uw vragen en documenten: de vragenreeks, de juiste antwoorden en de bronnen die de assistent moet gebruiken. Daarna richten we de assistent zo in dat hij uit dat materiaal antwoordt, met een zichtbare bron en met een mens die antwoorden goedkeurt waar het ertoe doet. We blijven hem toetsen aan de vragenreeks als onderdeel van regelmatige kwaliteitscontroles. Geeft een assistent van u al verkeerde antwoorden, dan is de briefing de eenvoudigste manier om ons te laten zien waar.