En kunde videresender en chat: Assistenten på dit website har lovet gratis returnering i tres dage, mens jeres regler siger tredive. Eller en kollega citerer en kontraktklausul, som den interne assistent har “fundet”, og som ingen kan finde i kontrakten. Begge er eksempler på AI hallucinationer: AI’en giver forkerte svar med fuld selvsikkerhed. Det korte svar er, at du ikke kan slå fejlene helt fra, men du kan som regel finde ud af, hvilken slags fejl det er, og gøre selvsikre forkerte svar sjældne, synlige og givet videre til et menneske.
De typiske reaktioner er at give modellen skylden, at tilføje “find ikke på noget” i instruktionerne eller at slukke for assistenten. Ofte er årsagen mere banal: Assistenten fik et spørgsmål, som dens materiale ikke besvarer, den læste den forkerte side, eller ingen fortalte den, at “det ved jeg ikke” er et acceptabelt svar. Hver af disse årsager efterlader spor, som du selv kan tjekke.
Hvorfor opstår AI hallucinationer i din assistent?
En sprogmodel skriver de mest sandsynlige næste ord. Når den har faktummet foran sig, er det sandsynlige svar som regel det rigtige. Når den ikke har det, skriver den stadig noget, der lyder flydende, og NIST kalder det konfabulation: “indhold, der fremføres med selvsikkerhed, men er fejlagtigt eller falsk”, i daglig tale kendt som hallucinationer.
OpenAIs forskere forklarer selvsikkerheden: Almindelig træning og evaluering “belønner gætteri frem for at erkende usikkerhed”. Virksomhedens hjælpecenter tilføjer, at “selvsikkerhed er ikke det samme som pålidelighed”: Et flydende og sikkert svar kan stadig være forkert. I en virksomheds assistent viser den generelle vane sig gennem nogle få konkrete huller.
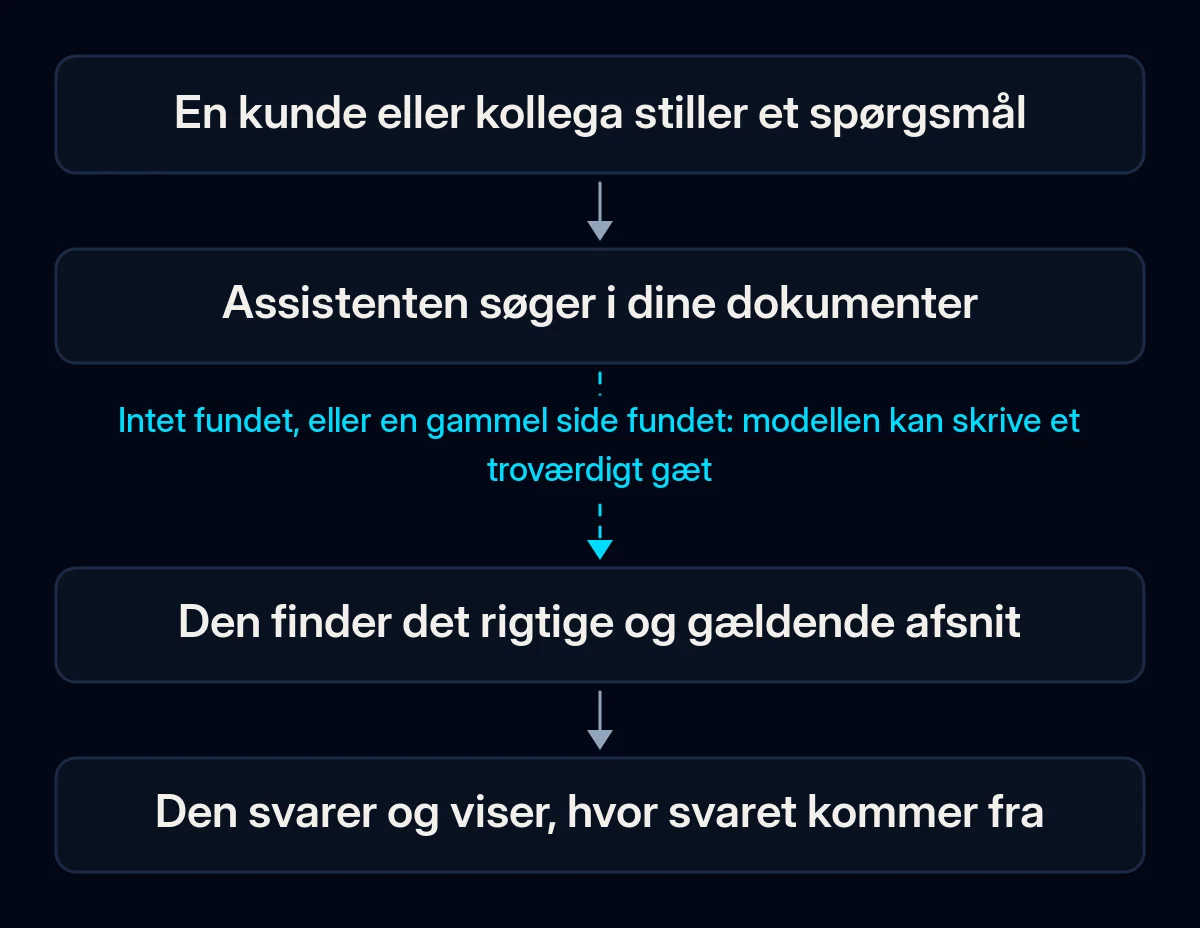
Svaret findes ikke i materialet. En kunde spørger om en ydelse, I er holdt op med at tilbyde, et land, I aldrig har sendt til, eller en rabat, der aldrig blev skrevet ned. Et studie af dokumentbaserede assistenter fra Barnett og kolleger nævner dette som det første fejlpunkt: et spørgsmål, “som ikke kan besvares ud fra de tilgængelige dokumenter”. Assistenten gætter ud fra sin generelle viden, og sådan opstår en troværdig, men opdigtet returperiode.
Den fandt den forkerte side. Assistenten søger først i dine dokumenter og svarer ud fra det, den finder. Ligger sidste års prisliste, et udkast til en politik og den gældende version i samme mappe, kan den citere en hvilken som helst af dem. Microsofts vejledning om at kontrollere svar mod kilder tager udgangspunkt samme sted: Kilderne skal selv være “korrekte og opdaterede”. Du genkender denne årsag, når det forkerte svar viser sig at stå et sted i jeres filer, bare i en forældet version.
Reglen findes kun i nogens hoved. Dit team ved, at refusioner over et vist beløb skal godkendes af en leder, eller at I ikke lover leveringsdatoer i december. Når intet af det, assistenten læser, indeholder reglen, fylder den hullet med en fornuftigt klingende regel, den selv har fundet på.
Spørgsmålet ligger uden for dens opgave. En assistent, der er sat op til åbningstider og bookinger, bliver spurgt om juridisk, medicinsk eller prismæssig rådgivning. Uden en instruks om at sige nej prøver den at hjælpe.
Intet giver den lov til at sige “det ved jeg ikke”. Instruktioner som “hjælp altid kunden” kan presse modellen til at svare, selv når den ikke har noget at svare ud fra. Anthropics dokumentation siger, at det at give modellen eksplicit lov til at indrømme usikkerhed “kan reducere falske oplysninger drastisk”.
Disse huller ligger langs én vej fra spørgsmål til svar, og svaret går galt ved det første trin, der svigter.
Hvem står inde for det, assistenten siger?
Det gjorde virksomheden i en kendt sag. I Moffatt v. Air Canada (2024) antydede flyselskabets chatbot, at en kunde kunne søge om en sorgrabat med tilbagevirkende kraft, hvilket flyselskabets regler ikke tillod. Tribunalet i British Columbia fastslog: “Det gør ingen forskel, om oplysningerne kommer fra en statisk side eller en chatbot”. Det fandt, at flyselskabet “ikke udviste rimelig omhu for at sikre, at dens chatbot var korrekt”, og tilkendte kunden CA$812,02.
Samme princip gælder for assistenter, som dine medarbejdere bruger. I Mata v. Avianca (2023) pålagde en amerikansk domstol to advokater og deres firma at betale en fælles bøde på 5.000 $, efter at de havde indleveret domme, som ChatGPT havde opfundet, og fortsat stod ved dem, da de blev spurgt. Retten sagde, at der er “intet i sig selv forkert” ved at bruge et pålideligt AI-værktøj, men at den, der indleverer, beholder en “rolle som portvogter” for nøjagtigheden. Når nogen sender et forkert svar fra en intern assistent videre til en kunde, vil kunden sandsynligvis læse det som jeres virksomheds svar.
Sådan finder du ud af, hvilken årsag der gælder hos jer
For at finde årsagen til, at din AI giver forkerte svar, samler du et sæt rigtige spørgsmål og tjekker hvert svar mod det, du ved er sandt. Du behøver ingen betalte værktøjer, kun assistenten, dine dokumenter og adgang til dens samtalehistorik. Tilsammen viser de forkerte svar, hvilket hul du skal lukke først.
- Skriv rigtige spørgsmål ned. Tag dem fra nylige chats, mails og opkald, med kundernes egne ord. Tilføj spørgsmål, som dine dokumenter ikke besvarer, og et par, der ligger uden for assistentens opgave.
- Skriv det rigtige svar ud for hvert spørgsmål. For spørgsmål uden svar i materialet er det rigtige svar “det ved jeg ikke, jeg sender dig videre til en kollega”.
- Stil assistenten alle spørgsmålene, og stil nogle af dem igen med andre ord. Hvis fakta i et svar ændrer sig fra gang til gang, gætter assistenten sandsynligvis.
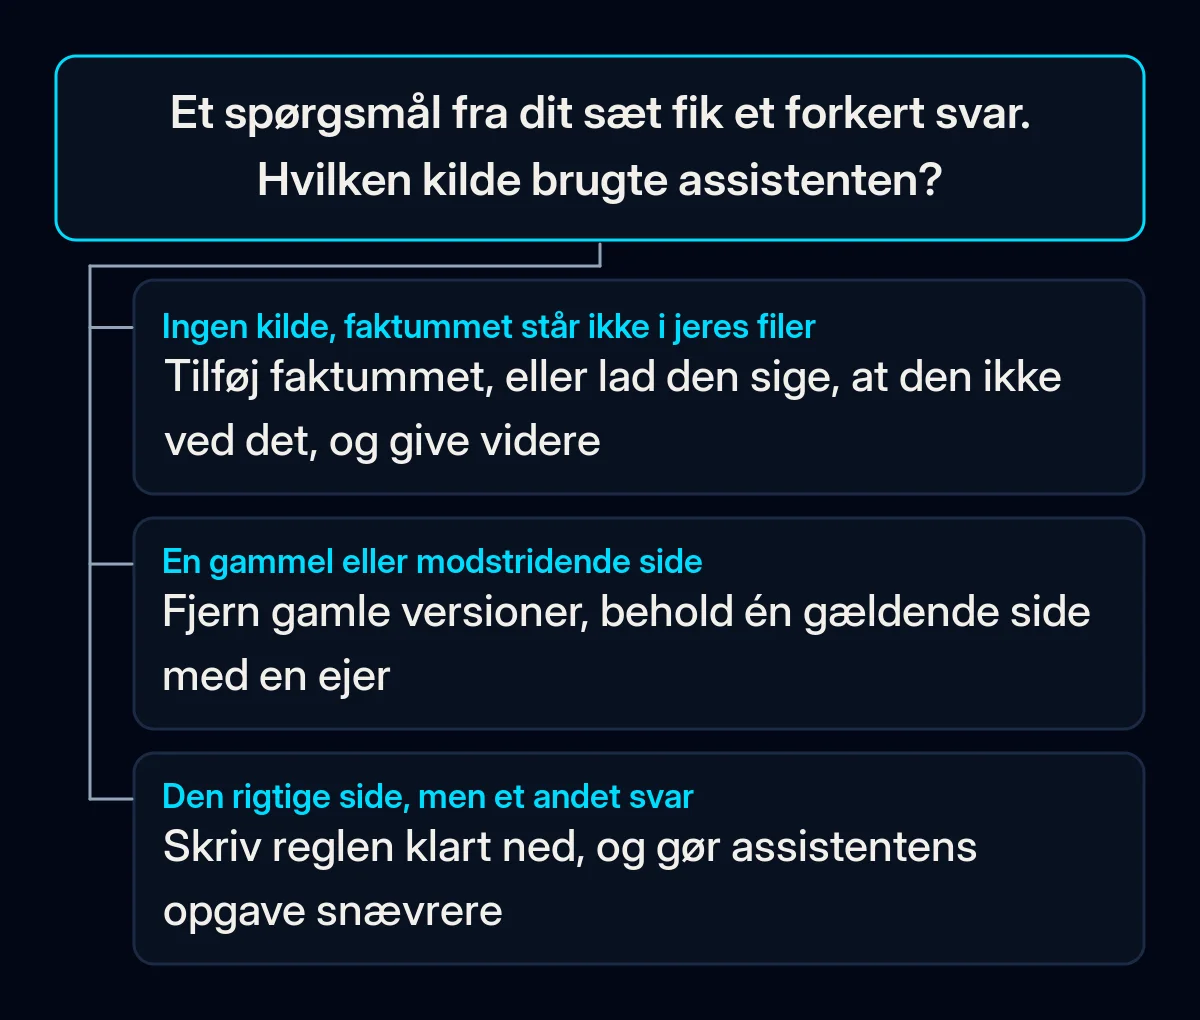
- Se for hvert forkert svar på, hvad den brugte. Mange vidensassistenter kan vise kildeteksten eller logge, hvilke dokumenter de hentede; tjek, om din kan. Notér, om der ingen kilde var, om kilden var gammel eller modstridende, eller om den rigtige kilde blev læst forkert.
- Sortér de forkerte svar efter årsag. Intet dokument, forkert eller forældet dokument, uskreven regel, uden for opgaven eller en sag, der alligevel krævede et menneske. Den største gruppe er stedet at begynde.
Gem sættet, og kør det efter hver ændring. Barnett-artiklen bemærker, at validering af et sådant system “kun er mulig under drift”, så tilføj de nye spørgsmål, folk stiller efter lanceringen.
Hvordan får du en AI-assistent til at holde op med at finde på?
Begynd med de billigste rettelser: Lad assistenten sige “det ved jeg ikke” og give samtalen videre til et menneske, lad den kun svare ud fra dine dokumenter med en synlig kilde, og hold dokumenterne opdateret. Derefter kommer nedskrevne regler, en snævrere opgave, mærkning som AI og faste gentests. Kør dit spørgsmålssæt igen efter hver ændring, så du kan se, hvilken der hjalp.
-
Lad den sige “det ved jeg ikke” og give videre. Ret instruktionerne, så assistenten siger det, når dokumenterne ikke indeholder svaret, og giver samtalen videre til et menneske sammen med kundens spørgsmål og kontaktoplysninger. OpenAIs forskere siger det samme fra den anden side: Modeller “kan afstå fra at svare, når de er usikre”. En overdragelse hjælper kun, hvis nogen tager den; vores artikel om, hvorvidt en AI-chatbot skal svare dine kunder, gennemgår, hvor overdragelserne skal lande.
-
Lad den kun svare ud fra dine dokumenter, og vis kilden. Opsætningen kaldes ofte retrieval-augmented generation, eller RAG: Assistenten søger først i dit materiale og svarer derefter ud fra de tekststykker, den fandt. Anthropics vejledning er at begrænse modellen til “oplysninger fra de leverede dokumenter og ikke sin generelle viden”. En synlig kilde under hvert svar gør det muligt for kunder og medarbejdere at tjekke det og for dig at se, hvilken side der forårsagede en fejl. I vores projekter med implementering af AI svarer en vidensassistent med et link til kilden, så et forkert svar kan spores til siden bag det. Regn med nogle fejl alligevel: Forskere fra Stanford, der testede AI-værktøjer til juridisk research, fandt, at “selv RAG-systemer ikke er fri for hallucinationer”.
-
Ryd op i det materiale, den læser. Én gældende version af hver politik, prisliste og kontraktskabelon; gamle versioner ud af mappen; hvert dokument med en navngiven ejer, der opdaterer det, når reglen ændres. Svarer assistenten ud fra jeres CRM, gælder det samme for posterne dér, som vi har beskrevet i vores artikel om datakvalitet i CRM.
-
Skriv de regler ned, den bliver ved med at opfinde. Betingelser for refusion, løfter om levering, rabatter, hvad der tæller som en klage. Hvor der står meget på spil, så giv assistenten en fast formulering, eller gør emnet til et, hvor et menneske bekræfter svaret, før det sendes.
-
Gør dens opgave snævrere. Skriv op, hvad den svarer på, og hvad den høfligt afviser. Spørgsmål uden for listen får et kort afslag og, hvor det giver mening, en overdragelse.
-
Fortæl folk, at de taler med en AI. I EU kræver forordningen om kunstig intelligens, at folk får at vide, at de interagerer med et AI-system, medmindre det er indlysende, og senest ved den første interaktion. Pligten ligger hos systemets udbyder og har gældt siden 2. august 2026. Mærkning af AI-svar afstemmer også forventningerne: Efter at Cursors supportbot i 2025 havde opfundet en brugspolitik, begyndte Cursor at mærke AI-svar i sin mailsupport. I de websiteprojekter, hvor vi tilføjer en assistent, er besked til de besøgende om, at de taler med en AI, en del af siden fra starten.
-
Test igen efter hver ændring. Nye dokumenter, redigerede instruktioner og modelopdateringer fra leverandøren kan alle ændre svarene på spørgsmål, der plejede at virke. Kør spørgsmålssættet efter hver af dem og før en travl sæson.
Hvad stopper ikke AI hallucinationer alene?
Tre rettelser bliver ofte prøvet først: en linje, der beder modellen om ikke at hallucinere, en temperatur på 0 og finjustering på jeres egne tekster. Hver af dem ændrer kun én del af assistenten. De fakta, den mangler, og lov til at sige “det ved jeg ikke” kommer fra dens dokumenter og instruktioner, så hvis de forkerte svar fortsætter efter disse rettelser, så tjek dem først.
| Det, folk prøver | Det, det ændrer | Det, der forbliver det samme |
|---|---|---|
| En linje med “hallucinér ikke” i instruktionerne | Hvordan forespørgslen til modellen er formuleret | Uden lov til at sige “det ved jeg ikke” må modellen stadig give et svar |
| Temperaturen sænket til 0 | Hvor meget formuleringen varierer fra kørsel til kørsel; Anthropic bemærker, at selv ved 0 “vil resultaterne ikke være fuldt deterministiske” | De dokumenter, assistenten læser, og de fakta, der mangler i dem |
| Finjustering (videretræning) af en model på jeres egne tekster | Efter vores vurdering primært, hvordan modellen skriver og opfører sig | Priser og vilkår, der ændrer sig, og som hører hjemme i dokumenter, den læser, når den svarer |
Hvordan ved du, at de forkerte svar bliver sjældnere?
Følg nogle få tal fra spørgsmålssættet og fra rigtige samtaler, og begynd før din første rettelse, så du har noget at sammenligne med. Tjek dem efter hver ændring og derefter med faste mellemrum, når assistenten har fundet sit leje, og læs selve de forkerte svar ved siden af totalerne.
- Rigtige svar på dit spørgsmålssæt, inklusive spørgsmålene, hvor det rigtige svar er “det ved jeg ikke”.
- Forkerte svar pr. uge efter årsag, ud fra læsning af rigtige samtaler. En årsag, der bliver ved med at vende tilbage, er den næste rettelse.
- Overdragelser, som et menneske tog, og hvor længe der blev ventet. En overdragelse, som ingen besvarer, ender ofte med, at kunden alligevel går.
- Svar, der viser en kilde. Vokser andelen af svar uden kilde, så tjek, om dokumenterne stadig dækker de spørgsmål, folk stiller.
Her kommer vi ind
Vi begynder med dine spørgsmål og dokumenter: spørgsmålssættet, de rigtige svar og de kilder, assistenten skal bruge. Derefter sætter vi assistenten op til at svare ud fra det materiale med en synlig kilde og med et menneske, der godkender svarene, hvor det betyder noget. Vi bliver ved med at tjekke den mod spørgsmålssættet som en del af de faste kvalitetstjek. Giver en af dine assistenter allerede forkerte svar, er en brief den nemmeste måde at vise os hvor.