Клиент пересылает вам переписку: ассистент на вашем сайте сказал ему, что возврат бесплатный в течение шестидесяти дней, хотя по вашим правилам срок тридцать дней. Или коллега цитирует пункт договора, который “нашёл” внутренний ассистент, а в самом договоре этого пункта никто найти не может. Оба случая это галлюцинации ИИ: модель уверенно выдаёт неверный ответ. Коротко: полностью отключить такие ошибки нельзя, но обычно можно понять, какого они рода, и сделать уверенные неверные ответы редкими, заметными и передаваемыми человеку.
Обычно реагируют так: винят модель, дописывают в инструкции “ничего не выдумывай” или отключают ассистента. Часто причина приземлённее: ассистента спросили о том, на что в его материалах нет ответа, он прочитал не ту страницу или никто не сказал ему, что “я не знаю” это допустимый ответ. Каждая из этих причин оставляет след, который можно проверить самостоятельно.
Почему возникают галлюцинации ИИ?
Языковая модель пишет самые правдоподобные следующие слова. Когда нужный факт у неё перед глазами, правдоподобный ответ обычно и есть правильный. Когда факта нет, она всё равно пишет что-то гладкое, и NIST называет это конфабуляцией: “уверенно изложенное, но ошибочное или ложное содержание”, в обиходе галлюцинации.
Исследователи OpenAI объясняют, откуда уверенность: стандартное обучение и оценка “поощряют угадывание, а не признание неуверенности”. Справочный центр компании добавляет, что “уверенность не равна надёжности”: гладкий и уверенный ответ всё равно может быть неверным. В бизнес-ассистенте эта общая привычка проявляется через несколько конкретных пробелов.
Ответа нет в его материалах. Клиент спрашивает об услуге, которую вы больше не оказываете, о стране, куда вы никогда не доставляли, или о скидке, которая нигде не записана. Исследование ассистентов, работающих по документам, которое провели Барнетт и соавторы, называет это первой точкой отказа: вопрос, “на который нельзя ответить по имеющимся документам”. Ассистент угадывает по общим знаниям, и так появляется правдоподобный, но выдуманный срок возврата.
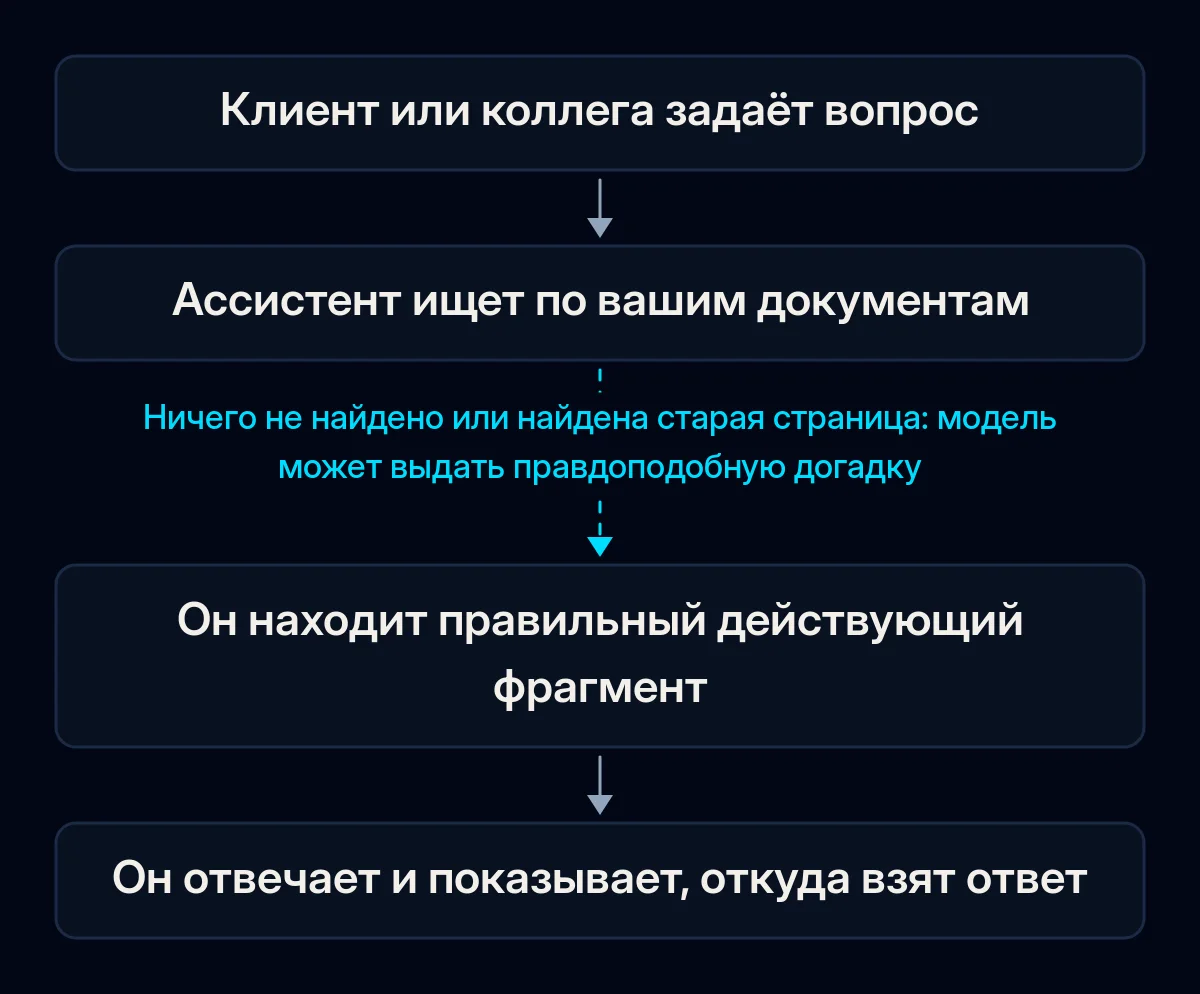
Он нашёл не ту страницу. Ассистент сначала ищет по вашим документам и отвечает по найденному, поэтому если прошлогодний прайс-лист, черновик правил и действующие правила лежат в одной папке, он может процитировать любой из них. Руководство Microsoft по сверке ответов с источниками исходит из того же: сами источники должны быть “точными и актуальными”. Эту причину вы узнаете, когда неверный ответ окажется правдой где-то в ваших файлах, только устаревшей.
Правило существует только в чьей-то голове. Ваша команда знает, что возвраты выше определённой суммы согласует руководитель или что в декабре вы не обещаете сроки доставки. Если ни в одном документе, который читает ассистент, этого правила нет, он заполняет пробел собственным правилом, которое звучит разумно.
Вопрос не входит в его задачи. Ассистента, настроенного на часы работы и бронирования, просят о юридической, медицинской или ценовой консультации. Без указания отказывать он пытается помочь.
Ничто не разрешает ему сказать “я не знаю”. Инструкции вроде “всегда помогай клиенту” могут подталкивать модель отвечать, даже когда отвечать ей не из чего. В документации Anthropic сказано, что прямое разрешение модели признавать неуверенность “может резко сократить количество ложной информации”.
Эти пробелы лежат на одном пути от вопроса к ответу, и ответ ломается на первом шаге, который не сработал.
Кто отвечает за то, что говорит ассистент?
В одном известном деле отвечал бизнес. В деле Moffatt v. Air Canada (2024) чат-бот авиакомпании подсказал клиенту, что льготный тариф в связи с утратой близкого можно оформить задним числом, хотя правила авиакомпании этого не допускали. Трибунал Британской Колумбии постановил: “Нет никакой разницы, поступает ли информация со статичной страницы или от чат-бота”. Он признал, что авиакомпания “не проявила разумной осмотрительности, чтобы обеспечить точность своего чат-бота”, и присудил клиенту 812,02 канадского доллара.
Тот же принцип действует для ассистентов, которыми пользуются ваши сотрудники. В деле Mata v. Avianca (2023) суд США обязал двух юристов и их фирму солидарно выплатить штраф 5000 долларов после того, как они подали в суд судебные решения, выдуманные ChatGPT, и продолжали настаивать на них, когда их об этом спросили. Суд указал, что в использовании надёжного ИИ-инструмента “нет ничего изначально неправомерного”, но за тем, кто подаёт документы, остаётся “роль привратника”, отвечающего за точность. Когда кто-то пересылает клиенту неверный ответ внутреннего ассистента, клиент, скорее всего, воспримет его как ответ вашей компании.
Как понять, какая причина у вас
Чтобы найти причину неверных ответов ИИ, соберите набор реальных вопросов и сверьте каждый ответ с тем, что вы точно знаете. Платные инструменты не нужны: только ассистент, ваши документы и доступ к истории его разговоров. Вместе неверные ответы покажут, какой пробел закрывать первым.
- Выпишите реальные вопросы. Возьмите их из недавних чатов, писем и звонков, словами самих клиентов. Добавьте вопросы, на которые ваши документы не отвечают, и несколько вопросов вне задач ассистента.
- Рядом с каждым запишите правильный ответ. Для вопросов, ответа на которые нет в ваших материалах, правильный ответ: “Я не знаю, сейчас передам вас коллеге”.
- Задайте ассистенту каждый вопрос, а потом некоторые повторите другими словами. Если факты в ответе меняются от запуска к запуску, ассистент, вероятно, их угадывает.
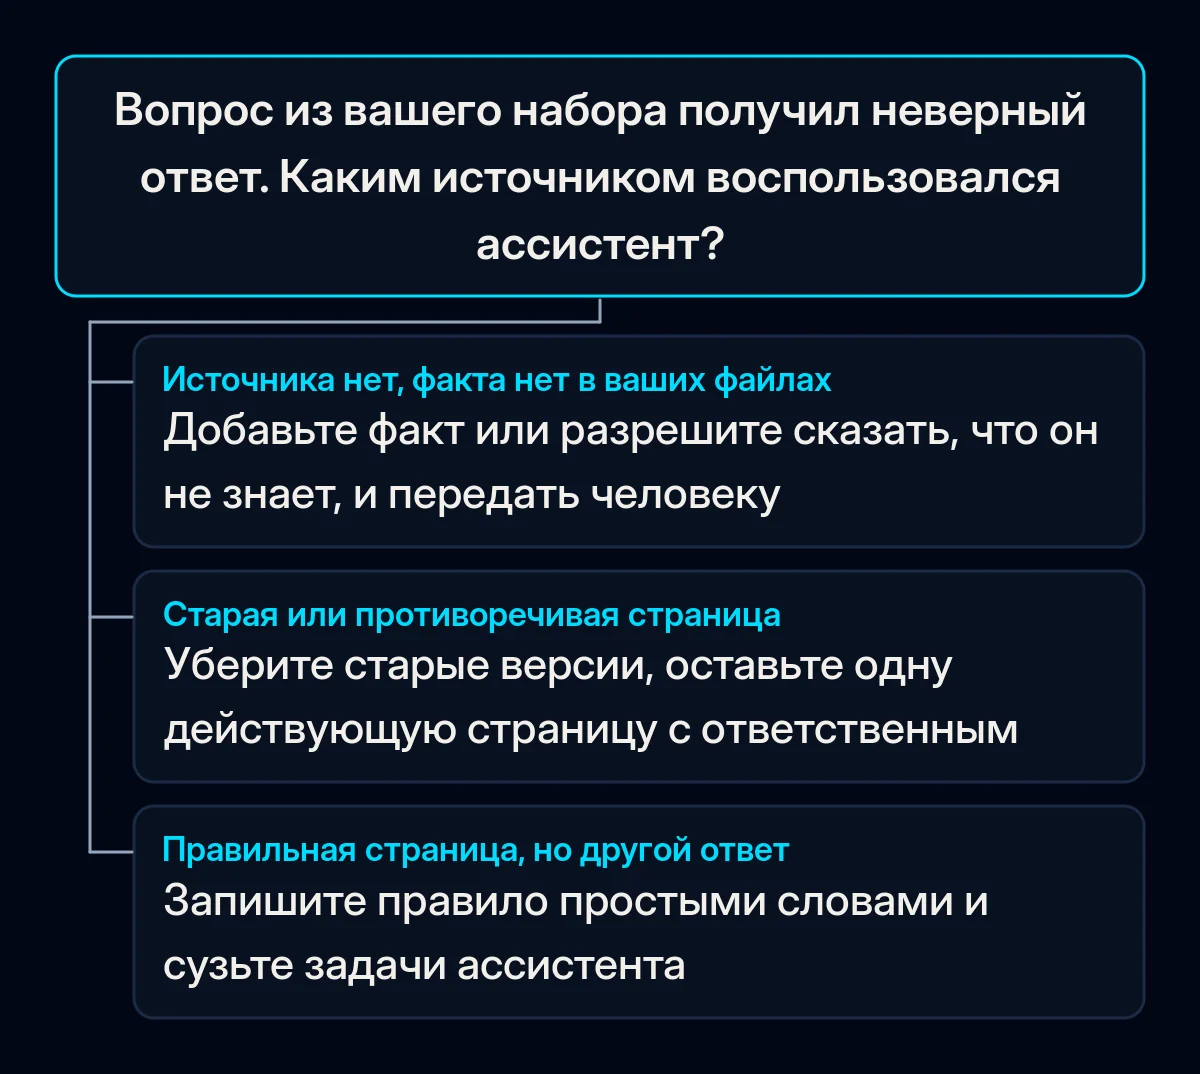
- Для каждого неверного ответа посмотрите, чем ассистент пользовался. Многие ассистенты по базе знаний умеют показывать исходный фрагмент или записывают в журнал, какие документы они нашли; проверьте, умеет ли ваш. Отметьте, источника не было, источник был старым или противоречивым или источник был правильный, но ассистент его неверно прочитал.
- Разложите неверные ответы по причинам. Нет документа, не тот или устаревший документ, незаписанное правило, вопрос вне задач или случай, который в любом случае требовал человека. Начинайте с самой большой группы.
Сохраните этот набор и прогоняйте его после каждого изменения. В статье Барнетта отмечено, что проверка такой системы “возможна только в ходе эксплуатации”, поэтому добавляйте новые вопросы, которые люди задают после запуска.
Как отучить ИИ-ассистента выдумывать?
Начните с самых дешёвых исправлений: разрешите ассистенту говорить “я не знаю” и передавать разговор человеку, заставьте его отвечать только по вашим документам с видимым источником и держите эти документы актуальными. Дальше идут запись правил, сужение задач, пометка, что это ИИ, и регулярные повторные проверки. Прогоняйте набор вопросов после каждого изменения, чтобы видеть, какое из них помогло.
-
Разрешите говорить “я не знаю” и передавать разговор. Измените инструкции так, чтобы, когда в документах нет ответа, ассистент так и говорил и передавал разговор человеку вместе с вопросом клиента и его контактами. Исследователи OpenAI говорят о том же с другой стороны: модели “могут воздерживаться от ответа, когда не уверены”. Передача помогает, только если её кто-то подхватывает; о том, куда должны попадать такие передачи, мы писали в статье о том, стоит ли доверять ИИ-чат-боту ответы клиентам.
-
Заставьте его отвечать только по вашим документам и показывать источник. Такую схему часто называют генерацией с дополненным поиском, или RAG: ассистент сначала ищет по вашим материалам, а потом отвечает по найденным фрагментам. Anthropic советует ограничить модель “информацией из предоставленных документов, а не её общими знаниями”. Видимый источник под каждым ответом позволяет клиентам и сотрудникам его проверить, а вам увидеть, какая страница стала причиной ошибки. В наших проектах по внедрению ИИ ассистент по базе знаний отвечает со ссылкой на источник, так что неверный ответ можно проследить до страницы, на которой он основан. Ошибки возможны и тогда: исследователи Стэнфорда, проверявшие ИИ-инструменты для юридических исследований, обнаружили, что “даже RAG-системы не свободны от галлюцинаций”.
-
Наведите порядок в материалах, которые он читает. Одна действующая версия каждого регламента, прайс-листа и шаблона договора; старые версии убраны из папки; у каждого документа есть ответственный, который обновляет его, когда правило меняется. Если ассистент отвечает по вашей CRM, то же касается записей в ней, об этом наша статья о качестве данных в CRM.
-
Запишите правила, которые он постоянно выдумывает. Условия возврата, обещания по доставке, скидки, что считается жалобой. Где ставки высоки, дайте ассистенту готовую формулировку или сделайте тему такой, где человек подтверждает ответ, прежде чем он уйдёт клиенту.
-
Сузьте его задачи. Перечислите, на что он отвечает и от чего вежливо отказывается. На вопросы вне списка он коротко отказывает и, где это полезно, передаёт разговор человеку.
-
Сообщайте людям, что они общаются с ИИ. В ЕС Регламент об искусственном интеллекте (AI Act) требует сообщать людям, что они взаимодействуют с системой ИИ, если это не очевидно, не позднее первого взаимодействия. Обязанность лежит на поставщике системы и действует с 2 августа 2026 г. Пометка ответов ИИ ещё и настраивает ожидания: после того как в 2025 году её бот поддержки выдумал правило использования, компания Cursor начала помечать ответы ИИ в поддержке по электронной почте. В проектах по разработке сайтов, куда мы добавляем ассистента, сообщение посетителям, что они общаются с ИИ, с самого начала входит в страницу.
-
Проверяйте заново после каждого изменения. Новые документы, отредактированные инструкции и обновления модели у поставщика могут изменить ответы на вопросы, с которыми раньше всё было в порядке. Прогоняйте набор вопросов после каждого такого изменения и перед горячим сезоном.
Что само по себе не спасает от выдумок?
Первыми часто пробуют три исправления: строку с запретом галлюцинировать, температуру 0 и дообучение на ваших текстах. Каждое меняет только одну часть ассистента. Недостающие факты и разрешение сказать “я не знаю” берутся из документов и инструкций, поэтому если неверные ответы продолжаются после этих исправлений, проверьте сначала их.
| Что пробуют | Что это меняет | Что остаётся прежним |
|---|---|---|
| Строка “не галлюцинируй” в инструкциях | Как сформулирован запрос к модели | Без разрешения сказать “я не знаю” модель всё равно обязана выдать ответ |
| Снижение температуры до 0 | Насколько формулировки меняются от запуска к запуску; Anthropic отмечает, что даже при 0 “результаты не будут полностью детерминированными” | Документы, которые читает ассистент, и факты, которых в них нет |
| Дообучение модели на ваших текстах | По нашему мнению, в основном то, как модель пишет и ведёт себя | Меняющиеся цены и условия, которым место в документах, читаемых в момент ответа |
Как понять, что неверных ответов становится меньше?
Отслеживайте несколько показателей по набору вопросов и по реальным разговорам, начав до первого исправления, чтобы было с чем сравнивать. Проверяйте их после каждого изменения, а когда ассистент стабилизируется, по регулярному графику, и читайте сами неверные ответы, а не только итоговые цифры.
- Правильные ответы на ваш набор вопросов, включая вопросы, где правильный ответ “я не знаю”.
- Неверные ответы в неделю по причинам, по результатам чтения реальных разговоров. Причина, которая возвращается снова и снова, и есть следующее исправление.
- Передачи, которые подхватил человек, и сколько клиент ждал. Передача, на которую никто не ответил, часто всё равно заканчивается уходом клиента.
- Ответы с указанием источника. Если доля ответов без источника растёт, проверьте, покрывают ли документы вопросы, которые задают люди.
Чем можем помочь мы
Мы начинаем с ваших вопросов и документов: набор вопросов, правильные ответы и источники, которыми должен пользоваться ассистент. Затем настраиваем ассистента так, чтобы он отвечал по этим материалам с видимым источником, а там, где это важно, ответы одобрял человек. Дальше мы продолжаем сверять его с набором вопросов в рамках регулярного контроля качества. Если ваш ассистент уже даёт неверные ответы, бриф самый простой способ показать нам, где именно.