En kund vidarebefordrar en chatt till dig: assistenten på din webbplats sa att returer är gratis i sextio dagar, medan era villkor säger trettio. Eller så citerar en kollega en avtalsklausul som den interna assistenten “hittade”, och ingen kan hitta den i avtalet. Båda är fall där AI ger fel svar. Det korta svaret: du kan inte stänga av felen helt, men du kan oftast ta reda på vilken sorts fel det är och se till att självsäkra felaktiga svar blir sällsynta, synliga och lämnas över till en människa.
De vanliga reaktionerna är att skylla på modellen, lägga till “hitta inte på” i instruktionerna eller stänga av assistenten. Ofta är orsaken mer vardaglig: assistenten fick en fråga som dess material inte besvarar, den läste fel sida, eller ingen talade om för den att “jag vet inte” är ett godtagbart svar. Var och en av de här orsakerna lämnar spår som du kan kontrollera själv.
Varför AI ger fel svar i ditt företag
En språkmodell skriver de mest sannolika nästa orden. När den har faktumet framför sig är det sannolika svaret oftast det rätta. När den inte har det skriver den ändå något som flyter, och NIST kallar detta konfabulering: “självsäkert framfört men felaktigt eller falskt innehåll”, i vardagligt tal kallat hallucinationer.
OpenAI:s forskare förklarar självsäkerheten: standardträning och utvärdering “belönar gissningar framför att erkänna osäkerhet”. Företagets hjälpcenter tillägger att “självsäkerhet är inte tillförlitlighet”: ett flytande, säkert svar kan ändå vara fel. I en företagsassistent visar sig den allmänna vanan genom några konkreta luckor.
Svaret finns inte i dess material. En kund frågar om en tjänst ni har slutat erbjuda, ett land ni aldrig har skickat till eller en rabatt som aldrig skrevs ner. En studie av dokumentbaserade assistenter av Barnett och kollegor anger detta som den första felpunkten: en fråga “som inte kan besvaras utifrån de tillgängliga dokumenten”. Assistenten gissar utifrån sin allmänna kunskap, och det är så en trovärdig men påhittad returtid uppstår.
Den hittade fel sida. Assistenten söker först i dina dokument och svarar utifrån det den hittar, så om fjolårets prislista, ett utkast till policy och den aktuella ligger i samma mapp kan den citera vilken som helst av dem. Microsofts vägledning om att kontrollera svar mot källor utgår från samma sak: källorna själva måste vara “korrekta och aktuella”. Du känner igen den här orsaken när det felaktiga svaret visar sig stämma någonstans i dina filer, bara inaktuellt.
Regeln finns bara i någons huvud. Ditt team vet att återbetalningar över ett visst belopp kräver en chef, eller att ni inte lovar leveransdatum i december. När inget som assistenten läser innehåller den regeln fyller den luckan med en egen, rimligt klingande policy.
Frågan ligger utanför dess uppdrag. En assistent som är inställd på öppettider och bokningar får en fråga om juridisk, medicinsk eller prisrådgivning. Utan instruktion att avböja försöker den hjälpa till.
Inget tillåter den att säga “jag vet inte”. Instruktioner som “hjälp alltid kunden” kan driva modellen att svara även när den inte har något att svara utifrån. Anthropics dokumentation säger att om man uttryckligen tillåter modellen att erkänna osäkerhet “kan det drastiskt minska falsk information”.
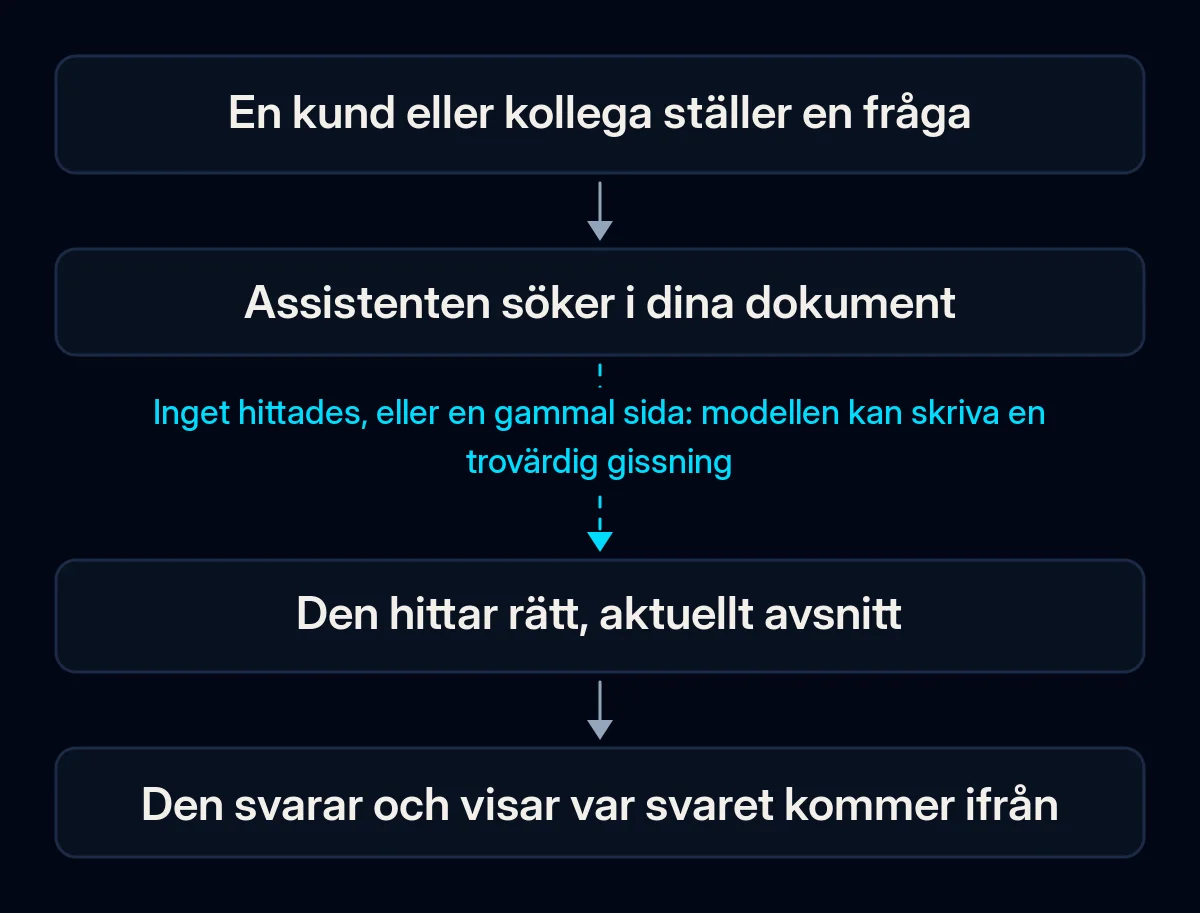
De här luckorna ligger längs en och samma väg från fråga till svar, och svaret blir fel vid det första steget som brister.
Vem ansvarar för det assistenten säger?
Företaget, i ett välkänt fall. I Moffatt v. Air Canada (2024) antydde flygbolagets chattbot att en kund kunde ansöka om ett särskilt pris vid dödsfall i familjen i efterhand, vilket flygbolagets policy inte tillät. Tribunalen i British Columbia fann att “det spelar ingen roll om informationen kommer från en statisk sida eller en chattbot”. Den slog fast att flygbolaget “inte iakttog rimlig omsorg för att säkerställa att dess chattbot var korrekt”, och tilldömde kunden 812,02 CA$.
Samma princip gäller assistenter som din personal använder. I Mata v. Avianca (2023) ålade en amerikansk domstol två advokater och deras byrå att gemensamt betala en sanktionsavgift på 5 000 dollar efter att de lämnat in domstolsavgöranden som ChatGPT hade hittat på och fortsatt att stå fast vid dem när de ifrågasattes. Domstolen sa att det inte finns “något i sig olämpligt” i att använda ett tillförlitligt AI-verktyg, men att den som lämnar in handlingen behåller en “grindvaktsroll” för korrektheten. När någon vidarebefordrar en intern assistents felaktiga svar till en kund kommer kunden sannolikt att läsa det som ditt företags svar.
Så tar du reda på vilken orsak som gäller dig
För att hitta orsaken till att AI ger fel svar samlar du ihop en uppsättning riktiga frågor och kontrollerar varje svar mot det du vet är sant. Du behöver inga betalverktyg, bara assistenten, dina dokument och tillgång till dess konversationshistorik. Tillsammans visar de felaktiga svaren vilken lucka du ska täppa till först.
- Skriv ner riktiga frågor. Ta dem från de senaste chattarna, mejlen och samtalen, med kundernas egna ord. Lägg till frågor som dina dokument inte besvarar och några som ligger utanför assistentens uppdrag.
- Skriv det rätta svaret bredvid varje fråga. För frågorna utan svar i ert material är det rätta svaret “jag vet inte, jag kopplar dig till en kollega”.
- Ställ varje fråga till assistenten och ställ sedan några igen med andra ord. Om fakta i ett svar ändras mellan körningarna gissar assistenten troligen.
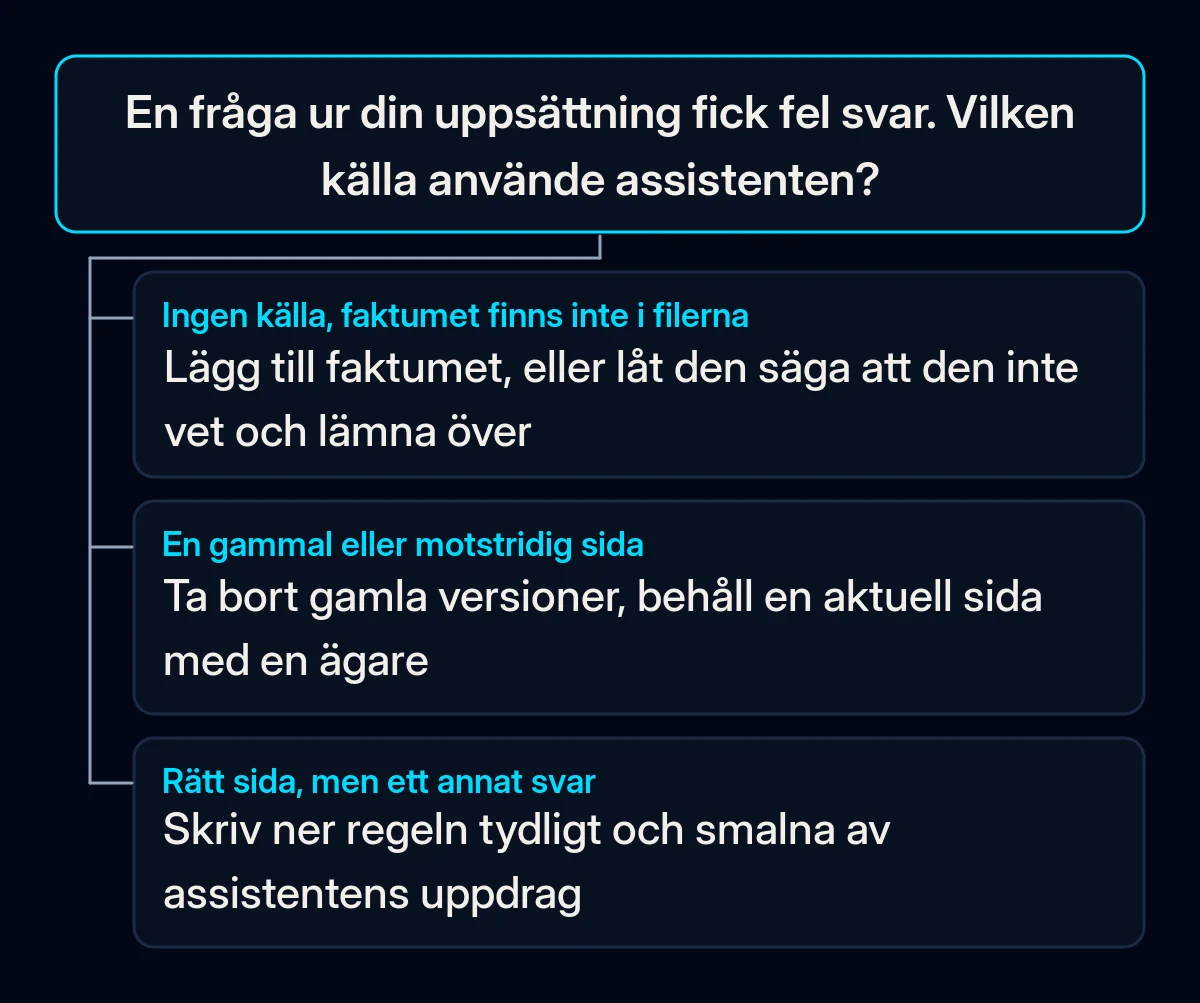
- Titta på vad den använde för varje felaktigt svar. Många kunskapsassistenter kan visa källavsnittet eller loggar vilka dokument de hämtade; kontrollera om din gör det. Notera om det saknades källa, om källan var gammal eller motstridig, eller om det var rätt källa som den läste fel.
- Sortera de felaktiga svaren efter orsak. Inget dokument, fel eller inaktuellt dokument, oskriven regel, utanför uppdraget eller ett ärende som ändå behövde en människa. Den största gruppen är där du börjar.
Spara uppsättningen och kör den efter varje ändring. Barnetts studie konstaterar att validering av ett sådant system “bara är möjlig under drift”, så lägg till de nya frågor som folk ställer efter lanseringen.
Hur får du en AI-assistent att sluta hitta på?
Börja med de billigaste åtgärderna: låt assistenten säga “jag vet inte” och lämna över samtalet till en människa, låt den bara svara utifrån dina dokument med synlig källa och håll dokumenten aktuella. Därefter kommer nedskrivna regler, ett smalare uppdrag, märkning som AI och regelbundna omtester. Kör frågeuppsättningen igen efter varje ändring, så ser du vilken som hjälpte.
-
Låt den säga “jag vet inte” och lämna över. Ändra instruktionerna så att assistenten, när dokumenten inte innehåller svaret, säger det och lämnar över samtalet till en människa, med kundens fråga och kontaktuppgifter bifogade. OpenAI:s forskare säger samma sak från andra hållet: modeller “kan avstå när de är osäkra”. En överlämning hjälper bara om någon tar emot den; vår artikel om huruvida en AI-chattbot ska svara dina kunder tar upp var de överlämningarna ska hamna.
-
Låt den bara svara utifrån dina dokument och visa källan. Det här upplägget kallas ofta hämtningsförstärkt generering, eller RAG: assistenten söker först i ditt material och svarar sedan utifrån de avsnitt den hittade. Anthropics råd är att begränsa modellen till “information från tillhandahållna dokument och inte dess allmänna kunskap”. En synlig källa under varje svar låter kunder och personal kontrollera det och låter dig se vilken sida som orsakade ett fel. I våra projekt för AI-implementering svarar en kunskapsassistent med en länk till källan, så att ett felaktigt svar kan spåras till sidan bakom det. Räkna ändå med vissa fel: forskare vid Stanford som testade AI-verktyg för juridisk research fann att “inte ens RAG-system är fria från hallucinationer”.
-
Rensa materialet den läser. En aktuell version av varje policy, prislista och avtalsmall; gamla versioner ut ur mappen; varje dokument med en namngiven ägare som uppdaterar det när regeln ändras. Om assistenten svarar utifrån ert CRM gäller samma sak för posterna där, som vi gick igenom i vår artikel om datakvalitet i CRM.
-
Skriv ner reglerna den hela tiden hittar på. Villkor för återbetalning, leveranslöften, rabatter, vad som räknas som ett klagomål. Där insatserna är höga, ge assistenten en fast formulering att använda, eller gör ämnet till ett där en människa bekräftar svaret innan det skickas.
-
Smalna av dess uppdrag. Lista vad den svarar på och vad den artigt avböjer. Frågor utanför listan får ett kort nej och, där det är användbart, en överlämning.
-
Tala om för folk att de pratar med en AI. I EU kräver förordningen om artificiell intelligens att människor informeras om att de interagerar med ett AI-system, om det inte är uppenbart, senast vid den första interaktionen. Skyldigheten ligger hos systemets leverantör och gäller sedan den 2 augusti 2026. Att märka AI-svar sätter också förväntningar: efter att dess supportbot hittat på en användarpolicy 2025 började Cursor märka AI-svar i mejlsupporten. I de webbplatsprojekt där vi lägger till en assistent är informationen till besökarna om att de pratar med en AI en del av sidan från början.
-
Testa om efter varje ändring. Nya dokument, ändrade instruktioner och modelluppdateringar från leverantören kan alla ändra svar på frågor som tidigare fungerade. Kör frågeuppsättningen efter var och en av dem och före en intensiv säsong.
Vad stoppar inte AI-hallucinationer på egen hand?
Tre åtgärder prövas ofta först: en rad som säger åt modellen att inte hallucinera, temperatur 0 och finjustering på egna texter. Var och en ändrar bara en del av assistenten. De fakta den saknar och tillåtelsen att säga “jag vet inte” kommer från dess dokument och instruktioner, så om de felaktiga svaren fortsätter efter de här åtgärderna, kontrollera dem först.
| Vad folk provar | Vad det ändrar | Vad som förblir detsamma |
|---|---|---|
| En rad med “hallucinera inte” i instruktionerna | Hur förfrågan till modellen är formulerad | Utan tillåtelse att säga “jag vet inte” måste modellen ändå ge ett svar |
| Att sänka temperaturen till 0 | Hur mycket formuleringarna varierar mellan körningar; Anthropic påpekar att även vid 0 “kommer resultaten inte att vara helt deterministiska” | Dokumenten assistenten läser och de fakta som saknas i dem |
| Finjustering (vidareträning) av en modell på egna texter | Enligt oss främst hur modellen skriver och beter sig | Priser och villkor som ändras, och som hör hemma i dokument den läser när den svarar |
Hur vet du att de felaktiga svaren blir färre?
Följ några siffror från frågeuppsättningen och från riktiga konversationer, och börja innan den första åtgärden så att du har något att jämföra med. Kontrollera dem efter varje ändring och sedan enligt ett fast schema när assistenten har stabiliserats, och läs själva de felaktiga svaren vid sidan av summorna.
- Rätta svar på frågeuppsättningen, inklusive frågorna där rätt svar är “jag vet inte”.
- Felaktiga svar per vecka efter orsak, från genomläsning av riktiga konversationer. En orsak som återkommer är nästa åtgärd.
- Överlämningar som en människa tar emot, och hur länge de väntade. En överlämning som ingen svarar på slutar ofta med att kunden lämnar ändå.
- Svar som visar en källa. Om andelen svar utan källa växer, kontrollera om dokumenten fortfarande täcker de frågor folk ställer.
Där kommer vi in
Vi utgår från dina frågor och dokument: frågeuppsättningen, de rätta svaren och källorna som assistenten ska använda. Sedan ställer vi in assistenten så att den svarar utifrån det materialet med synlig källa och med en människa som godkänner svar där det spelar roll. Vi fortsätter att kontrollera den mot frågeuppsättningen som en del av regelbundna kvalitetskontroller. Om en av dina assistenter redan ger fel svar är en brief det enklaste sättet att visa oss var.