Vous avez activé les fonctions d’IA de votre CRM : résumés d’affaires, scoring des leads, prochaines actions suggérées, e-mails de relance prérédigés. Et le résultat sonne faux. Un résumé indique que le client a demandé un devis alors qu’il voulait être rappelé. Un lead classé « chaud » se révèle être un fournisseur. L’e-mail prérédigé salue la mauvaise personne. Quand on se met à chercher « qualité des données CRM », c’est en général après un moment comme celui-là : l’outil paraissait sûr de lui et il avait tort.
Les conclusions habituelles : l’IA n’est pas encore au point, le CRM était un mauvais choix, ou l’équipe ferait mieux de revenir aux tableurs. D’après notre expérience, le modèle est rarement en cause. Il travaille à partir de ce qui est écrit dans les fiches. Les trous dans ces fiches prennent quelques formes bien connues, et vous pouvez trouver les vôtres en une soirée.
Pourquoi une mauvaise qualité des données CRM trompe l’IA
Les champs vides sont remplis par des suppositions. Un résumé ou un score se construit à partir des champs et des notes de la fiche. Quand la source, l’étape, le dernier contact ou le motif de la demande sont vides, le modèle ne s’arrête pas pour demander. Il écrit la version la plus plausible. Le signe : l’IA est la plus fluide et la plus affirmative précisément sur les fiches où, vous le savez, presque rien n’a été saisi.
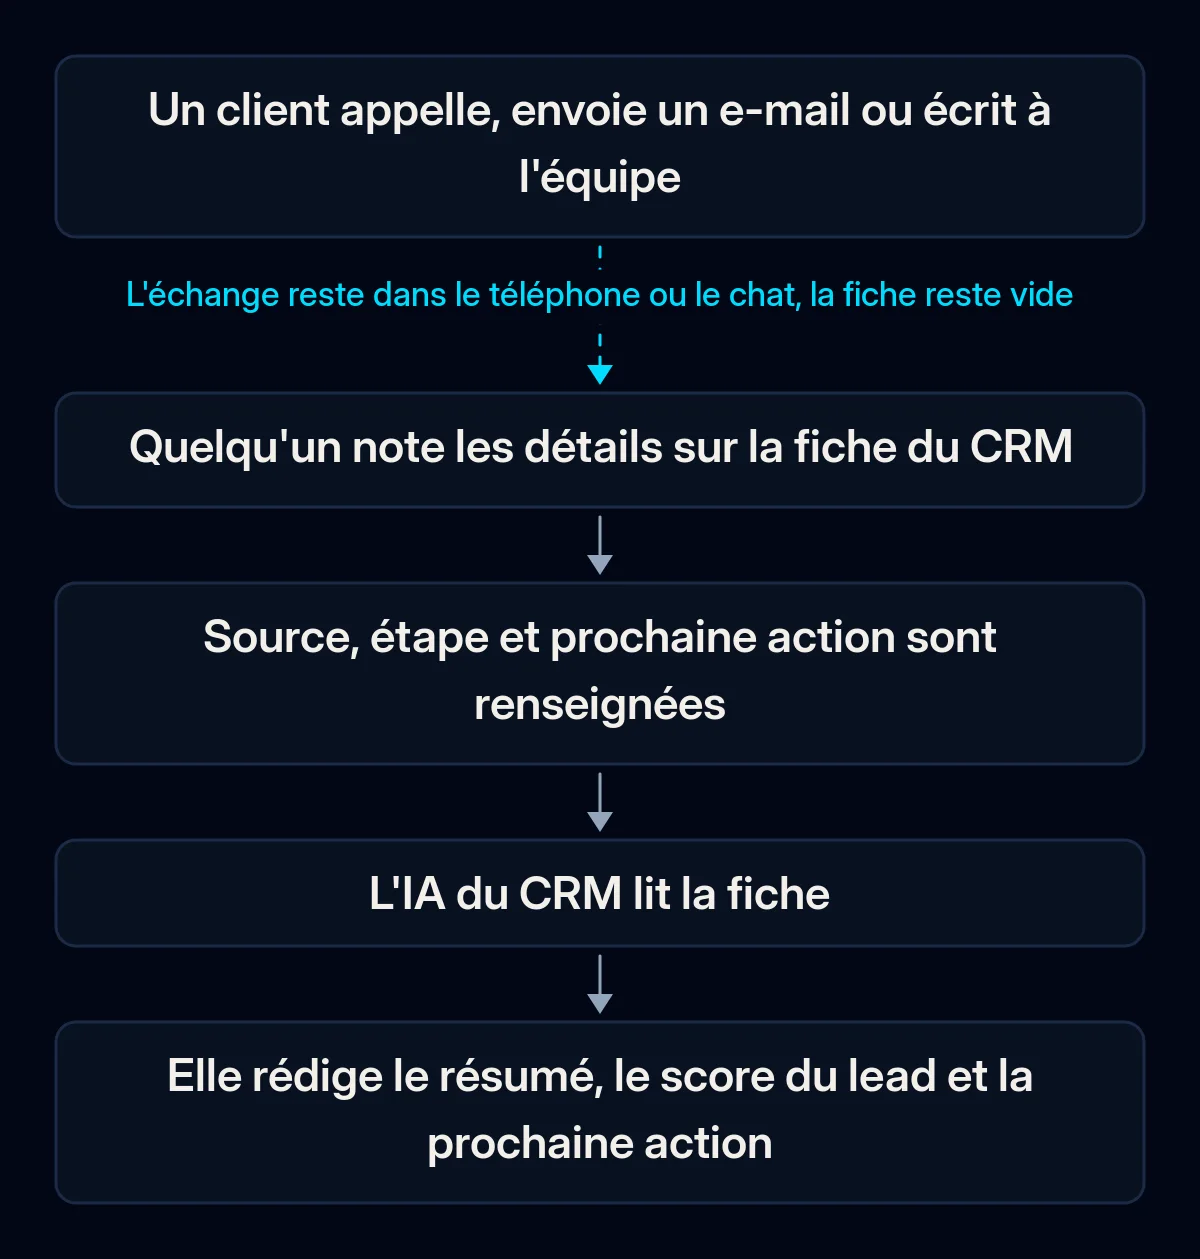
Le vrai échange a eu lieu ailleurs. Des appels passés depuis des portables personnels, des devis envoyés depuis la boîte mail de quelqu’un, des détails réglés sur une messagerie. Le CRM contient un nom et un numéro ; l’historique vit ailleurs. L’IA ne peut résumer que le peu qu’elle voit. Le signe : les résumés d’affaires sur lesquelles votre équipe travaille activement ressemblent à ceux de leads tout juste arrivés.
Les doublons éclatent un client en plusieurs. La même entreprise est saisie par deux personnes, une fois avec son nom complet, une fois avec un sigle ; la même personne apparaît avec une adresse pro et une adresse perso. Chaque fiche contient une partie de l’histoire, et l’IA n’en lit qu’une. Le signe : cherchez un client régulier par son nom, et plus d’une fiche remonte.
Chacun remplit les champs à sa manière. Un commercial note « site web » comme source, un autre « site », un troisième le nom de la régie publicitaire. Les étapes ne veulent pas dire la même chose pour tous : pour l’un, « proposition » signifie qu’un prix a été évoqué au téléphone ; pour l’autre, qu’une offre signée est partie. L’IA compare des fiches qui ne parlent pas de la même chose. Le signe : le scoring paraît aléatoire quand vous comparez les affaires d’un commercial avec celles d’un autre.
Les vieilles fiches ne sont jamais clôturées. Des affaires que personne n’a touchées depuis des mois restent ouvertes, des contacts partis de l’entreprise restent actifs. L’IA les considère comme vivants et propose de relancer. Le signe : des tâches suggérées pour des clients dont votre équipe sait qu’ils sont partis depuis longtemps.
Comment savoir ce qui vous concerne
Une soirée et un export de votre CRM suffisent ; aucun outil payant n’est nécessaire. Faites ces vérifications dans l’ordre. La première qui échoue indique en général par où commencer.
- Ouvrez dix fiches récentes où l’IA s’est trompée. Pour chaque affirmation fausse, notez de quel champ ou de quelle note elle provient, ou si elle ne vient de rien du tout.
- Exportez les affaires ouvertes et triez tour à tour par chaque champ clé. Source, étape, dernière activité, prochaine action. Les valeurs vides remontent en haut, et vous voyez tout de suite quels champs personne ne remplit.
- Comparez le CRM avec l’activité réelle sur une semaine. Prenez quelques affaires actives et regardez les appels et e-mails qui ont réellement eu lieu. Vérifiez si la fiche les mentionne.
- Cherchez vos meilleurs clients par leur nom. Tout client avec plus d’une fiche est un doublon à fusionner, et le signe que les nouvelles saisies ne sont pas vérifiées.
- Listez les valeurs distinctes des champs source et étape. Variantes d’orthographe et texte libre signifient que chacun tient son propre dictionnaire.
- Triez les affaires ouvertes par dernière activité. Tout ce qui n’a pas été touché depuis longtemps et reste marqué ouvert est une fiche que l’IA traite comme vivante.
La correction, dans l’ordre
Le moins coûteux d’abord. Les premières étapes demandent des décisions, pas un nouveau logiciel.
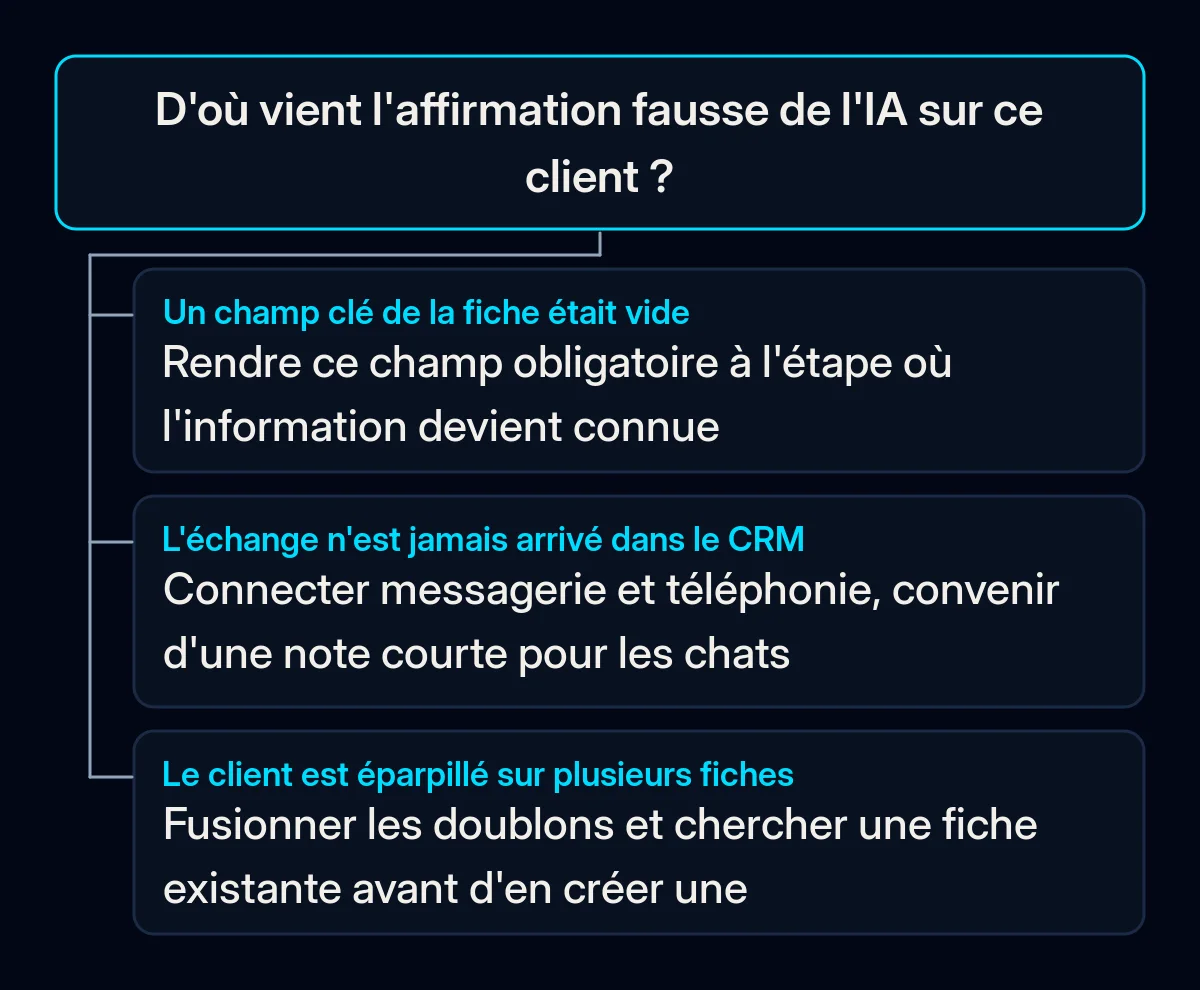
- Décidez quels champs comptent. Pas tous ceux que propose le CRM, seulement la poignée que votre équipe et les fonctions d’IA utilisent vraiment : source, étape, motif de la demande, dernier contact, prochaine action. Masquez le reste dans la vue principale pour que personne ne survole plus un mur de cases vides.
- Écrivez le dictionnaire sur une page. Ce que signifie chaque étape en des termes vérifiables par tous (« proposition » veut dire qu’une offre chiffrée a été envoyée), les valeurs de source autorisées, ce qui compte comme gagné et perdu. Transformez les champs en texte libre en listes déroulantes, pour que ce soit le formulaire qui fasse respecter le dictionnaire, pas la mémoire.
- Rendez les champs obligatoires au moment où l’information est connue. Pas tous à la création, sinon les gens tapent n’importe quoi pour passer le formulaire. La source à la création du lead, le motif après le premier échange, la prochaine action à chaque changement d’étape. Source et résultat saisis ainsi sont aussi ce qui permet aux campagnes de publicité payante d’apprendre des ventes réelles plutôt que des formulaires remplis.
- Nettoyez l’historique une fois, en une seule séance. Fusionnez les doublons, clôturez les affaires mortes avec un motif, archivez les contacts partis. Servez-vous de l’export de votre diagnostic au lieu d’en faire une tâche de fond. Les règles ne tiennent que si l’équipe continue d’utiliser l’outil ; notre guide quand l’équipe n’utilise pas le CRM explique comment l’ancrer dans le travail quotidien.
- Faites entrer les échanges dans le CRM. Connectez la messagerie et la téléphonie pour que e-mails et appels arrivent d’eux-mêmes sur la fiche, et convenez qu’une affaire discutée sur une messagerie reçoit une courte note. C’est souvent là que la mise en place et l’automatisation du CRM se rentabilisent : la fiche se remplit seule au lieu de dépendre de la discipline.
- Réactivez les fonctions d’IA une par une. D’abord les résumés, puis le scoring, puis les relances prérédigées, avec chaque semaine un coup d’œil sur un échantillon de ce que chacune a produit. Si votre CRM sait remplir les fiches à partir des e-mails et des appels, vérifiez ce qu’il a écrit avant de vous y fier. Dans nos projets d’intégration de l’IA, nous mettons en place cet ordre et ce contrôle hebdomadaire par échantillon avant qu’une fonction d’IA n’écrive à un client.
Ce qu’il faut mesurer
- Les affaires ouvertes dont tous les champs clés sont remplis, vérifiées chaque semaine à partir du même export ; c’est le signe le plus net que les règles tiennent.
- Les doublons trouvés en cherchant vos meilleurs clients, vérifiés chaque mois ; la liste doit raccourcir et rester courte.
- Les affirmations de l’IA corrigées dans l’échantillon hebdomadaire, notées avec le champ d’où elles viennent ; chacune pointe vers une règle ou une connexion qui manque encore.
- Les affaires ouvertes sans activité récente, passées en revue chaque mois ; quand cette liste reste courte, l’IA cesse de proposer des relances à des clients partis.
Où nous intervenons
Une équipe qui s’accorde sur ses champs, écrit son dictionnaire et nettoie l’historique une fois peut améliorer seule la qualité des données CRM, et cet ordre est pensé pour le rendre possible. Ce que nous apportons : une carte des champs et un dictionnaire construits autour de la façon dont vos ventes fonctionnent vraiment, les connexions qui remplissent les fiches sans saisie supplémentaire, et les contrôles qui gardent les fonctions d’IA honnêtes. Si vous voulez que nous regardions votre CRM avec vous, un court brief suffit pour commencer.